

在自己的專案裡,我已經知道架構和歷史,很容易不小心把答案提示給 AI。今天換一個合法可使用、能在本機執行測試的陌生 Repository,只提供 README、Issue 和驗收,觀察 Codex 像新加入的開發者一樣接手。
Repository 要有明確授權,任務範圍小而完整,測試能離線或在受控環境執行。起始 commit 固定,工作目錄乾淨,不提供我私下知道的檔名。Issue 不應需要正式憑證、真實使用者資料或對外部署,避免把權限問題混進理解能力比較。
任務包包含原始 README、Issue、重現步驟、成功條件和允許執行的測試。Prompt 要求先探索並說明計畫,再修改;完成後列出查閱的關鍵檔案、實際 diff、測試與未解決限制。若文件和程式不一致,以證據指出,不能默默猜測。
我會記錄第一次找到正確模組所花的步驟、讀取的相關與不相關檔案、修改輪次、測試通過率、額外變更和人工提示。最終結果還要由人類 Review,確認沒有只為通過單一測試而破壞其他行為。速度只是其中一欄。
如果 Codex 沒修完,失敗也要分類:無法建立環境、誤解需求、找錯資料流、修正不完整、測試不足或權限受限。不同原因代表不同改善方式;把所有失敗都歸成「AI 不懂大型專案」沒有分析價值。
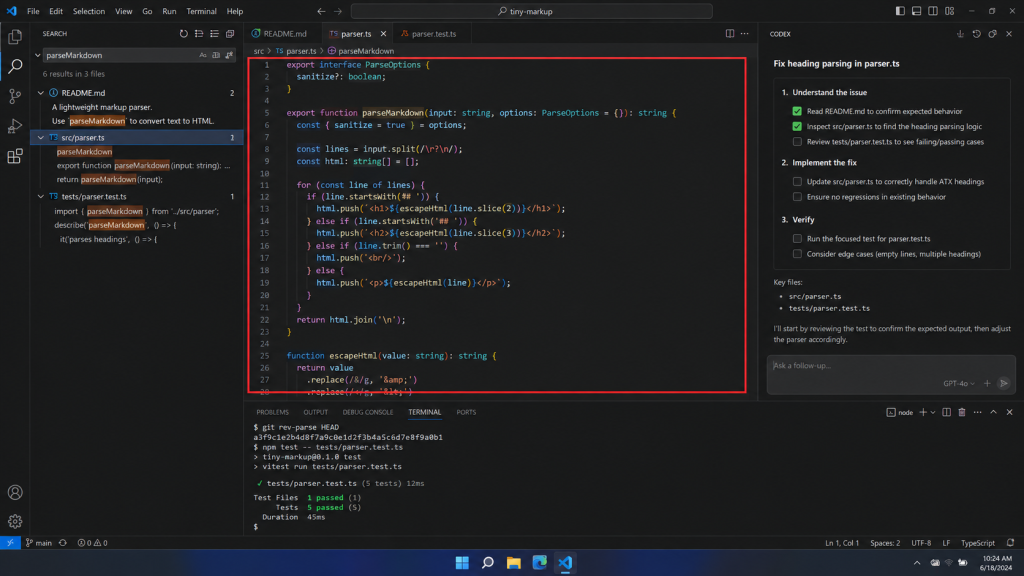
目前只完成挑戰規則與評分表,尚未選定 Repository 或執行任務,因此沒有結果。選定對象後會公開足夠資訊讓讀者重現,並遵守其授權和貢獻規則。
陌生 Repo 挑戰真正測的是搜尋、建立模型、驗證和交代工作的完整能力。明天用同一題比較人類、ChatGPT 協作與 Codex 三種流程。


 iThome鐵人賽
 看影片追技術