

經過 27 天,很容易憑印象說某種方法比較快。今天把同一類型任務分配給三種流程:人類獨立完成、人類搭配 ChatGPT 討論、Codex 在 Repository 中執行。目標不是選冠軍,而是看各自把時間花在哪裡、適合哪種工作。
三次執行使用等價的起始 commit、同一份 Issue、驗收案例和環境。為避免第一次解題經驗影響後面,可準備三個難度與結構相近的任務,再隨機分配流程;若只能用同一題,就必須揭露順序效應。工具版本、權限與人工提示也要記錄。
量化欄位包括完成時間、首次測試通過時間、修改檔案與行數、失敗測試、Bug、人工介入和最終測試結果。質化欄位包括需求理解、程式可讀性、錯誤處理、與現有模式一致性,以及 PR 說明是否清楚。由同一套驗收表和 Reviewer 評估。
ChatGPT 協作流程中,人類仍操作 Repository,因此時間要包含閱讀、複製資訊、實作和驗證;Codex 流程也要計入等待、Review 和修正,不只計模型運行時間。人類獨立流程同樣包含查文件與 Debug。比較的是完成可接受成果的總成本。
若 Codex 最快但需要較多 Review,可能適合範圍清楚、測試完整的任務;若 ChatGPT 協作在需求澄清表現最好,可能適合早期設計;人類若在模糊架構問題更穩定,代表經驗仍是主要優勢。一次實驗只能描述這些任務,不能推論所有語言和團隊。
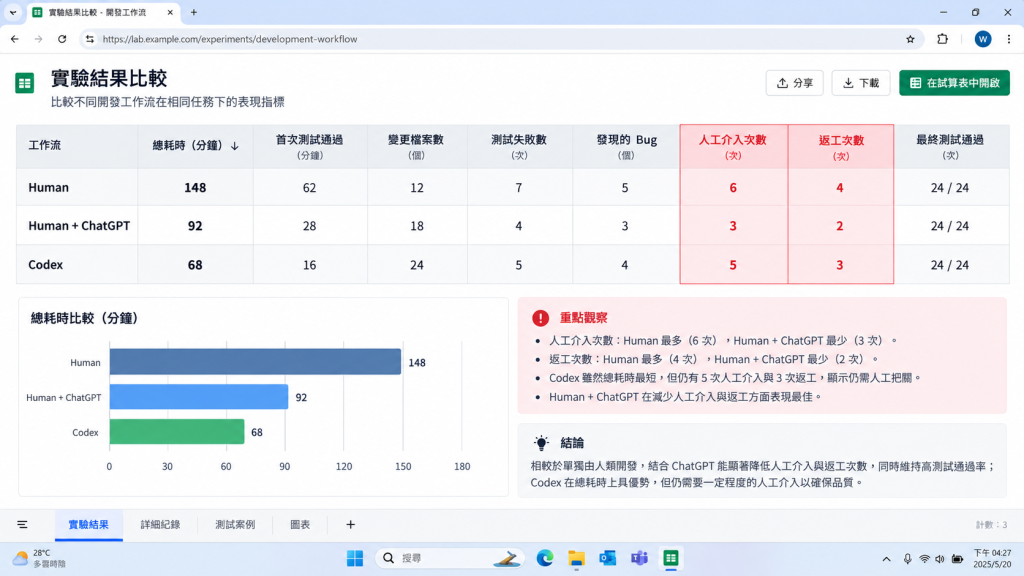
目前完成公平比較的設計,尚未執行三組任務,因此不提供排名或數據。實測時會保留未完成與失敗結果,不用事後調整權重讓偏好的流程獲勝。
「誰比較好」必須改寫成「在什麼任務、限制和驗收下,哪個流程成本較低」。明天整理 30 天最常見的失敗模式,建立一份可操作的避坑圖鑑。


 iThome鐵人賽
 看影片追技術