
Day 2 把穿戴輸出拆成量測、計算、推估三層,並把 PPG 放在最底下的「量測」那一格。但那一格裡面到底是什麼,當時沒有打開看。今天把它打開:感測器真正拿到的是什麼、那串數長什麼樣子、從它走到「72 bpm」中間發生了哪些事。
這是整條管線的第一層。如果這一層的東西是什麼都說不清楚,後面的 baseline、deviation、feature contract 都是蓋在沙上。
我原本以為:
PPG 發出綠光,照到血管,血管裡的血把光吸收掉一部分,反射回去的光的強弱會隨著心跳而有規律地起伏,接收器 PD(photodiode)接收光訊號,再透過傅立葉轉換得到波形,然後再經由波形去算心率。兩個波峰之間是心跳間隔⋯⋯
但實際真的是這樣嗎?
綠光 LED 打在皮膚上,光進入組織,一部分被吸收、一部分散射回來,由 photodiode(PD,光偵測器)接收。PD 把光轉成光電流,經過放大、濾波、ADC 取樣之後,成為一串隨時間排列的數。沒有傅立葉轉換,波形就是取樣後的時域序列。
所以直接量測到的是反射光強度。強度越強,代表進入 PD 的光越多,代表該處的血液量越少(血量少 → 吸收少 → 反射多)。
要注意量的對象:不是某一條血管,而是組織微血管床(microvascular bed)的血容積變化。
心臟收縮把血液打出去,壓力波沿著動脈傳到手腕,該處微血管床的血容積上升,光吸收增加,反射光強度下降;壓力波過去之後,局部血容積回落,吸收減少,反射光回升。每一次搏動帶動一次起伏,於是反射光強度出現週期性變化。
這裡有兩件容易漏掉的事。
一是時間差。手腕上的脈動和心臟收縮不同時發生,壓力波要花時間傳到末梢。這也是 Day 9 要談的 PPG 與 ECG 對不齊的原因之一。
二是波形不只有心跳。Allen J. (2007) 把 PPG 拆成兩部分:心跳同步的脈動成分(AC),疊在一條緩慢變化的基線(DC)上,而基線帶有呼吸、交感神經活性與體溫調節的低頻成分。畫出來的波形會漂,那不是壞掉,是 DC 那一層。濾波第一個要處理的通常就是它。
先排除一個常見的混淆:P、Q、R、S、T 是 ECG 的波形成分,描述心臟電氣活動在體表的投影。PPG 量的是光,沒有這些成分。PPG 有自己的一套特徵點:主峰(systolic peak)、重搏切跡(dicrotic notch)與其後的次峰(diastolic peak)。
一次脈搏的間隔通常取相鄰主峰之間,也可以取波谷或上升支斜率最大的點。取哪一個點,抖動程度不一樣。
名字也要分清楚。從 PPG 峰到峰得到的是 pulse interval,由它算出的變異性叫 PRV(pulse rate variability);R-R interval 專指 ECG。安靜狀態下 PRV 估 HRV 夠接近,但運動與部分心理壓力下,兩者的一致性會差到不可接受的程度(Schäfer & Vagedes 2013)。這是 Day 4 與 Day 9 的伏筆。
直覺是三步:去雜訊、找峰、換算。實際上頭尾各多一步,而多出來的那兩步,正是後面出問題的地方。
開頭要自己算時間軸。 檔案打開是一長串數字,沒有時間欄。哪個數字對應第幾秒,得從取樣率推回去——64 Hz 就是一秒 64 個數字。
結尾的 bpm 不是一拍算出來的,通常取一段視窗的平均。PPG-DaLiA 用 8 秒視窗、每 2 秒算一次,而且是在峰「偵測並修正」之後才算(Reiss 2019):漏抓、多抓、雜訊造成的假峰,都得先清掉。
傅立葉轉換也在這一步,不在前面。對一段視窗做 FFT、取主頻,是換算 bpm 的另一條路線。
所以「72 bpm」裡藏著兩個別人替你做的決定:走時域還是頻域,視窗多長。
動作最常見。手一晃,感測器和皮膚的相對位置就變了,波形跟著亂。PPG-DaLiA資料集 特地在手腕上多錄一組加速度,就是為了事後把這些時段挑出來(Reiss 2019)。天冷手冰、末梢血流少的時候,脈動幅度本來就小,峰也更難找(Nitzan 2014)。
取樣率則是躲不掉的那個。64 Hz 表示每 15.625 ms 才有一個數字,峰只能落在這些點上。
而「壞」不只是波形難看。一個位置抓偏的峰,會先變成一個錯的間隔,再變成一個錯的 PRV,最後變成一句「你今天恢復不佳」。
上面講的是 PPG 的原理。但實際打開PPG-DaLiA資料集檔案,欄位叫 BVP,不叫「反射光強度」。
同一個訊號,論文把它列為 raw data,廠商自己的說明卻說它經過一套 proprietary algorithm、把綠光和紅光的訊號混算出來(Reiss 2019;Empatica)。兩邊對不上,細節查不到。
也就是說,連「載入並畫出波形」這種最基本的動作,拿到手的都已經不是感測器的原始輸出。Day 2 那張三層圖講的事,在「量測」這一格裡面又發生了一次。
PPG-DaLiA(UCI dataset 495)。15 位受試者在日常活動情境下同步錄製腕式 Empatica E4 與胸帶 RespiBAN。壓縮檔 2.7 GB,解壓後 24.1 GB,今天只解出 S1。
S1 的三個訊號通道各跨 9,212.00 s(153.53 min):腕式 BVP 64 Hz(589,568 點,單位原文未給)、腕式 ACC 32 Hz(g)、胸帶 ECG 700 Hz(mV),樣本數比例和取樣率比例分毫不差。ground truth HR 另存成 label,4,603 筆,剛好等於 (9212 − 8) / 2 + 1——Reiss 2019 說它是「8 秒視窗、2 秒位移」算出來的,論文裡的一句方法描述可以直接在檔案上驗證。
另外兩件和研究筆記對不上的事:胸帶實際還有 EDA、EMG、Temp 三個通道,論文的通道描述只列了 ECG、加速度與呼吸;檔案裡另有 questionnaire(含 SKIN,膚色)與 rpeaks(11,431 筆,胸帶 ECG 的 R-peak 位置),筆記都沒記。最後這一項等一下會用到。
pickle.load(fh, encoding="latin1") 讀(資料集是 Python 2 存的)。用 activity 標籤挑最長的靜坐區段(700 s,起於 90 s),取其中的 120–140 s;下面的圖畫的是這 20 秒的前半。sosfiltfilt(零相位,峰不會位移),兩端各鏡像填充 2 秒;scipy.signal.find_peaks 的 distance 由 max_bpm 換算,prominence 由訊號振幅動態決定,用來擋掉重搏切跡後的次峰。from wearable_ai.datasets import load_subject
from wearable_ai.signal_processing import find_pulse_peaks, peak_intervals_ms, time_axis
FS = 64.0
subject = load_subject(1) # data/public/ppg+dalia/PPG_FieldStudy/S1/S1.pkl
x = subject.ppg[int(120 * FS): int(140 * FS)] # 靜坐區段內的 20 秒
t = time_axis(len(x), FS) # 秒;t[-1] 是 (n-1)/fs,不是 n/fs
peaks = find_pulse_peaks(x, FS) # 主峰的樣本索引
intervals = peak_intervals_ms(peaks, FS) # 毫秒
[S1 腕式 BVP 的 10 秒波形,上圖標出 7 個主峰,下圖為相鄰峰的間隔]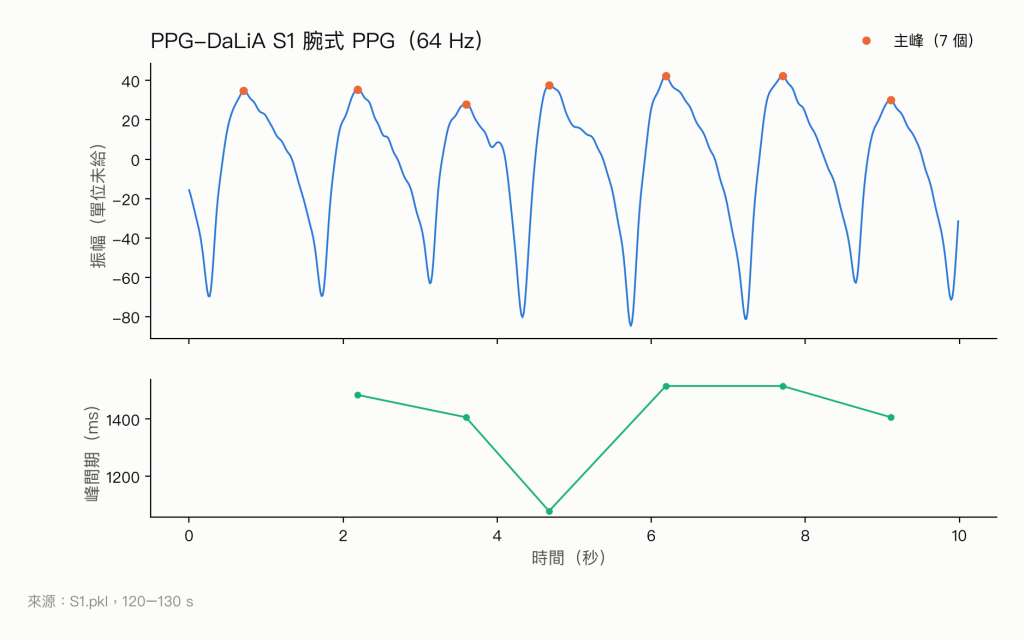
上圖:S1 的 120–130 s,也就是上面那 20 秒的前半,7 個主峰。每個週期都是陡升到最大值,下降段有一個次級隆起——那就是重搏切跡之後的次峰,Concept 裡講的形態,在真實訊號上看得到。下圖:相鄰峰的間隔,1,078 到 1,516 ms。
對照開頭那段「我原本以為」,實際跑完之後:
第 6 點值得展開。合成波形的第一個峰原本落在 index 0,而 scipy.signal.find_peaks 找不到端點——端點沒有兩側鄰居。為了讓那個峰被找到,程式在左側加了鏡像填充。測試變綠了。
但鏡像填充讓 x[0] 必然成為局部極大。換到真實資料,S1 的 120 s 那一點 BVP 是 −15.70,其後五個樣本單調下降到 −27.51,明顯在下降段中間——偵測器照樣把它標成峰,並產生一個 703 ms 的假間隔,把中位間隔從 1,437.5 ms 拉到 1,421.875 ms。
真正修好它的是另一步:明確排除 index 0 與 n−1。把三種填充方式各跑一次,排除端點之後三種的結果一模一樣,都是 14 個峰、中位間隔 1,437.5 ms。填充方式只影響合成測試(改成左右對稱,讓末峰的偏差由 3 個樣本降到 1 個),在真實資料上不改變答案。
也就是說,這個補丁裡真正有用的那一半,不是當初為了讓測試變綠而加的那一半。
「量測」那一格裡面還有一層。 Day 2 把 PPG 歸在量測層,但今天打開檔案才發現,拿到手的 BVP 平均值是零——廠商已經把 DC 拿掉了,用的是一個查不到細節的 proprietary algorithm。所以 feature contract 要記的不只是 level,還要記「這個欄位在到我手上之前被誰動過、怎麼動的」,以及最誠實的那一欄:不知道。
測試綠燈不等於正確。 padding 那個 bug 的因果鏈是:合成 fixture 的生成慣例(峰從相位 0 開始)→ 一條測試要求端點的峰被找到 → 程式加了填充 → 填充在真實資料上製造系統性假峰。整條鏈上每一步都合理,合起來是錯的。而且它只在真實資料上現形。這件事會在 Day 26 的評測集上以更大的規模重演:評測集本身的偏差,會塑造被評測的系統。
上游的取樣率是下游指標的精度上限。 15.625 ms 這個數字不會出現在任何一個 CSV 欄位裡,但它決定了峰間期能有多細。Day 4 之後要算的 RMSSD 是「相鄰間期差值」的統計量,而差值的顆粒就是它。一個標著 hrv_ms: 42 的欄位,背後有一個沒人寫下來的解析度下限。


 iThome鐵人賽
 看影片追技術