

Day 23 的 wearable-ai run 已能把合成資料或 LifeSnaps 整理成摘要,但還不會呼叫 LLM。前幾天做的結構化輸出、引用檢查、context 選取和回歸測試也各自能跑;使用者仍沒有一個入口能從資料取得洞察。如果 CLI 和 API 分別串接這些步驟,同一份資料可能因 prompt、選取方式或驗證順序不同,得到不同的處理結果。
今天把這些步驟接成一個共用函式,讓 CLI 和單一 API endpoint 都從資料來源、人與日期等識別字開始,由伺服器讀取本機資料、建立摘要,再產生並檢查洞察。我會用合成情境測試:引用是否指向模型實際看到的資料,資料不足時是否保留「無法判定」,失敗時能否看出停在哪一關。同時記錄耗時、token 與估計成本。Day 26 的單次模型呼叫中位數是 26.2 秒,但當時輸入不同;本篇會以 prototype 的紀錄作為討論依據。這次只做本機入口,不做部署。
同一份請求從 CLI 或 API 進來,都應走相同的路徑:依識別字讀資料、建立日層級摘要、選出要送給模型的 context、呼叫模型,再檢查回應。兩種入口只負責接收參數和呈現結果。這次入口不收呼叫端自帶的 records 或 summary;資料與摘要由伺服器產生。各步驟使用的版本、送出的內容和停下的位置也要留下紀錄,否則兩次看似相同的回答無法對照。
引用尤其要看模型這次真正收到的摘要。context builder 可能省略較舊的逐日資料;即使完整摘要裡找得到某個日期或數值,只要這次沒有送出,就不能拿它替模型補證據。Day 23 的 PPG 分支只到視窗層級,還沒有每日 baseline 的輸入契約,因此這個服務也只接日層級資料。
送出前要檢查輸入與日期、摘要有沒有洩漏情境名稱或識別字,以及選出的 context 是否符合預算。洩漏檢查要針對最後送給模型的文字;fits=False 就停下,不能把超預算的內容照樣送出。模型回來後,再分辨 API 錯誤、輸出截斷、JSON 或 schema 不合,以及引用路徑與內容是否有足夠支持。CLI 用結束碼、API 用 HTTP 狀態呈現,但兩者應保留相同的失敗階段與原因。
檢查通過也有範圍:schema 只管格式,citation checker 只能核對部分可由程式判定的主張;需要人判讀的內容,不能因請求回 ok 就視為語意正確或醫療有效。Day 26 的 evalcheck 還需要測例預先寫好的期望答案,一般使用者請求沒有這份答案,所以它留在離線回歸測試,不放進服務流程。資料不足或 baseline 不可判定時,服務也不應把這些狀態改寫成「沒有異常」。
這次先固定 gemini-3.8-flash 和一組 prompt、schema、檢查規則,沒有比較其他模型。若日後要比較,不能只看一次呼叫多快或多便宜;還要一起看有多少輸出能通過驗證、引用有沒有問題,以及失敗或重試增加的呼叫。今天的 endpoint 預設不重試,也不接修正迴圈;CLI 可以調高重試次數,所以報成本時要說清楚使用哪個設定。
一次請求的牌價估算要算輸入 token、可見回答的 token,以及 thoughts token;thoughts 也按輸出價計費。輸入預算的本地估算或 count_tokens 無法預知輸出長度和最後費用。時間則要分開看模型 API 呼叫與服務已計時階段的合計:前者包含與供應端往返,後者還有載入、選 context 和驗證,並非完整的 HTTP 往返時間。這些口徑固定後,延遲與成本數字才有可比性。
應用層若直接快取模型回應,下次命中就會拿到舊答案;這種回應不能算一次新的回歸測試樣本。供應端的 context caching 不同:它可能重用輸入的共同前綴並減少該部分的計費,模型仍會重新產生回應。因此重複實驗可保留供應端快取,但每次都要記錄是否命中,否則成本比較會失真。
這個模型支援隱式快取,但是否命中取決於送出的內容與時間間隔,不能先把折扣算進成本。服務目前也沒有應用層的回應快取。一般使用時要不要快取,還得看實際重複請求有多少;本篇先記錄模型回報的快取 token,再依實測討論節省幅度。
服務的輸入是識別字,不是資料本身:client 送資料來源、人、解讀日、問題類型,specific_date 再加指定日;伺服器從本機讀資料,自己產生 60 天的 summary-v2、經 context builder 選取後送出。client 不能送 records 或 summary(InsightRequest 設 extra="forbid"),所以洩漏檢查與版本都由伺服器負責。
實驗沿用 Day 25 的三個案例,再加一個 current;都來自兩個合成情境的 p01、解讀日 2026-03-05,每案呼叫 3 次(days/day27/prototype_demo.py 的 CASES):
| 問題類型 | 情境 | 問題句 | 逐日列日期 |
|---|---|---|---|
| trend | sleep_debt | 我最近一週的資料有沒有變化? | 02-18~03-05 |
| specific_date | sleep_debt | 請說明 2026-02-04 這一天的資料。 | 02-01~02-07、02-25~03-05 |
| vs_baseline | drift_vs_event | 和我自己平常的水準比起來,我今天的資料如何? | 02-16~03-05 |
| current | sleep_debt | 請說明我今天的資料顯示了什麼。 | 02-18~03-05 |
context builder 依問題類型挑選逐日列,四案都只省略較舊的列。prompt-v2 比 Day 25 的 v1 長、預算仍是 8,000,所以 trend 與 specific_date 的逐日列各比 Day 25 少一天。
CLI(wearable-ai ask)和 endpoint(POST /insight)都只呼叫 src/wearable_ai/service.py 的 answer。一次請求依序經過七個階段,每個階段記下名稱、狀態與耗時:
| 階段 | 做什麼 | 失敗時的類別 |
|---|---|---|
source |
載入情境或 LifeSnaps,檢查人與日期格式(沿用 Day 23 的 run.synthetic_source) |
bad_request、data_not_found |
summary |
檢查解讀日在資料範圍內,payload → summary-v2,涵蓋 60 天 |
bad_request、contract |
context |
build_context:依問題類型與預算 8,000 選取(context-v1);fits=False 就停 |
bad_request、over_budget、internal |
leak_check |
送出的文字不能含情境名稱、情境路徑或 subject_id | leak |
llm |
一次 generateContent |
llm_api、truncated |
validate |
四層:parse、schema、evidence、cross_field(grounding-validator-v1) |
invalid_output(停在前三層) |
check |
逐筆 claim 三態(citation-checker-v1) |
— |
leak_check 檢查的是 context builder 組好、真正要送出的文字,不是 summary.json,這是 Concept §2 的要求。evalcheck 不在路徑上:它比對的是測例的期望答案,線上請求沒有期望。
預設版本與參數:prompt-v2、output-v2、insight-schema-v2、gemini-3.8-flash、response_json_schema、max_output_tokens 16384(Day 24–26 是 8192;模型上限 65,536,模型頁)、thinking_level 不設(預設 medium)、沒有修正迴圈,所以在預設設定下,最壞情況一次請求就是 1 次模型呼叫。endpoint 不重試(max_attempts=1),CLI 可用 --max-attempts 調高。
失敗類別延伸 Day 23 的 EXIT_CODES,送出前的 0–5 不變,送出後新增三類,送出前另加 over_budget:
| 類別 | 結束碼 | HTTP | 什麼時候 |
|---|---|---|---|
bad_request |
3 | 400 | 參數不合,例如解讀日不在資料範圍 |
data_not_found |
2 | 503 | 伺服器沒有這份資料 |
contract、leak、internal |
4、5、1 | 500 | 資料契約不合、洩漏、其他例外 |
llm_api |
6 | 502 | API 錯誤,重試後仍失敗或不可重試 |
truncated |
7 | 502 | finish_reason == MAX_TOKENS,不重試 |
invalid_output |
8 | 502 | 驗證停在 parse、schema 或 evidence |
over_budget |
9 | 500 | 目前選取仍超過預算(fits=False),不送出 |
body 欄位不合(缺欄位、多欄位、型別錯)由 FastAPI 回 422,不進 answer。truncated 不重試,是因為原樣重送很可能又被 thinking 吃滿,而截斷時已產生的 thinking 照輸出價計費(Thinking;research/notes/Gemini的thinking計費口徑與供應端context caching.md)。
實驗後補上兩項防護:不合法或晚於解讀日的 target_date 由請求驗證擋下(HTTP 422、CLI 結束碼 3),不在摘要範圍內回 bad_request(400);fits=False 也會停止送出。原本兩者分別回 500 internal 與照樣送出。這四案的日期有效、估算皆為 fits=True,所以既有 12 份紀錄不受影響。
成功時 HTTP 都是 200、結束碼都是 0,由 status 區分:四層驗證都通過、checker 沒有 fail 是 ok;通過 evidence 層但 cross_field 失敗,或 checker 有 fail,是 needs_review。checker 的 needs_human 不算失敗,只回報筆數:線上請求沒有人工複核那一步,要怎麼顯示交給 client。
實驗:四案各呼叫三次,共 12 次,2026-10-10 透過同一 process 的 TestClient 依序送出,請求之間不等待。本文的延遲是 answer 七個階段的時間總和(ServiceResult.elapsed_s),不是完整 HTTP 往返;其中模型階段包含與供應端的網路往返。CLI 只用既有紀錄重放,沒有另外呼叫模型。
費用是牌價估計:付費 Standard 方案,輸入 0.75、輸出 3.75、快取命中的輸入 0.075 USD/1M token,thoughts 照輸出價(Pricing 2026-10-09 版,2027-01-01 起全部翻倍)。專案用的是免費額度,沒有付款;是否從額度扣抵沒有核對。
endpoint 只做 HTTP 的轉換(src/wearable_ai/api.py):
@application.post("/insight")
def insight(req: svc.InsightRequest, dry_run: bool = False):
    try:
        res = svc.answer(req, generator=generator, config=config, dry_run=dry_run)
    except svc.ServiceError as err:
        body = err.to_dict()
        body.pop("llm_record", None)          # 回應不含完整的送出內容
        return JSONResponse(body, status_code=err.http_status)
    return res.to_dict(include_record=False)
answer 送出後的部分(src/wearable_ai/service.py,節錄):
rec = tm.run("llm", llm.run_once, generator, ctx.text, call_config(cfg),
             max_attempts=cfg.max_attempts, backoff_s=cfg.backoff_s)
if rec["response"] is None:
    tm.fail("llm_api", "llm", ...)
resp = rec["response"]
if resp["finish_reason"] == "MAX_TOKENS":
    tm.fail("truncated", "llm", ...)          # 費用已記在 result.cost_usd
docs, report = tm.run("validate", _validate, rec["request"]["contents"], resp["text"])
if not (report.ok or report.stage == "cross_field"):
    tm.fail("invalid_output", "validate", ...)
parsed = gr.parse_response(resp["text"])
chk = tm.run("check", gr.check_response, parsed, docs["summary"])
result.status = "ok" if report.ok and chk.counts()["fail"] == 0 else "needs_review"
驗證與 checker 比對的 summary 是從實際送出的 contents 解析出來的(_validate),不是重新產生的那份。
使用:
uv run uvicorn wearable_ai.api:app
curl -s localhost:8000/insight -H 'content-type: application/json' \
  -d '{"source":"synthetic","scenario":"sleep_debt","person":"p01","date":"2026-03-05","question_type":"trend"}'

uv run wearable-ai ask synthetic --scenario sleep_debt --person p01 --date 2026-03-05 \
  --question specific_date --target-date 2026-02-04 --out r.json

uv run python days/day27/prototype_demo.py --section 1            # dry run,不呼叫 API
uv run python days/day27/prototype_demo.py --section 2 --via api  # 12 次請求
uv run python days/day27/prototype_demo.py --section 3            # 整理成 results.csv
uv run python days/day27/plot_latency.py
tests/test_day27.py 的 44 項離線測試涵蓋 CLI/API 一致性、日期與預算防護,以及成功、截斷和錯誤回應,用既有回應重放與 mock,沒有新增模型呼叫。其中一項用 Day 25 的設定跑 dry run,送出文字與 Day 25 逐字相同:這證明服務接上的是同一條 pipeline,不證明 pipeline 本身對。
| 案例 | r1 | r2 | r3 |
|---|---|---|---|
| vs_baseline | ok | ok | ok |
| current | ok | ok | ok |
| trend | ok | ok | needs_review |
| specific_date | needs_review | needs_review | ok |
12 次都回 HTTP 200,其中 9 次 ok、3 次 needs_review。每次都是第一次嘗試就有回應,沒有遇到 API 錯誤、截斷或無法使用的輸出,所以這三種失敗只在測試裡驗證過。
3 次 needs_review 都有一筆 claim 提到的日期沒有被引用欄位支持(checker 的 date_unsupported)。例如 specific_date r1 說無法判定 2026-02-04 是否偏離,引用的卻是目前 baseline 視窗的開始日;2026-02-04 在摘要的逐日列裡,claim 沒有引用那一列。這不等於內容一定錯,而是證據不足以支持這句話。同一份 r1 還有一筆 claim 的 kind 標錯(cross_field 失敗),和 Day 26 是同一種,依設計仍回 200。其餘需人工判讀的 needs_human 每份 2–11 筆,沒有審查,所以 ok 也不代表語意已確認正確。
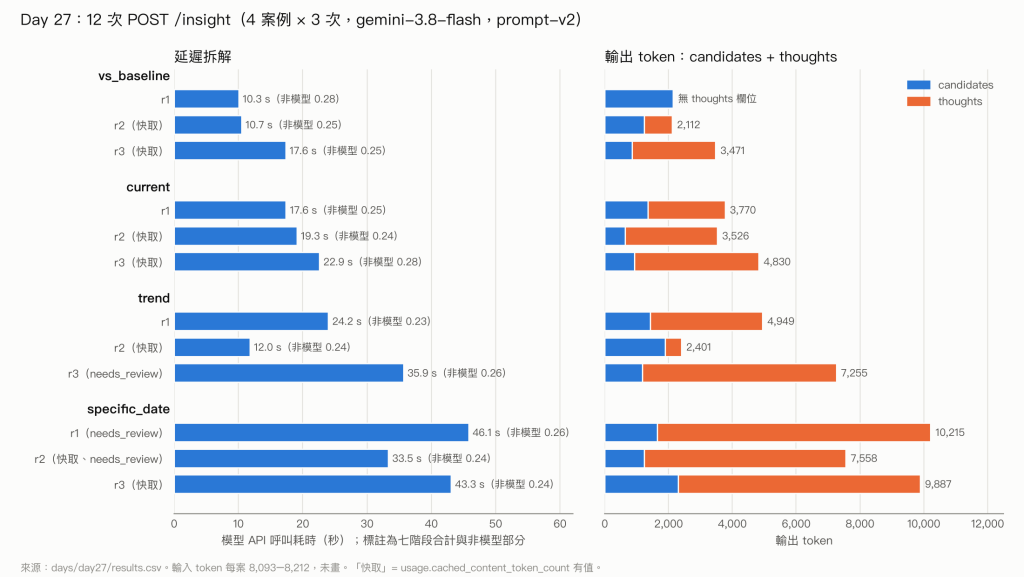
12 次 POST /insight(4 案例 × 3 次)。左:模型 API 呼叫耗時,旁註七階段合計與非模型部分(0.23–0.28 s);右:輸出 token,candidates 與 thoughts 堆疊。輸入 token 每案 8,093–8,212。
| 部分 | 中位數 s | 範圍 s |
|---|---|---|
| 送出前(source~leak_check) | 0.242 | 0.226–0.277 |
模型 API 呼叫(llm) |
20.85 | 10.05–45.81 |
| 送出後(validate + check) | 0.005 | 0.002–0.007 |
| 七階段合計 | 21.11 | 10.33–46.07 |
模型 API 呼叫佔七階段合計的 97.3%–99.4%,前後處理合計不到 0.3 秒。同一份 trend 輸入,三次的模型耗時約 11.8–35.7 秒。這 12 次中,模型耗時與輸出 token(candidates + thoughts)高度相關(Pearson r = 0.995),但沒有控制其他條件來驗證因果。
兩份 specific_date 輸出的 candidates + thoughts 超過 Day 24–26 的上限 8192(10,215、9,887);本次上限是 16384,沒有觀察到截斷。沒有做相同輸入的新舊上限對照,所以不能說提高上限改善了成功率。
| 案例 | 估計 | 實際 prompt_token_count |
超過 8,000 |
|---|---|---|---|
| trend | 7,877 | 8,093 | +93 |
| specific_date | 7,944 | 8,155 | +155 |
| vs_baseline | 7,960 | 8,212 | +212 |
| current | 7,878 | 8,093 | +93 |
四案估算都低於 8,000 token,模型回報卻全部超出 93–212 token,實際比估計多 2.7%–3.2%:2.444 字元/token 的換算比例不適用於這批輸入。本次沒有接 count_tokens,所以 fits=True 只代表估計放得下;就算當時已有 over_budget 防護,這四案仍會送出。要更可靠地控制輸入,還需要計數或保留餘裕,而計數也有次數上限。
| 指標 | 中位數 | 範圍 |
|---|---|---|
| 一次請求的估計 USD | 0.0200 | 0.0097–0.0444 |
| 其中 thoughts 的 USD | 0.0120 | 0–0.0321 |
12 份合計 USD 0.2757,thoughts 佔 0.1698(61.6%)。
12 次中有 7 次回報快取命中(cached_content_token_count),約涵蓋輸入的 79%(§7):
| 案例 | r1 | r2 | r3 |
|---|---|---|---|
| trend | — | 6,404 | — |
| specific_date | — | 6,464 | 6,464 |
| vs_baseline | — | 6,519 | 6,519 |
| current | — | 6,404 | 6,404 |
依牌價估計,7 次命中合計少約 USD 0.0305,12 份約省 10.0%,不是實際帳單。命中都出現在相隔 1.2–1.9 分鐘重送相同文字時,但 trend r3 同樣重送卻未命中;Day 26 的 54 份都沒有命中,其中 36 份是間隔 7–9 分鐘重送相同文字。因此這次結果不能當成一般請求的命中率,也沒有證明快取讓回應變快(Caching)。
| 原本以為 | 實際發現 |
|---|---|
| 我原本以為少量實際請求就能碰到至少一種送出後的失敗。 | 12 次都回 200;三種送出後的失敗只在測試的重放與 mock 裡驗證過。 |
| 我原本以為載入資料、選 context 與檢查會佔可觀時間,同一份輸入的耗時也會相近。 | 前後處理合計不到 0.3 秒;模型呼叫佔 97% 以上,同一份 trend 輸入仍差 3 倍(11.8–35.7 秒)。 |
我原本以為 fits=True 就代表送出的輸入在 8,000 token 以內。 |
四案都超過,多 93–212 token。 |
| 我原本以為成本主要來自輸入與可見的回答,調高輸出上限只是多留餘裕。 | thoughts 佔估計成本 61.6%,兩份輸出超過舊上限 8192。 |
| 我原本以為和 Day 26 一樣,不會看到供應端快取命中。 | 7/12 次命中,都在短間隔重送同一份請求時,牌價估計省 10.0%。 |
| 我原本以為只要日期在同一筆資料裡,引用路徑略有偏差仍會通過。 | 3 次 needs_review 都是 claim 的日期不在它引用的欄位裡。 |
這次只經 TestClient 在同一個 process 連續送出 12 次請求;七個已計時階段的合計不含 client 端的網路傳輸、FastAPI 的 request 處理與序列化、uvicorn、併發排隊或部署環境,因此 21.11 秒的中位數不能當成實際服務的端到端延遲。CLI 與 API 共用函式雖由重放測試核對,CLI 沒有實際呼叫模型。12 次真實呼叫全數回 200,也就沒有量到 llm_api、truncated、invalid_output 在真實服務裡發生的頻率或處理耗時;這三條路徑目前只有測試紀錄支持。max_output_tokens 從 Day 24–26 的 8192 改為 16384,連同 prompt 與輸入範圍都不同,不能把這次沒有截斷或較短的中位延遲直接解讀為相對前幾天的改善。
資料只涵蓋兩個合成情境、同一個人與解讀日的四種問題類型,每種重複三次;其中三案沿用 Day 25 的案例,沒有測到公開資料、其他人的日常變異或真實使用時的請求分布。ok 只表示既定的 schema、驗證與引用規則通過,checker 標出的 needs_human 沒有人工判讀,不能據此判定語意或健康解讀正確。成本是單一模型、預設 thinking 設定下的付費牌價估計,專案實際使用免費額度;沒有比較其他模型或 thinking level,新額度上限也未記錄。供應端快取的七次命中只出現在短間隔重送同一份請求時,trend r3 卻未命中;目前無法從這 12 次推定一般使用情境的命中率或節省幅度。
共用一個處理函式,讓 CLI 和 API 用同一套規則回報結果與失敗原因。這次真實呼叫沒有碰到服務錯誤,錯誤處理仍靠重放與 mock 驗證;HTTP 200 也要繼續看 ok 或 needs_review,才能知道是否需要檢查輸出。
這批請求的時間主要花在模型呼叫,費用也不能漏算 thoughts。下一步可以優先比較 thinking 設定、輸出長度或模型,同時檢查品質;目前的數字還不能保證哪一種調整會更好。
預算與快取都要看實際紀錄。本地估算可能低估;本專案不同請求的共同前綴曾估計低於隱式快取的門檻,這次命中又只出現在短間隔重送,不代表日常使用的表現。把輸入、版本、usage 與驗證結果留下來,才能在下一輪用更多情境比較成本、延遲與輸出品質。Day 28 擴大到約 20 個情境時,可以直接用這個服務當評測入口:輸入是識別字、版本寫在結果裡、所有紀錄都能重放。


 iThome鐵人賽
 看影片追技術