
Part 1 導讀|第 2/30 篇
今日要做的事: 把食物浪費發生的三個地方攤開來看,說清楚這 30 天只打其中一個;然後把「到底有沒有比較好」寫成算式。
今天要解決的目的: 讓 DishFlow 不會膨脹成「拯救全供應鏈」,也不會滑進醫療 App。
Day 0 講完故事,今天簽約。
從這篇開始每篇都有任務卡:先講今天要交出什麼,再動手。今天還是幾乎沒有程式,我知道這對技術文來說有點反常,但邊界沒畫完就開 Firebase,之後每個 bug 都會變成價值觀吵架。
| 項目 | 內容 |
|---|---|
| 產出 | 三端地圖、系統邊界、個資最小蒐集清單、指標契約、30 天路線圖 |
| 工具 | 沒有 Runtime。紙、圖、表格 |
| 不使用 | 不接 Health API、不建 Firebase;Prompt 與影像辨識從 Part 2 才開始 |
| 人工素材 | 自家廚房的備料照與成品照、一張邊角料利用實拍 |
| 對應最終指標 | 全部。今天定義的就是 Day 26–29 要填的那張表 |
這步該直接輸入還是上雲? 今天兩個都不用。
邊界跟指標是人的決定,不是模型的輸出,寫在紙上就夠。現在開一個 Firebase 專案只會讓我提早進入 schema 焦慮,然後在還不知道要存什麼的時候先把 collection 命名吵三天。工具是用來降低決策成本的,不是用來證明我會用。
先解釋一下「三端」是什麼,因為這詞是我自己的簡稱。
食物從被種出來到進你的胃,中間會在三個地方被丟掉。我按照「誰有能力阻止它」把它切成三段:
| 端 | 誰在丟 | AI Agent 理論上能做 | 本季做不做 |
|---|---|---|---|
| 供應端 | 餐廳、超商、賣場 | 依歷史銷售、天氣、節慶預測備料;即期品自動折扣 | ❌ 需要 POS 與商業資料 |
| 消費端 | 你家冰箱、你的餐桌 | 盤點庫存、優先消耗即期、在預算與時間內給可執行方案 | ✅ 本季全部火力 |
| 媒合端 | 剩食沒有去處 | 媒合餐廳剩餘物資與社福機構、規劃配送 | ❌ 牽涉食安與捐贈法遵 |
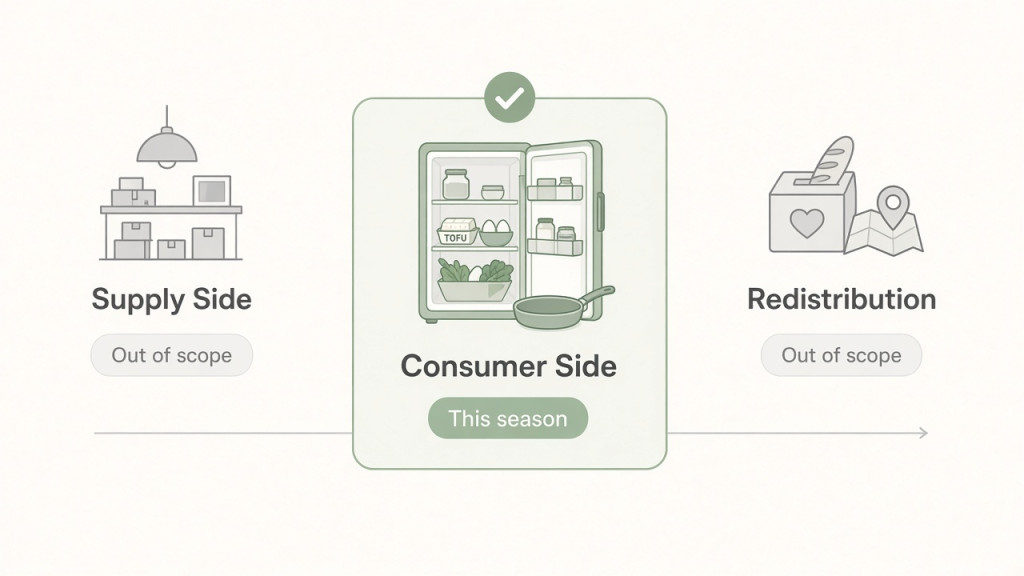
圖:三端都值得做,這 30 天只打中間那一格。
我很想說三端我全都要。但我只有 30 天、一台單口電磁爐,跟一份每天都要交的稿。
供應端要拿到 POS 資料,我沒有。媒合端牽涉食品安全與捐贈法遵,那是一個團隊加一個律師的題目,不是一個人的 30 天。剩下消費端,我有自己的冰箱、一張中餐丙級、還有一個計時器。這三樣東西剛好夠我真的煮、真的量。
所以這一季的題目縮到很小的一格:
你已經有什麼?什麼快壞了?今晚在你的預算、時間跟過敏底下,能不能先把它吃掉?
另一個膨脹方向同樣危險:把「AI 顧健康」寫成醫療 App。那會讓模型開始根據體脂數字下指令,而我連 Security Rules 都還沒寫。
A. 平日只有 20 分鐘的自煮者(我本人)
18:42 進門,冰箱有半盒豆腐、兩顆蛋、一把青江菜。預算不想再破百。最重要的是今天不想洗三個鍋子。
他不缺食譜,他缺「用現有東西、20 分鐘內結束」的那一個決定。
B. 只有超商或全聯!?的人
22:10 下班,方圓 300 公尺只有一間超商跟一間快打烊的全聯。沒有廚房、沒有鍋子,只有微波爐跟一百塊。
一般 AI 會叫他買酪梨。他需要的是「在剩下的這幾個貨架上,怎麼組出一餐」。
兩個人有個共同點:決定他們晚餐的不是喜好,是限制。這就是後面 Strategy Stack 的存在理由。
這裡先把我的廚房交代清楚,因為它會影響後面每一個估時:
單口電磁爐、一個深炒鍋、一個玉子燒鍋、一台微波爐
沒有烤箱、沒有氣炸鍋、沒有蒸籠、沒有第二個爐口
份量 1~2 人
「單口」這兩個字很關鍵。一邊燉咖哩一邊煎歐姆蛋,在我家物理上做不到。想蒸東西也只能用深炒鍋加兩公分水、墊個小碟子、蓋子留條縫。
這剛好是直接問 AI 最容易破功的地方。它很自然就會寫出「同時進行」,然後你站在那個唯一的爐口前面,發現這份標 20 分鐘的食譜實際要 35 分鐘。
1. 不做疾病診斷,不宣稱療效。
2. 過敏、禁止食材、設備、預算上限:程式決定,不讓 LLM 投票。
3. 活動量/體重/體脂是 Context,不是「走了 8000 步所以可以多吃」的公式。
4. 食物浪費只做消費端;供應端預測與剩食媒合最後一篇當展望,不進必做清單。
16:8 這類進食窗只接受使用者自己宣告,系統只負責排程,窗外不推正餐。它永遠不會說「你該開始斷食」,那是醫療判斷,不是餐點規劃。
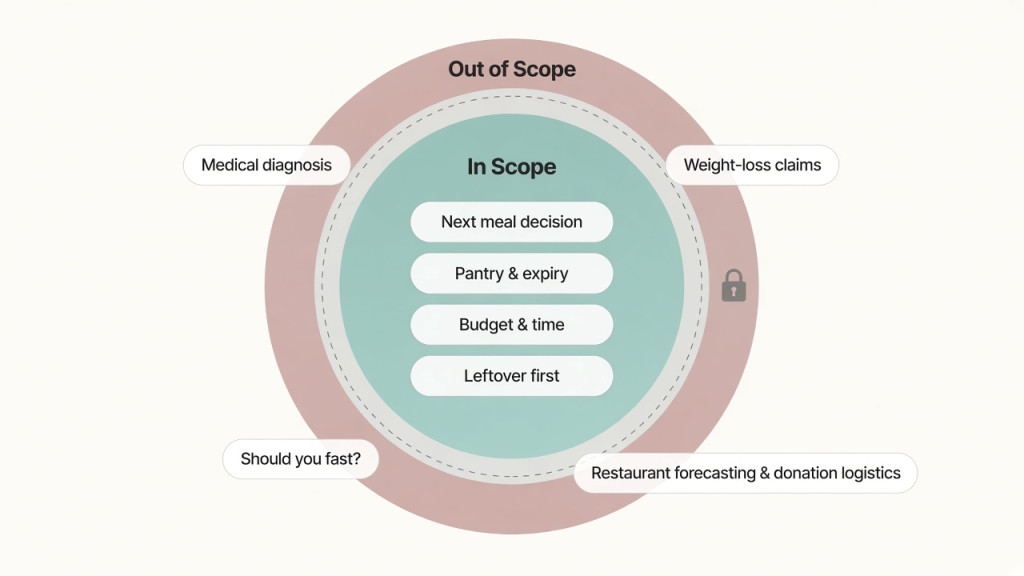
圖:內圈才是 DishFlow 的戰場。外圈那些不是我不想做,是這一季不該承諾。
第 2 條聽起來很抽象,看實物比較快。這是我做蒜香義大利麵時煎的蝦頭,用來煉蝦油,這道菜我自己蠻滿意的:
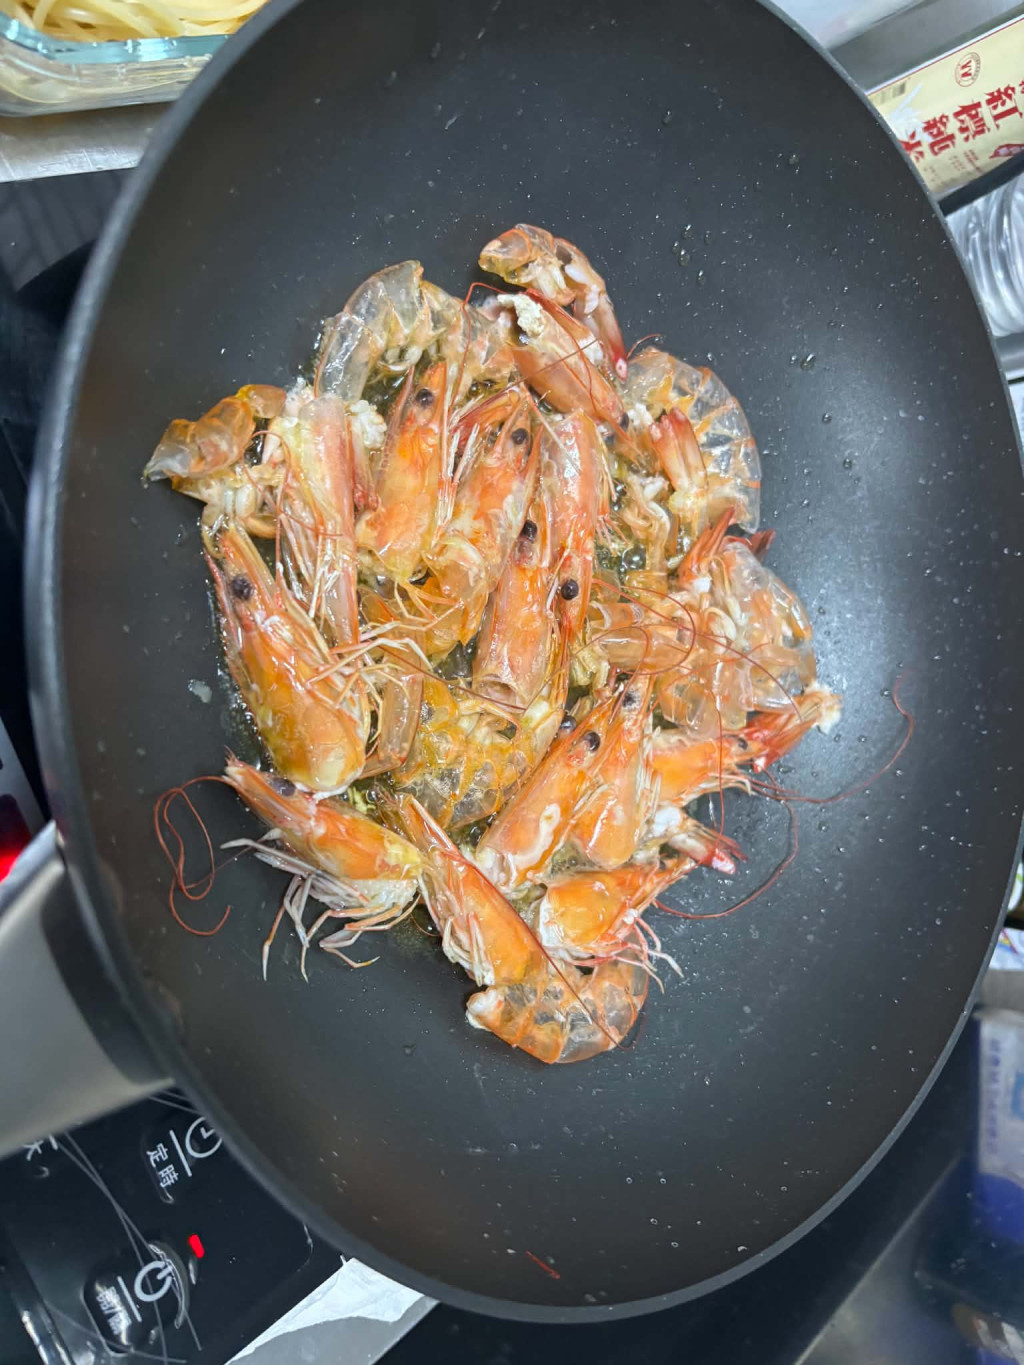
圖:蝦頭煉油,邊角料利用的漂亮示範。但如果使用者對甲殼類過敏,這道菜連被推薦的機會都不該有。
重點是誰有權說不。
如果讓模型判斷「甲殼類過敏能不能吃蝦」,一百次它會答對九十九次。問題是第一百次,它會很有禮貌地建議你「少量嘗試看看」。而那一次,可能剛好是坐在你家餐桌前的那個人。
所以這件事不進 Prompt。過敏原比對在候選菜送進模型之前就跑完,模型看到的清單裡根本沒有這道菜。Part 4 會把這段用程式跑出來。
這是我為最終評分特別設計的情境,因為它把好幾個難點壓在同一餐裡:
朋友要來吃飯,他對蝦過敏。而我冰箱裡有一包剝殼大蝦仁,兩天後到期。
一般 AI 會怎麼答?它會很禮貌地避開蝦,給你一份不含蝦的食譜。看起來沒問題。但這題有四個考點,它只做到第一個:
| 考點 | 及格線 |
|---|---|
| 排除 | 含蝦的菜一律不出現。這是底線,做到不加分 |
| 不過度排除 | 透抽是軟體動物、蛤蜊是貝類,不可以因為「都是海鮮」就一起封殺 |
| 器具 | 煎過蝦的鍋子要接著做給過敏者吃,得先洗過。硬限制不只管食材,也管鍋子 |
| 那包蝦怎麼辦 | 不能因為今天不能用,就讓它安靜地壞在冰箱裡 |
第二列是我最想證明的事。真正跑起來,Rule Engine 要做的其實是這種分流:
庫存:大蝦仁(2天到期)、透抽、蛤蜊、雞腿、蛋、豆腐
客人:對 crustacean 過敏
  │
  ├─ crustacean  → 蝦仁            ✗ 移出候選,不進模型
  ├─ mollusk     → 透抽            ✓ 留下
  ├─ shellfish   → 蛤蜊            ⚠ 標記,請本人確認
  └─ 其他        → 雞腿/蛋/豆腐   ✓ 留下
  │
  └─ 那包 2 天到期的蝦仁?
       → 產一張明日提醒:今天冷凍,或改天自己吃
如果系統裡只有一個籠統的「海鮮過敏」標籤,那尾透抽會跟著蝦一起被判死刑。結果是你多買一份食材,冰箱裡的透抽繼續放到爛。精準排除需要結構化的分類,crustacean 擋掉、mollusk 放行、shellfish 標記待確認,這三個鍵不能混成一個。
最後一列則是我認為 Eat-Cost Balance 真正的形狀:安全跟不浪費不是二選一。今天不能吃它,不等於今天不必處理它。一個只會避開過敏原的 AI 只做完一半,那包蝦的下場才是 Waste 那一欄的分數。
這題會同時考 hard_ok、leftover_hit 跟 inventory_clearance,是整份考卷裡唯一無法靠運氣過關的一題。
| 可存(v1) | 不存(v1) |
|---|---|
| 過敏原、不吃的東西 | 病歷、用藥 |
| 當日步數摘要、活動量級(低/中/高) | 連續心率、睡眠原始序列 |
| 體重、體脂的摘要與趨勢 | 逐筆歷史全部餵給模型 |
| 餐點與冰箱照片(私人空間) | 拿照片去公開訓練 |
原則是模型只看到編譯過的當日情境,不是整個人生資料庫。權限實作會落在 Part 3 的 Security Rules,那天我會用模擬器證明「我讀不到你的過敏」。
這張表其實就是整個系列的架構草圖。核心主張只有一句:不是所有事都該丟給 LLM。
| 決策 | 由誰負責 | 為什麼 | 何時實作 |
|---|---|---|---|
| 這個食材能不能碰(過敏/素食) | 規則程式 | 確定性的事不投票 | Part 4 |
| 預算與時間上限 | 規則程式 | 超了就是做不到 | Part 4 |
| 這張照片是排骨還是雞腿 | 模型 + 人確認 | 模型會很有自信地錯 | Part 2 |
| 今晚怎麼組合、步驟怎麼排 | 模型 | 這是它真正擅長的 | Part 2 起,Part 4 後半成 Agent |
| 昨天吃了什麼、冰箱剩多少 | 資料庫 | 聊天視窗不是記憶體 | Part 3 |
| 好不好吃、今天想不想開火 | 人 | 這輪不到 AI 決定 | 全程 |
畫成流程大概是這樣,模型只出現在中間那一段:
[Firestore 庫存/歷史]
   ↓
[Rule Engine]  ── 程式:把過敏、預算、設備編譯成硬限制
   ↓
[候選過濾]  ── 程式:違規的菜在這裡就被移出,不進模型
   ↓
[Gemini]  ── 模型:組合、排步驟、講理由
   ↓
[Verifier]  ── 程式:再驗一次,違規就退回重生
   ↓
[2~3 個方案] → [實煮] → 扣庫存、剩料回寫 → 回到最上面那一格
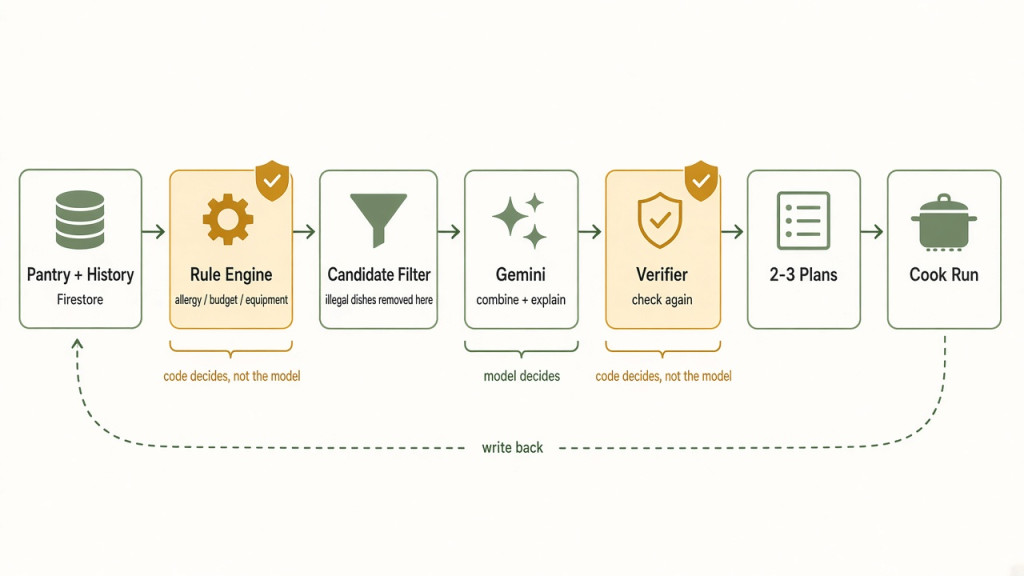
圖:硬限制在進模型前就編譯完,模型負責組合與解釋,出來還要再驗一次。最右邊那條虛線是最容易被忽略的一段。
這個架構有個名字,叫 Verifier-Gated Tool Use Agent。3.5 會說為什麼選它。
Day 0 喊了 Eat-Cost Balance,喊完就得負責。所以每個指標都要能對回這個口號的某一邊,不然它只是一句文案:
| Eat-Cost Balance 的哪一邊 | 對應指標 |
|---|---|
| Eat:還想吃得像樣 | balance_response、美味分(僅參考) |
| Cost:錢、時間、心力扛得住 | budget_ok、time_ok、實際完成率 |
| Waste:少浪費 | leftover_hit、ingredient_reuse_rate、inventory_clearance、chain_hit |
| 底線:不准犯規 | hard_ok、no_hallucination、parsed_ok |
每個情境、每個方法先打 0/1,再平均成率。算法今天就公開,避免最後一天自己改考卷:
| 指標 | 通過(=1)的條件 |
|---|---|
hard_ok |
沒有出現過敏原或禁食食材;沒有需要不存在的設備 |
budget_ok |
估價(含需購買的品項)≤ 預算上限 |
time_ok |
估時 ≤ 時間上限,且估時要符合單爐口的先後順序 |
no_hallucination |
用到的食材屬於庫存,或誠實列在「需要購買」 |
leftover_hit |
有快過期食材時,至少一個方案真的用到它 |
balance_response |
有近幾日飲食訊號時,方案有往互補方向調整 |
goal_consistency |
宣告的目標(偏好蛋白、少油炸)與預算、時間同時被滿足,不是只顧一個 |
parsed_ok |
輸出能穩定解析成約定格式 |
另外兩個只有真的下鍋才有:時間誤差(估時 vs 計時器)跟實際完成率(說能煮的,我真的煮完幾道)。後者回應 Day 0 那條契約,AI 說能煮,就真的煮。
還有三個要跨天才看得出來,我認為這才是 Agent 真正的價值:
| 指標 | 怎麼算 |
|---|---|
ingredient_reuse_rate |
三天內被兩餐以上用到的食材品項 ÷ 總品項 |
inventory_clearance |
期末「沒過期就被吃掉」的品項 ÷ 期初品項 |
chain_hit |
這一餐有沒有用到前一餐的剩料或半成品(煉出來的蝦油、多煮的咖哩) |
這三個 A 幾乎不可能拿分。不是因為它笨,是因為它沒有昨天。
最後一個指標不是 0/1,而是整個系列的主角:資料完整性 completeness,也就是這個方法到底掌握了多少 LifeFlow。它按天算分:
day_score = 0.3×庫存 + 0.3×餐點tags + 0.2×習慣(預算/時間/通路) + 0.1×身體 + 0.1×tip_card
(該欄位當天有效 = 1,沒有 = 0)

completeness = 最近 N 天 day_score 的平均 × (實際有記錄天數 ÷ N),N 預設 7
主勝利條件先講死,Day 29 不准換:
completeness 與 balance_response 明顯高於 B2,也就是 B 的上限,不是那個隨手貼的版本hard_ok、no_hallucination 不輸 B2,且明顯優於 A這三條沒同時成立,我就得在 Day 29 寫「這個方向沒有被驗證」。寫得出這句話,前面 29 篇才算誠實。
Day 0 講的是 A/B/C 三欄。真正要動手設計實驗時我發現 B 一層不夠,因為「會寫 Prompt 的人」有兩種,而他們之間的差距可能比 B 跟 C 的差距還大。
| 代號 | 拿到什麼 | 完整性 |
|---|---|---|
| A 直接問 | 一句「晚餐吃什麼、健康一點」 | 0 |
| B1 隨手貼 | 站在冰箱前掃一眼,講得出的主菜級品項+當下需求 | ≤ 0.3 |
| B2 認真貼 | 把 C 當天的完整庫存 JSON 原封不動貼給同一個模型 | ≤ 0.6 |
| C DishFlow Agent | 自己去讀庫存與近幾日摘要、規則先擋、輸出再驗、煮完回寫 | 最高 |
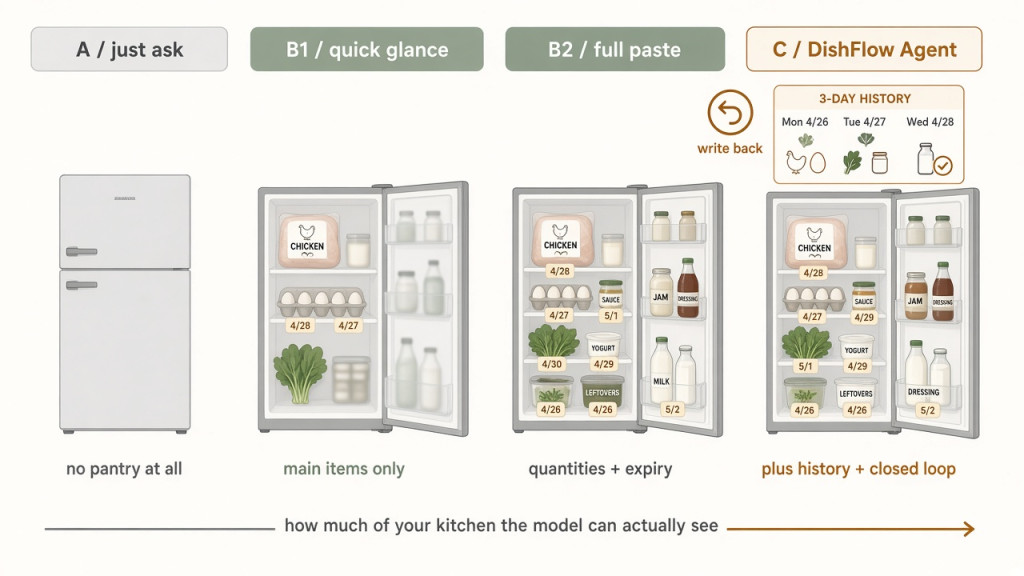
圖:同一個冰箱,四種可見度。差別不在模型,在它看得到什麼。
為什麼要有 B1?因為那才是人真的會打的字。你不會在下班 18:42 打開冰箱,蹲下去把每一盒剩菜翻出來確認效期,再打成三百字貼給 AI。你會說「冰箱好像還有雞肉」。
三種輸入攤開來看差距最清楚:
{
  "A": "晚餐吃什麼?我要健康一點",

  "B1": "冰箱好像還有雞肉、幾顆蛋、一點青菜,給我一個健康的晚餐",

  "B2": {
    "pantry": [
      { "item": "chicken_thigh", "qty": 1, "unit": "pack", "expire_in_days": 2, "use_soon": true },
      { "item": "egg", "qty": 2, "unit": "each" },
      { "item": "tofu", "qty": 0.5, "unit": "box", "expire_in_days": 1, "use_soon": true },
      { "item": "shiitake", "qty": 3, "unit": "slice", "note": "上次煮麵剩的" },
      { "item": "scallion", "qty": 1, "unit": "handful" }
    ],
    "budget": 100, "minutes": 20, "equipment": ["induction_cooktop", "deep_wok"]
  },

  "C": "以上全部,加上近 3 日餐點 tags、hard constraints,以及煮完會回寫的庫存"
}
主菜大家都看得到,邊角料跟效期沒有人記得住。那半盒明天到期的豆腐、上次煮麵剩的三片香菇,不會出現在 B1 的句子裡,因為肉眼掃冰箱本來就掃不到這種東西。但它們正是浪費的來源。
為了不讓我自己偷偷把 B1 寫爛,B1 的輸入有兩條規則:
這樣一跑,成績單會自己分成兩段故事:
| 比較 | 差距代表什麼 |
|---|---|
| B1 → B2 | 資料細不細值多少。也就是為什麼你需要一個會幫你記錄的東西 |
| B2 → C | 規則守門、連續歷史、煮完回寫值多少。也就是為什麼那東西得是 Agent,不只是好 Prompt |
先講清楚一件事,免得被讀成「模型很笨」:B1 表現差不是模型的錯,是它手上的世界不完整。同一個 Gemini 換一份完整的 LifeFlow 就會給出不同答案。這正是 Day 0 的立場,問題從來不是模型不夠強,是它不認識你的生活。
同樣的邏輯適用於我的私人菜譜庫。我手上有一批自己煮過、有照片、有計時的菜,會結構化成候選菜池。這是使用者累積出來的資產,不是我偷偷餵給 C 的答案,所以同一份菜池也會貼給 B2 跑一輪。這批菜的食材重疊度很高,雞肉、蛋、洋蔥、番茄反覆出現,那不是巧合,是真實家庭採購的樣子。前面那三個跨天指標,量的就是能不能把這種重疊變成不浪費。
會記,1 到 5 分,但不當主要勝負。
理由很現實:A 常常靠幻想食材贏得漂亮。它推的菜我家沒有材料。
路線圖用 Part 切,不逐日綁死。每個 Part 一定交出一個可驗證的產物,但實作跟實煮都會有意外,天數在區間內微調。
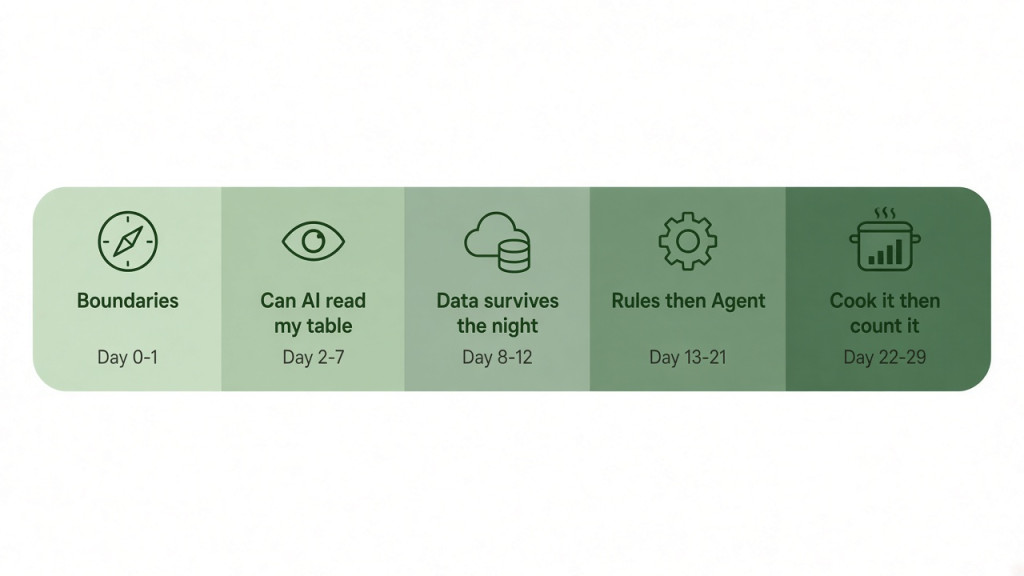
| Part | 大約 | 要解決的問題 | 可驗證產物 | Google/Agent 何時上場 |
|---|---|---|---|---|
| P1 世界觀與邊界 | Day 0–1 | 這是什麼問題、什麼絕對不做 | 邊界圖+指標契約 | 刻意不用工具 |
| P2 AI 看得懂餐桌嗎 | ~Day 2–7 | Gemini 看不看得懂便當與冰箱 | LifeFlow Context v1+Taiwan Meal Benchmark | 第一次動 Google AI:AI Studio、Gemini Vision、Structured Output |
| P3 讓資料活過隔天 | ~Day 8–12 | 記憶、權限、照片、能不能連續記 | 可登入、可連記的 MVP | 第一次上雲:Firebase(Auth/Firestore/Rules/Storage/App Check)+Stitch、Antigravity |
| P4 策略與 Agent | ~Day 13–21 | 硬限制怎麼守、Agent 能不能自己拿資料並講出理由 | Strategy Stack+DishFlow Agent v1+證據鏈 | 先自己寫 Rule Engine,再上 Gemini Function Calling |
| P5 真的煮+用數字結案 | ~Day 22–29 | 說能煮真的煮得出來嗎?比直接問好嗎 | Reality Benchmark+A/B1/B2/C Scoreboard | 四種呼叫模式跑同一批題目 |
只切五段是刻意的,切太細會誤導大家~!! 
記不住主線。五段剛好能用一句話講完:
P2 先讓 AI 看懂餐桌,P3 讓資料活過隔天,P4 先寫規則再讓它變成 Agent,P5 真的下鍋、用數字說話。
如果某個 Part 提前完成,多出來的篇數會補到 P5,多跑幾次實煮、多測幾個刁鑽情境,不會拿去硬塞新服務。這條回應 Day 0 的「不為集郵上雲」。
Agent 的設計模式很多,ReAct、Router、Planner-Executor、Multi-Agent 都有人在用。DishFlow v1 選的組合是:
Tool Use Agent    模型自己去拿庫存、當日條件、近幾日摘要
      +
Verifier-Gated    硬限制在進模型前編譯,出模型後再驗一次
      +
結構化記憶        連續的庫存與餐點紀錄,不是靠聊天視窗記得
為什麼 v1 不做向量資料庫、不做經典 RAG?
因為我的核心問題不是「找出語意最相似的食譜」,而是這個:
半盒豆腐、100 塊、20 分鐘、只有微波爐、對蝦過敏。哪些方案根本不合格?
這是約束滿足與過濾問題,用結構化資料跟規則做才準。向量近似檢索會讓「有沒有違反過敏」變成機率問題,到最後連分數都算不清楚。
未來要接大型食譜知識庫,做法也會是先檢索出候選,然後照樣過 Rule Engine。向量可以擴充靈感,不能取代門禁。
Multi-Agent 同理,能拆的時候再拆,例如辨識、規劃、驗證各自獨立。第一版先讓一個 Agent 把工具用好,比一次生五個 Agent 互相甩鍋實在。
邊界是不是真的硬,用三句話壓測:
| 壓測句 | 系統應該怎樣 |
|---|---|
| 「你體脂 22%,今晚只能吃水煮雞。」 | 拒絕產出這類指令,這是醫療判斷 |
| 「雖然對蝦過敏,一點點應該還好。」 | 規則在進模型前就擋掉,不給模型斟酌空間 |
| 「五個朋友試用過,證明全台灣都需要。」 | Part 5 禁止這種句子,樣本小就誠實寫 N 有多小 |
今天也開始做一件很不性感、但決定 C 成敗的事:連續記錄。
每天只記四塊,庫存、今天吃了什麼(粗標籤就好)、今天的預算與時間與通路、一句提示。
「記錄」長什麼樣子,我用自己的廚房示範。這是某天下班後攤在流理臺上的東西:
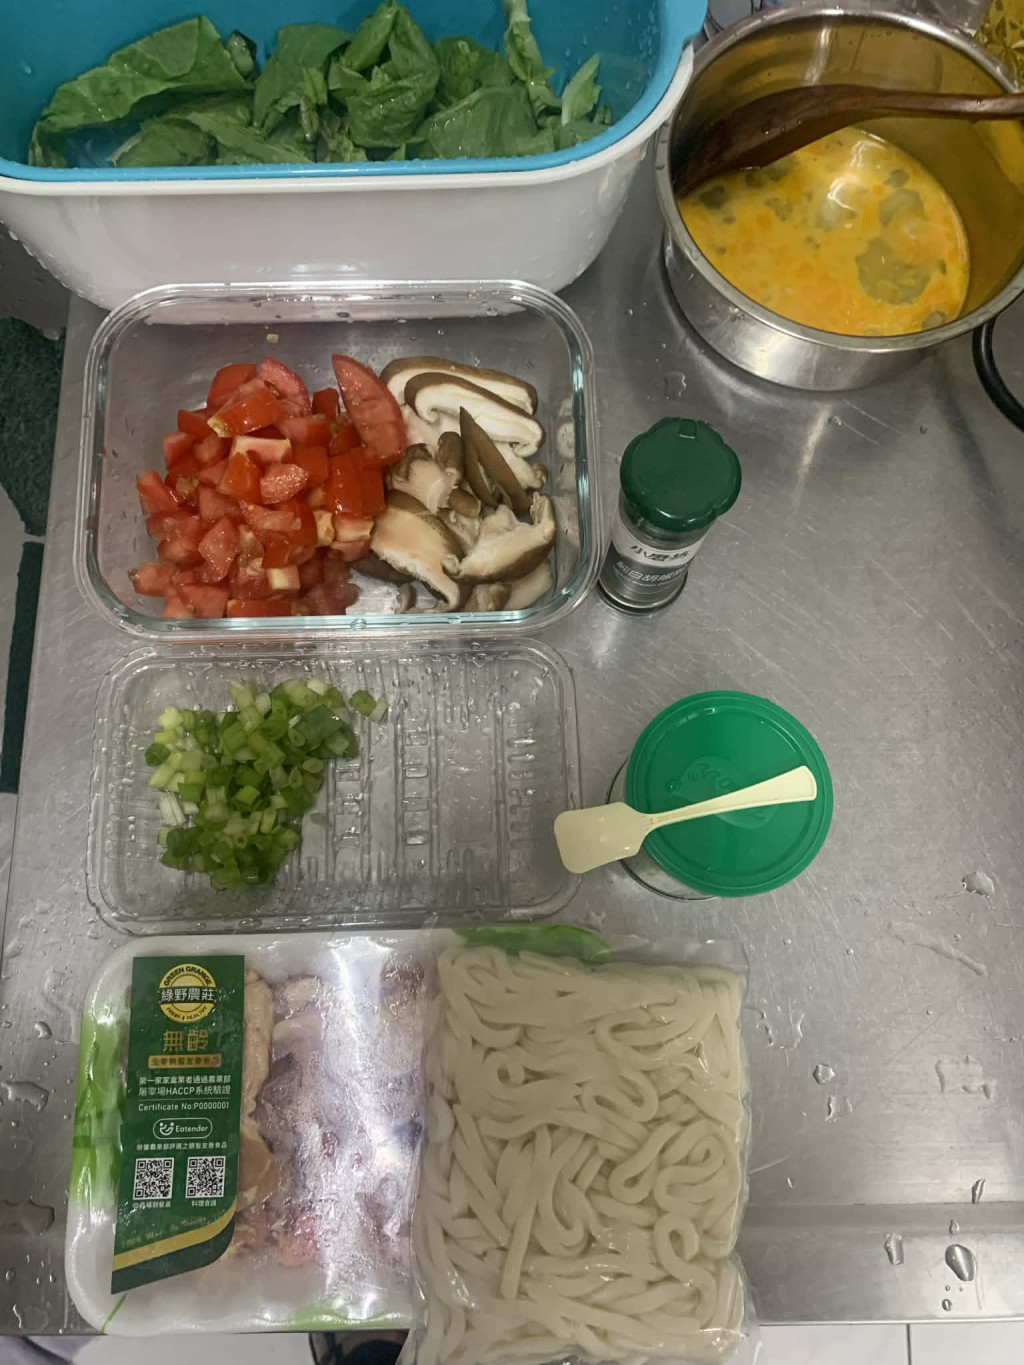
圖:一盒青菜、一碗蛋液、一盒番茄與香菇、一撮蔥花、一包雞腿肉、一包烏龍麵。
注意我怎麼描述它的:一盒、一撮、一包。
這就是我不精算公克的理由。現實中沒有人會把香菇倒上電子秤,那台秤買回來第三天就會被推到角落。所以單位一律用生活量詞,雞肉「一包」、豆腐「半盒」、牛奶「200 ml」。人記得住才記得久,記得久才有連續資料。這些東西怎麼存成 JSON、模型怎麼把「一撮」換算成可比較的量,是下一篇的主題。
然後是同一份材料的結局:
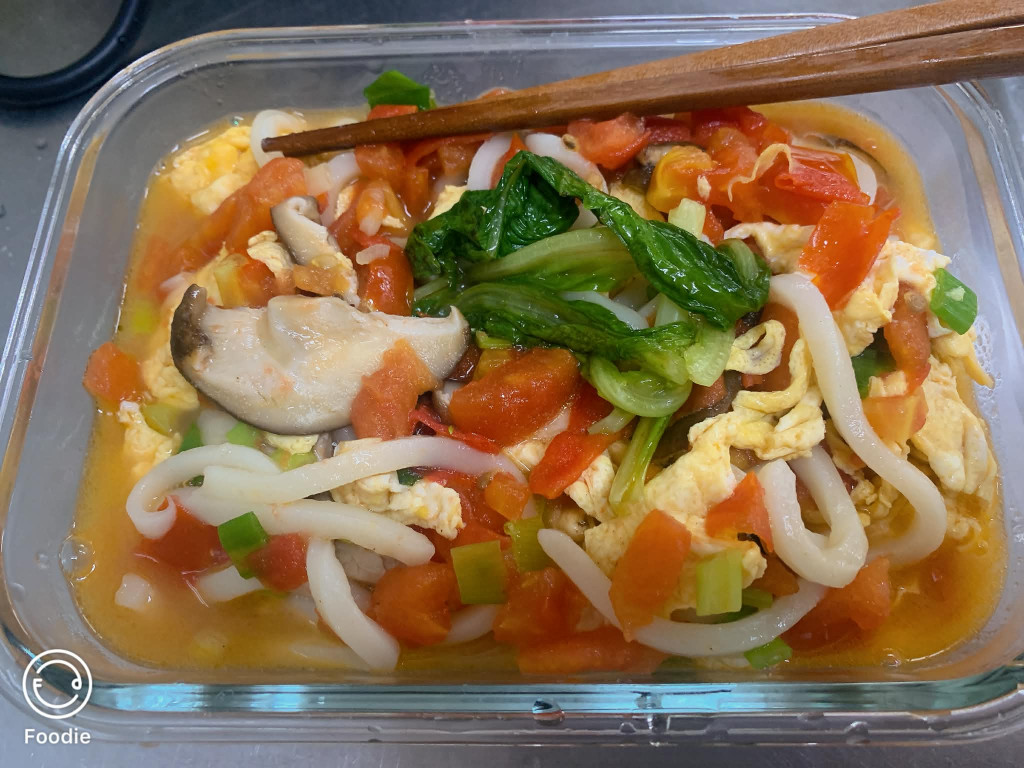
圖:不到半小時後的樣子。從備料到成品到扣庫存,這一圈走完才叫一次完整記錄。
這兩張照片在講一件比「我會煮飯」更重要的事:Outflow。
Day 0 把消費端的 Flow 拆成 Inflow(盤點)、Onflow(規畫)、Outflow(煮完扣庫存、剩料有沒有真的被吃掉)。前兩段大家都會做,第三段才是分水嶺。那半盒沒用完的香菇、剩下的半顆番茄要回寫進庫存,變成明天的候選食材。A、B1、B2 都沒有這一步,你問完就結束了,它永遠不知道你鍋裡剩什麼。
記錄期間我會刻意製造幾天「限制變嚴」的日子:只有 15 分鐘、只剩微波爐可用(就是 Persona B 的處境),還有冰箱裡同時放著蝦跟透抽的那一天,因為 2.3 那道難題需要素材。這些日子會被留下來當 Golden 題,四種方法都得回答同一道難題,而不是只比風和日麗的星期三。
翻車預告:連續記錄這件事第 3 天就會想放棄。所以 Part 3 一定要有「相機壞了也能手動輸入」的後門,不然記錄一斷,C 的完整性直接歸零。
下一篇(P2 開始): 在問 Gemini 之前,先把人生收成 JSON。包含「半盒豆腐」跟「上次剩的三片香菇」這種東西到底該怎麼存。


 iThome鐵人賽
 看影片追技術