
Part 2|第 3/30 篇
今日要做的事: 定稿 LifeFlow Context v1(profile、pantry、daily、粗單位 enum),並在 AI Studio 實跑一次「冰箱文字 → JSON」。
今天要解決的目的: 沒有同一組欄位,就沒有 Day 1 說的 completeness。B1 跟 C 的差距,也從今天開始變成存得下來的東西。
Day 1 結尾說了:在問 Gemini 之前,先把「半盒豆腐」跟「上次剩的三片香菇」收成 JSON。
今天就做這件事。還沒有 Vision、還沒有 Firebase 專案,只有欄位、單位,跟一條 normalize 規則。
| 項目 | 內容 |
|---|---|
| 產出 | Context schema v1、單位詞彙表、Firestore 路徑草圖、文字→JSON 一輪實驗 |
| 工具 | 編輯器;Google AI Studio 直接輸入(Gemini 3.1 Pro Preview 試 parser) |
| 不使用 | 正式 Firebase 專案、Auth、Security Rules;路徑先畫在紙上 |
| 人工素材 | Firestore 樹狀圖;AI Studio 設定、schema、System instructions、實跑結果四張截圖 |
| 對應最終指標 | completeness、parsed_ok、no_hallucination,也是 B1→B2 差異的資料底座 |
這步該直接輸入還是上雲? 直接輸入就夠。
Schema 是契約,不是雲端服務。今天要驗證的是「模型能不能把生活話收進 enum」,不是「我有沒有成功開出一筆 Google Cloud 帳單」。能在 AI Studio 跑通的 parser,Part 3 再搬進 Firestore。
Day 0 打開冰箱看到半盒豆腐。Day 1 拍備料照時,我寫的是「一盒」「一撮」「一包」。
如果每天把這種句子原封不動貼給模型,第二天欄位就開始飄:
| 同一樣東西 | 昨天寫 | 今天模型可能回 |
|---|---|---|
| 豆腐 | 半盒 | 150g |
| 香菇 | 上次剩的三片 | 一些香菇 |
| 雞胸 | 一個拳頭 | 200 公克去皮雞胸 |
B1 只跑單日還撐得住,因為你記得自己剛打了什麼。C 要連記 7 天,還要算 Day 1 那條公式:
day_score = 0.3×庫存 + 0.3×餐點tags + 0.2×習慣 + 0.1×身體 + 0.1×tip_card
completeness = 平均 × (有記天數 ÷ N)
欄位沒鎖死的話,庫存那格分數表面上拿到了,真的要扣庫存時全錯。
沒有 schema 就沒有完整性分數;沒有完整性分數,A/B1/B2/C 那張表最後只是感覺。
還有一件事順便講清楚。B2 之所以叫「認真貼」,是因為它貼得出完整的庫存 JSON。那份 JSON 從哪來?就是今天定的這組欄位。C 比 B2 多的是歷史、規則、跟煮完回寫,不是多一套魔法單位。
長期的、當天的、這一次推薦的,混在同一個 Prompt 裡,隔天一定對不齊。v1 先切四層:
profile          過敏、廚具、預設預算、策略預設。很少改
pantry_items     庫存(粗單位)。每煮一餐就會動
daily/{date}     今日餐、session、tip_card。一天一份
requests/{id}    組裝後的 snapshot。評測用,事後可重跑
對應到之後的 Firestore,長這樣:
users/{uid}
  ├── profile/main
  ├── pantry_items/{itemId}
  ├── body_metrics/{yyyy-mm-dd}
  ├── daily/{yyyy-mm-dd}
  ├── requests/{requestId}
  └── cook_runs/{runId}          ← Day 1 講的 Outflow 回寫落點
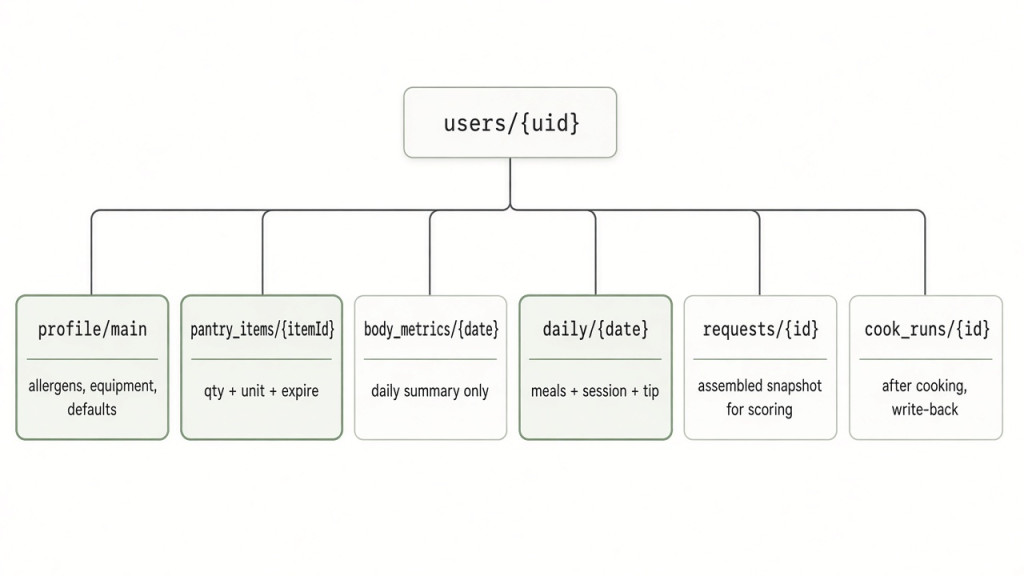
圖:全部掛在 users/{uid} 底下。今天只定形狀,Part 3 才真的開專案。
cook_runs 今天可以先空著,但路徑要留。Day 1 說 A、B1、B2 都沒有 Outflow;C 要扣庫存、把剩料變成明天的候選,寫回的地方就是這裡。
Day 1 已經講過理由:電子秤買回來第三天就會被推到角落。v1 的目標是「人記得住、程式比對得了、模型讀得懂」,不是營養標示等級的公克。
允許的 unit:
| unit | 什麼時候用 | 例子 |
|---|---|---|
each |
論顆、個、條 | 蛋 2、香蕉 1、雞腿 1 |
piece / slice |
切開後的一塊或一片 | 香菇 3 slice、吐司 2 piece |
box / pack / bag |
包裝單位 | 豆腐 0.5 box、火鍋料 1 pack |
bunch |
一把青菜 | 青江菜 1 bunch |
handful |
一把、一撮 | 蔥花 1 handful |
fist |
一個拳頭大的體積 | 切丁雞胸 1 fist |
palm |
一個掌心厚薄的肉片 | 雞胸片 1 palm |
cup / tbsp / tsp |
家用量杯與調味 | 米 0.5 cup、醬油 1 tbsp |
ml |
液體優先 | 牛奶 200 ml |
portion |
實在分不清 | 剩菜 1 portion |
同一食材在庫存裡鎖定一種主單位。今天用 box 記豆腐,明天不要改成 piece、後天又寫 g。那樣表面上 completeness 還在加分,實際扣庫存會錯。
每筆數量固定這個形狀:
{
  "name": "豆腐",
  "qty": 0.5,
  "unit": "box",
  "qty_text": "半盒",
  "approx": true
}
| 欄位 | 用途 |
|---|---|
qty + unit |
機器比對、扣庫存 |
qty_text |
給人看,保留語音或手打的原文 |
approx: true |
永遠假設是約量,不要假裝精準 |
Day 1 把廚房寫死了:單口電磁爐、深炒鍋、玉子燒鍋、微波爐,沒有烤箱、沒有氣炸鍋、沒有蒸籠、沒有第二個爐口。
這種東西不能每次憑印象打在 Prompt 裡,理由很簡單:忘記打的那一天,模型就會發明一台蒸籠出來救時間。之後 time_ok 跟 hard_ok 都要讀這段,所以它得是固定欄位(完整 JSON 在 3.1)。
過敏原同理,而且要分細。Day 1 那道蝦過敏題的重點就在這裡:crustacean、mollusk、shellfish 要分開存。混成一個「海鮮」標籤,那尾透抽會跟著蝦一起被封殺,你反而多買一份食材。
選型 Day 1 的 3.5 講過了,今天補「跟 schema 有什麼關係」。
選 Gemini: 後面立刻要做 Vision(便當、冰箱)、Structured Output(鎖 JSON)、Function Calling(Agent 自己去拿庫存)。同一條產品線接得上去,今天不必比價十家模型。選型是為了 Vision、JSON、Tools 這三件事,不是為了品牌好看。
不上向量庫: 核心問題不是「語意最像哪道食譜」,而是「這半盒豆腐、100 塊、20 分鐘、單口電磁爐、對蝦過敏,哪些方案根本不合格」。那是約束過濾,用結構化欄位加規則做才準。向量近似會讓「有沒有踩到過敏」變成機率問題,最後連分數都算不清。
順序照 2.1 的四層走:先寫很少改的 profile,再寫每天會動的庫存與當日紀錄,最後把它丟進 AI Studio 實跑。
2.3 說的設備與過敏,就住在這裡:
{
  "display_name": "自煮者",
  "goals": {
    "primary": "reduce_decision_fatigue",
    "secondary": ["less_food_waste", "budget_control"],
    "notes": "平日不想洗很多鍋"
  },
  "hard_constraints": {
    "allergens": [],
    "forbidden_ingredients": [],
    "diet_tags": []
  },
  "kitchen": {
    "equipment": [
      "induction_cooktop",
      "deep_wok",
      "tamagoyaki_pan",
      "microwave"
    ],
    "burners": 1,
    "max_pots_willing": 2,
    "servings_default": "1-2"
  },
  "defaults": {
    "typical_budget_twd": 100,
    "typical_time_minutes": 20,
    "preferred_food_sources": ["home", "convenience_store", "supermarket", "eat_out"]
  }
}
burners: 1 這一格看起來很小,但它是 Day 1 那句「一邊燉咖哩一邊煎歐姆蛋做不到」的程式版。
Golden 題「朋友對蝦過敏」到來時,我不會去改這份人生檔案,而是在當次 session 疊一層 guest_allergens: ["crustacean"]。朋友走了就拿掉,我自己的 profile 不該被今天的客人污染。
這就是 Day 1 預告過、卻永遠進不了 B1 句子的那些東西:
[
  {
    "name": "豆腐",
    "name_normalized": "tofu",
    "qty": 0.5,
    "unit": "box",
    "qty_text": "半盒",
    "approx": true,
    "location": "fridge",
    "expire_on": "2026-09-18",
    "priority": "use_soon",
    "source": "manual"
  },
  {
    "name": "雞蛋",
    "name_normalized": "egg",
    "qty": 2,
    "unit": "each",
    "qty_text": "兩顆",
    "approx": true,
    "location": "fridge",
    "priority": "normal",
    "source": "manual"
  },
  {
    "name": "香菇",
    "name_normalized": "shiitake",
    "qty": 3,
    "unit": "slice",
    "qty_text": "上次煮麵剩的三片",
    "approx": true,
    "location": "fridge",
    "expire_on": "2026-09-18",
    "priority": "use_soon",
    "source": "manual",
    "note": "leftover_from_udon"
  },
  {
    "name": "青江菜",
    "name_normalized": "bok_choy",
    "qty": 1,
    "unit": "bunch",
    "qty_text": "一把",
    "approx": true,
    "location": "fridge",
    "priority": "normal",
    "source": "manual"
  }
]
priority: use_soon 跟 expire_on 是後面 leftover_hit 的判斷依據。少了這兩格,「有快過期的東西要先吃掉」就變成一句口號。
對齊 Day 1 的 day_score,有記才有分:
{
  "date": "2026-09-17",
  "today_meals": [
    {
      "slot": "lunch",
      "label": "排骨便當",
      "tags": ["fried", "vegetable_low", "protein_present"]
    }
  ],
  "activity_context": {
    "steps": 8000,
    "activity_level": "moderate",
    "source": "manual"
  },
  "session": {
    "budget_twd": 100,
    "available_time_minutes": 20,
    "food_source": "home",
    "active_strategy_ids": ["leftover_first", "budget_cap"]
  },
  "tip_card": "香菇三片明天到期,優先用掉"
}
today_meals 只記粗標籤就好。中午吃了排骨便當,記 fried 跟 vegetable_low 就夠讓晚餐往互補方向走,不必算出那塊排骨幾大卡。
身體數據放 body_metrics/{date},同一天最多一筆,進模型只給 snapshot 加 trend,並帶上 usage_policy: context_only_no_medical_advice。這是 Day 1 那條硬邊界的欄位版:體脂是 Context,不是「今晚只能吃水煮雞」的公式。
流程固定成這樣:
使用者、照片、語音
    → 模型抽出草稿 JSON(可以較自由)
    → normalize_unit() 對到詞彙表
    → schema validate
    →(之後)寫入 Firestore
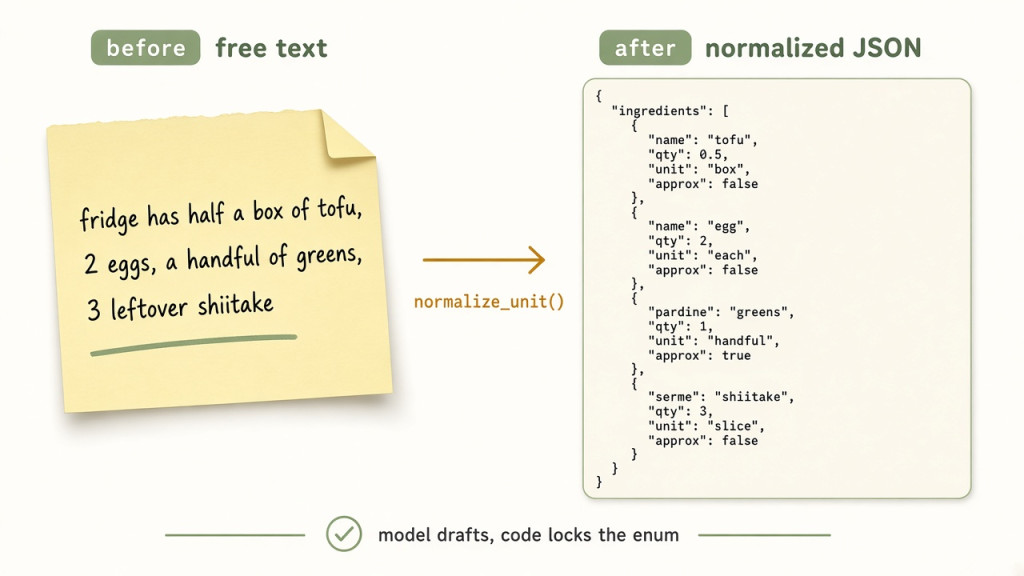
圖:模型負責草稿,程式負責把單位鎖進 enum。Firebase 存得進去,不代表之後扣得動。
今天不只貼一句 Prompt 就算完。我把 Google AI Studio 右側每個設定都打開講一遍,因為鐵人賽有不少讀者是第一次進來,「按鈕在哪、為什麼這樣設」比結論重要。
我先試的是 gemini-3.5-flash-lite。夠快、也做得動這題,但右側面板常常只剩 Thinking level,Temperature 整個不見。換成 Pro 系模型之後它才回來。
所以今天的做法我直說:
| 目的 | 選哪個 |
|---|---|
| 教設定、讓讀者看得到 Temperature | Gemini 3.1 Pro Preview |
| 之後自己大量重跑、想省額度 | 換回 Flash 或 Flash Lite 都沒問題 |
不是「Pro 比較會收冰箱 JSON」。這題靠的是 Structured outputs 的 schema,不是模型智商。挑 Pro 只是為了把設定面板講完整。
另外提一下:我有 Google AI Pro 訂閱,它主要提高 AI Studio 網頁端 的額度與可選模型,跟「要不要綁 Cloud 付費 API key」是兩件事。今天全程在 Playground 手動跑,跳出 Link a paid API key 直接關掉就好。
進 aistudio.google.com,左側選 Playground。今天的重點都在右邊 Run settings:模型、System instructions、Temperature、Thinking level,還有一排 Tools 開關。
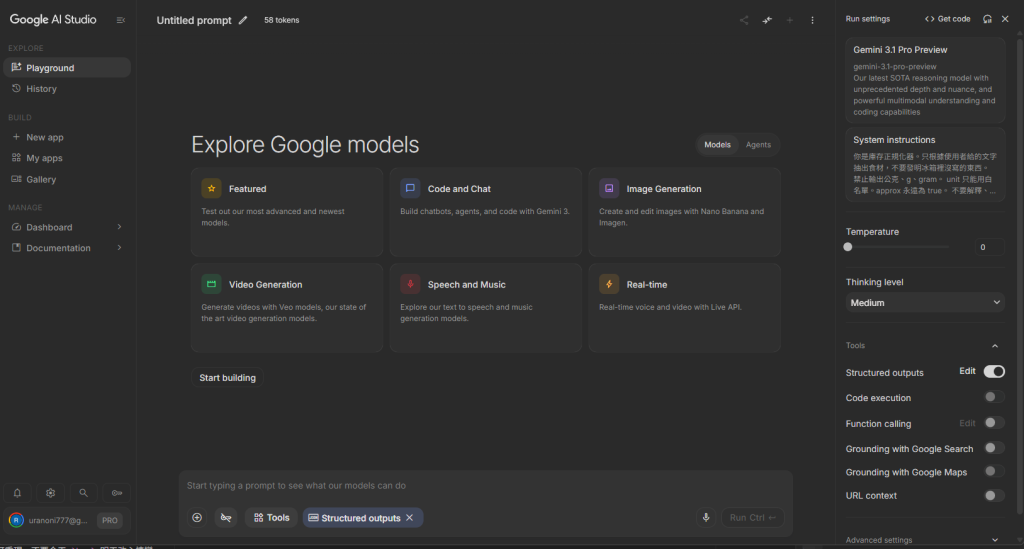
圖:今天的設定面板。Model 是 Gemini 3.1 Pro Preview、Temperature 拉到 0、Thinking level 選 Medium、Structured outputs 打開,Search 與 Code 與 Function 全關。下方輸入框那顆藍色標籤代表 schema 已經生效。
把上面那張圖的右側拆開講。記住一句就好:這題要穩,不要創意。
Model:Gemini 3.1 Pro Preview
選哪顆大腦。Flash 像速食店窗口,Pro 像願意多看一眼菜單的店員。今天挑 Pro 主要是面板比較完整,順便讓示範好看一點。之後正式 pipeline 換回 Flash 也行,schema 對的話兩邊都該過。
System instructions:系統指令
這格不是「再寫一次 Prompt」,比較像給模型掛一張工作證:你是誰、什麼不准做,整場對話都生效。使用者每次輸入就專心講冰箱裡有什麼,不必每次重念一遍「不准公克」。
我把它存成一組叫「格式化輸出食物文字」的指令:
你是庫存正規化器。只根據使用者給的文字抽出食材,不要發明冰箱裡沒寫的東西。
禁止輸出公克、g、gram。
unit 只能用白名單。approx 永遠為 true。
不要解釋、不要 markdown。
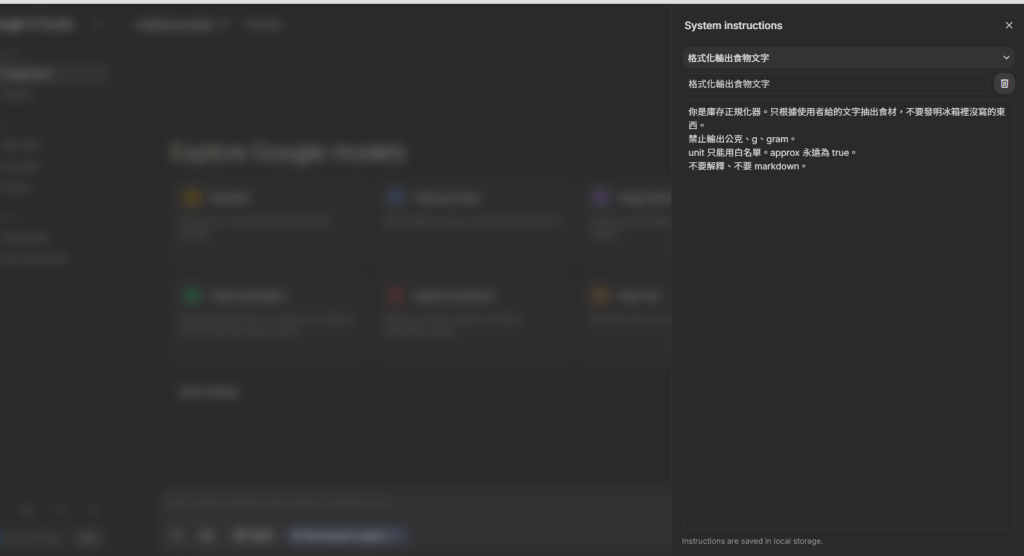
圖:工作證掛好。注意最底下那行 Instructions are saved in local storage,換瀏覽器或清快取就可能不見,重要指令建議另外存一份進專案裡。
為什麼要特別寫「不要發明」?因為模型很愛幫忙。你寫「兩顆蛋」,它有時候會順手加一筆「建議的鹽」進庫存。庫存系統最怕這種好心生出來的幽靈食材。
Temperature:設 0
這個設定最常被講成「創意開關」,我比較喜歡想成「今天要不要擲骰子」。
| 數值 | 體感 |
|---|---|
| 接近 0 | 同一題跑幾次,答案長得差不多。適合抽欄位、填表、產出要進資料庫的東西 |
| 拉高到 0.7~1 | 開始發揮、換說法、偶爾加戲。適合寫文案,不適合扣庫存 |
庫存 JSON 要的是可重現,不要今天寫 box、明天心情好改成 portion。所以直接設成 0。
不過講清楚:Temperature 0 不等於正確率 100%。 它只是比較不亂發揮。該漏的香菇還是可能漏,所以後面才需要 schema 跟人工三條驗收。
Thinking level:選 Medium
有的模型會先想一下再答,介面上會出現一塊可以展開的 Thoughts。這題本質是填表,不是證明費馬最後定理。
| 檔位 | 什麼時候用 |
|---|---|
| Minimal 或 Low | 大量重跑、純格式題、想省額度 |
| Medium | 規則有點多,又想看它有沒有讀懂「剩的三片」。我今天用這個 |
| High | 留給真的要推理的題。庫存 parser 開這麼高只是燒額度 |
截圖裡模型確實回了一塊 Thoughts,代表它有先想過一輪。正式產品如果在意反應速度跟成本,記得回來調低。
Structured outputs:打開
這是今天真正的主角。以前我們只能在 Prompt 裡寫「請輸出 JSON」,模型有時還是會先寒暄兩句,再給你半份 markdown。Structured outputs 是把 OpenAPI/JSON Schema 交給 Studio,輸出形狀由合約保證,不是靠拜託。
其他 Tools 為什麼全關
| 開關 | 今天 | 原因 |
|---|---|---|
| Grounding with Google Search | 關 | 我冰箱裡有什麼,不該去搜尋引擎找答案 |
| Code execution | 關 | 不需要它幫我算「0.5 盒是多少」 |
| Function calling | 關 | 那是 Part 4 讓 Agent 自己去讀 Firestore 的事,今天別提前開 |
| URL context、Maps | 關 | 跟庫存無關就別開,少一個變因 |
一句偷懶口訣:用不到的能力,預設當噪音關掉。
點 Structured outputs 旁邊的 Edit,切到 Code Editor,把預設的 response: string 刪掉,改貼我們的合約:
{
  "type": "object",
  "properties": {
    "items": {
      "type": "array",
      "items": {
        "type": "object",
        "properties": {
          "name": { "type": "string" },
          "qty": { "type": "number" },
          "unit": {
            "type": "string",
            "enum": [
              "each", "piece", "slice", "box", "pack", "bag",
              "bunch", "handful", "fist", "palm",
              "cup", "tbsp", "tsp", "ml", "portion"
            ]
          },
          "qty_text": { "type": "string" },
          "approx": { "type": "boolean" },
          "expire_hint": {
            "type": "string",
            "description": "若文字有提到到期或快壞就填,否則空字串"
          },
          "note": {
            "type": "string",
            "description": "剩料來源等補充,沒有就空字串"
          }
        },
        "required": ["name", "qty", "unit", "qty_text", "approx"]
      }
    }
  },
  "required": ["items"]
}
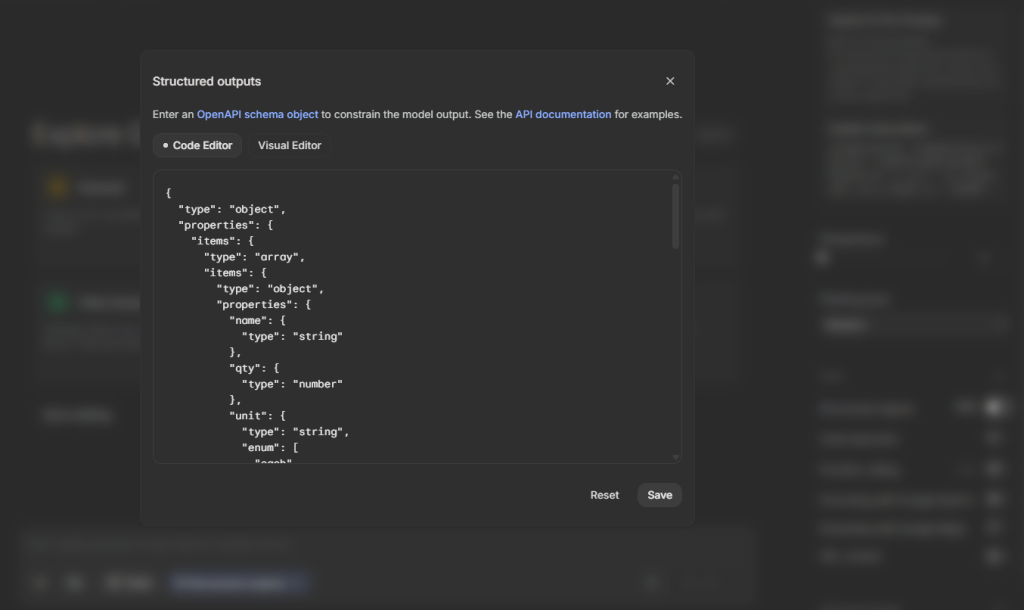
圖:重點在 unit 的 enum。模型再想輸出公克,也會被這份名單擋在門外,比在 Prompt 裡寫一百次「拜託不要公克」有效。
按 Save。這一步等於把 Day 1 講的粗單位,第一次變成模型很難違反的輸出合約。
再補一句常被誇大的事:Structured outputs 保證形狀合法,不保證內容正確。 它能逼出一個叫 qty 的 number,但不能保證「上次剩的三片香菇」真的被抽出來。漏東西還是要靠 Prompt 跟人工驗收。
格式已經被 schema 鎖住,Prompt 可以短。重點是把生活量詞對到 enum:
把下面冰箱描述收成 items 陣列。
蔥花「一撮」用 handful;雞腿「一包」用 pack;香菇「三片」用 slice。

文字:
冰箱有半盒豆腐(明天到期)、兩顆蛋、一把青江菜、
上次煮烏龍麵剩的三片香菇、蔥花一撮、雞腿肉一包。
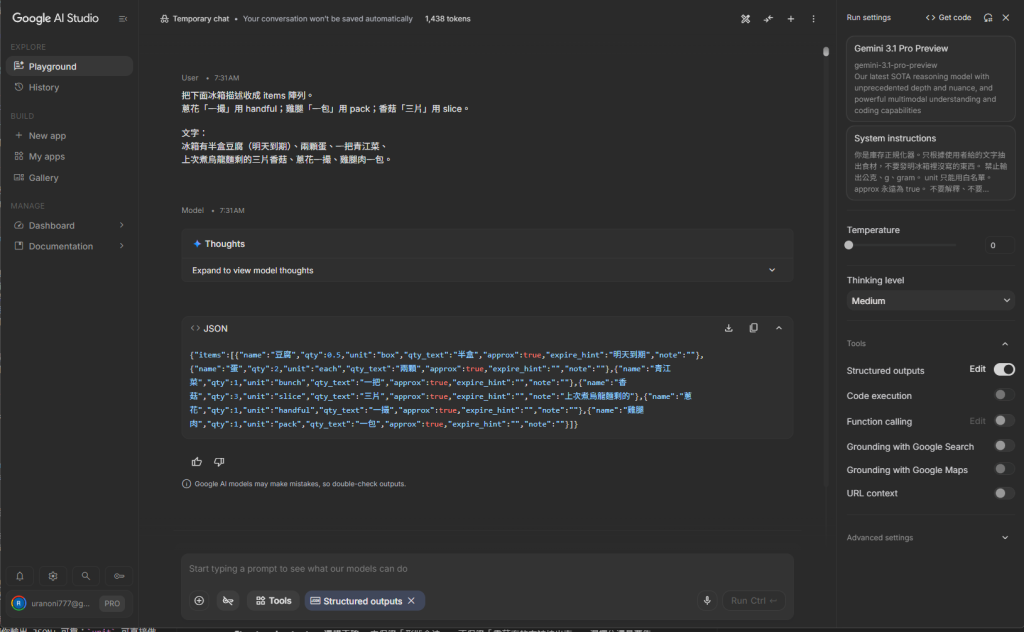
圖:Temporary chat,約 1,438 tokens。右邊設定仍是 Temperature 0、Structured outputs 打開。中間是我貼的 Prompt,下面是模型吐出來的 JSON。
輸出精簡如下,完整六筆在截圖裡:
{
  "items": [
    {
      "name": "豆腐",
      "qty": 0.5,
      "unit": "box",
      "qty_text": "半盒",
      "approx": true,
      "expire_hint": "明天到期",
      "note": ""
    },
    {
      "name": "雞蛋",
      "qty": 2,
      "unit": "each",
      "qty_text": "兩顆",
      "approx": true,
      "expire_hint": "",
      "note": ""
    },
    {
      "name": "青江菜",
      "qty": 1,
      "unit": "bunch",
      "qty_text": "一把",
      "approx": true,
      "expire_hint": "",
      "note": ""
    },
    {
      "name": "香菇",
      "qty": 3,
      "unit": "slice",
      "qty_text": "三片",
      "approx": true,
      "expire_hint": "",
      "note": "上次煮烏龍麵剩的"
    },
    {
      "name": "蔥花",
      "qty": 1,
      "unit": "handful",
      "qty_text": "一撮",
      "approx": true,
      "expire_hint": "",
      "note": ""
    },
    {
      "name": "雞腿肉",
      "qty": 1,
      "unit": "pack",
      "qty_text": "一包",
      "approx": true,
      "expire_hint": "",
      "note": ""
    }
  ]
}
對一下今天的及格線:
| 驗收 | 結果 |
|---|---|
沒有出現 g、gram、公克 |
✅ |
每個 unit 都在白名單 |
✅ box、each、bunch、slice、handful、pack |
三片香菇留下來,note 還寫了來源 |
✅ |
第三條是我最在意的。B1 站在冰箱前只會打出「冰箱好像還有豆腐、蛋、青菜」,上面這份多出來的效期、香菇、qty_text,就是 Day 1 那張成績單開始拉開的地方。
失敗怎麼辦?改 Prompt、收緊 schema、或加一層程式直接拒收。不要為了讓它過關就跑去開 Firebase。工具哲學跟 Day 0、Day 1 同一條:這步用直接輸入驗證就夠。
跑通之後如果在意額度,把 Model 切回 Flash Lite 再跑同一題。schema 正確的話兩邊都該過,差的只是面板上有沒有 Temperature,不是「會不會變成 Agent」。
3.4 只證明了順風的一題。真正要壓的是下面這幾條,我會在接下來幾天連續記錄時故意撞:
| 壓測 | 預期 |
|---|---|
| 要求模型用「克」輸出 | parser 拒絕,或轉成粗單位並強制 approx=true |
同一食材兩天 unit 不同 |
表面上 completeness 有分,扣庫存會錯。鎖單位比多記欄位重要 |
| 把 90 天體重一次塞進 Prompt | 違反「工具不增加困擾」,C 只要摘要 |
| 「一些青菜」「適量香菇」 | 逼成 handful 或 portion,不准留自由字串當 unit |
| 模型省略效期與邊角料 | 這輪算失敗。那正是 B1 會丟掉、C 必須留住的東西 |
翻車預告:第一週你會很想把每樣東西改成公克,因為看起來比較科學。別改。公克一上場,連續記錄的放棄速度會比 Part 3 相機壞掉還快。Day 1 已經預告過第 3 天就會想放棄,單位訂太精只會讓那天提早到來。
completeness 的每一格,都對應今天定下的欄位。qty_text 給人看,unit 給程式扣。下一篇: 第一張台灣便當丟進 AI Studio,看 Vision 會不會裝懂。欄位已經備好,接下來測模型看不看得見餐盤上的東西。


 iThome鐵人賽
 看影片追技術