

昨天把一個 Request 從瀏覽器一路追到 Server,流程大概是:
URL
 ↓
DNS
 ↓
TCP
 ↓
TLS
 ↓
HTTP Request
 ↓
Server
當時對 DNS 的理解其實只有一句話:
DNS 會把
example.com轉換成 Server 的 IP Address。
這個理解沒有錯,但如果把 DNS 放進 System Design 裡,它其實不只是「查 IP」而已。
DNS 本身是一個分散式、階層式的 Naming System,而且中間大量依賴 Cache。實際的大型系統甚至可以透過 DNS 把不同使用者導向不同 Region,或在某個 Region 故障時切換到其他 Endpoint。
所以 Day 3 我想把昨天 Request Flow 裡的第一個重要元件 —— DNS —— 單獨拆開來看。
今天主要想搞懂四件事:
1. DNS Lookup 到底怎麼走?
2. Recursive Resolver、Root、TLD、Authoritative DNS 分別在做什麼?
3. DNS Cache 和 TTL 為什麼重要?
4. DNS 在 System Design 裡如何參與 Traffic Routing?
網路真正用來定位機器的是 IP Address,例如:
93.184.216.34
但正常人不可能每天記:
142.250.xxx.xxx
140.82.xxx.xxx
104.18.xxx.xxx
所以我們會使用:
google.com
github.com
cloudflare.com
DNS(Domain Name System)主要負責把:
Human-readable Domain Name
          ↓
       DNS
          ↓
Machine-readable IP Address
例如:
api.example.com
        ↓
       DNS
        ↓
203.0.113.10
拿到 IP 之後,Client 才知道後面的 TCP Connection 應該連到哪一台 Server。
但 DNS 並不是一台中央 Server 裡面存了全世界所有 Domain。
它是一個階層式、分散式系統。
Cloudflare 的這張圖很適合先建立第一層直覺:使用者記的是 www.example.com,但電腦真正需要的是 IP Address。DNS 就是在中間負責這層名稱解析。

看這張圖時先抓住一件事就好:
www.example.com
        ↓
       DNS
        ↓
IP Address
後面的 Root、TLD、Authoritative DNS,其實都是在回答「這個 Domain 最後應該解析成什麼」這個問題。
先假設所有 Cache 都沒有資料。
當 Browser 想查:
api.example.com
概念上會走:
Browser
   ↓
Recursive Resolver
   ↓
Root Name Server
   ↓
TLD Name Server
   ↓
Authoritative Name Server
   ↓
IP Address
可以把整個流程理解成一連串「問路」。
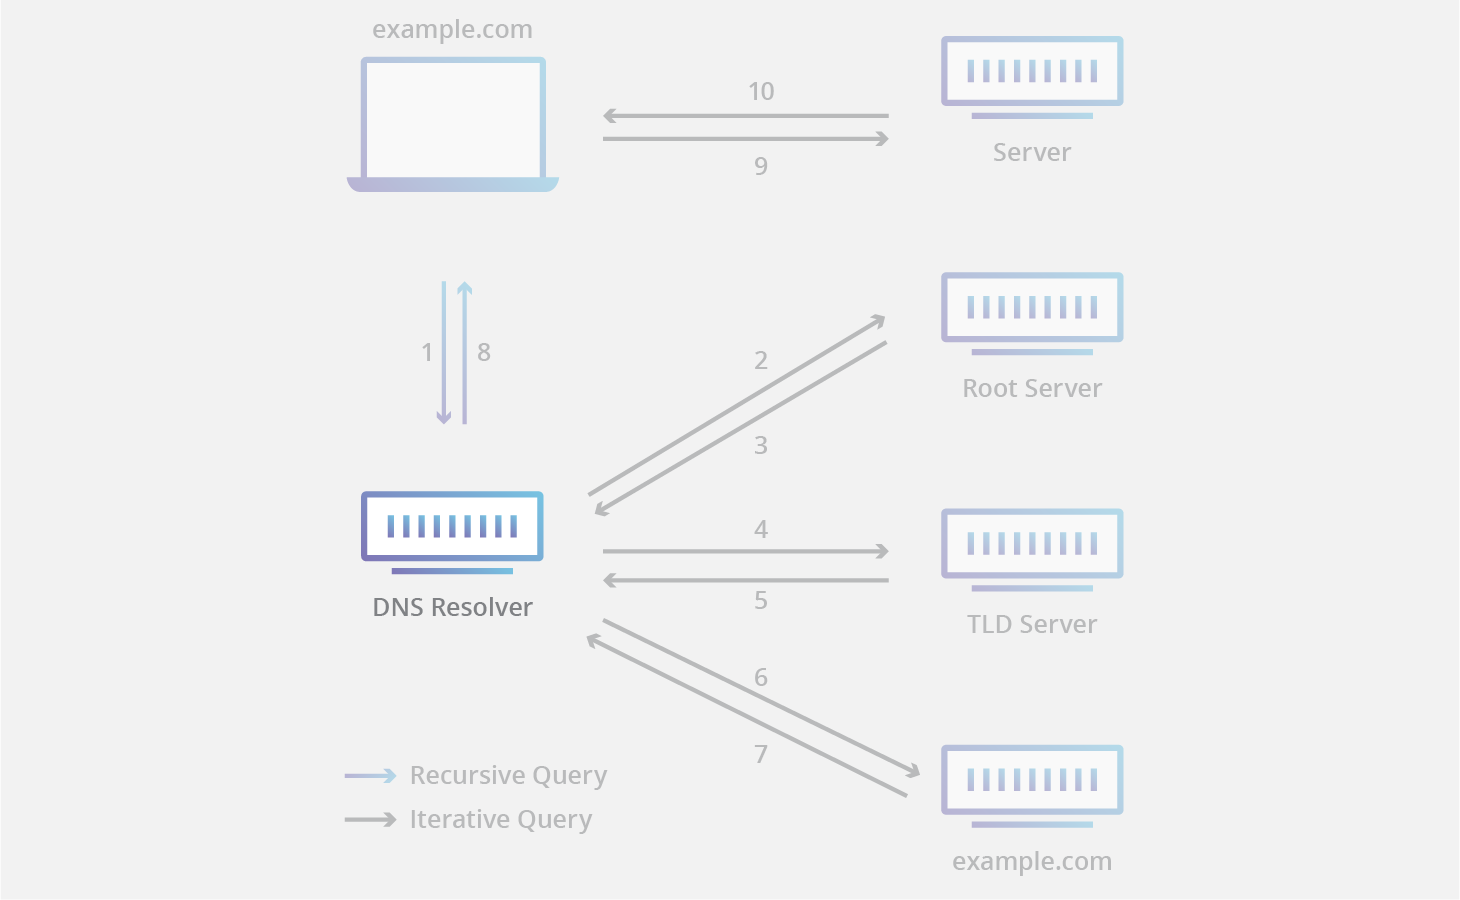
Cloudflare 的這張圖把今天最重要的 DNS Query Flow 畫得很完整:

這張圖可以按照數字看:
1
Browser → DNS Resolver

2~3
Resolver ↔ Root Server

4~5
Resolver ↔ TLD Server

6~7
Resolver ↔ Authoritative Name Server

8
Resolver → Browser

9~10
Browser ↔ Web Server
其中 1~8 是 DNS Resolution;等 Browser 真正拿到 IP 後,9~10 才開始向 Web Server 發 Request。
這張圖也剛好把 Day 2 和 Day 3 串在一起:
DNS Resolution
      ↓
取得 IP Address
      ↓
建立連線
      ↓
HTTP Request
Browser 不會自己去問全世界的 DNS Server。
它通常會把:
api.example.com 的 IP 是多少?
交給 DNS Resolver。
Resolver 可能來自:
1.1.1.1
這個角色很重要,因為:
Resolver 是幫 Client 把答案找回來的人。
如果 Resolver Cache 已經有答案,就可以直接回傳。
如果沒有,才需要繼續往下問。
Cloudflare 的 DNS Server Types 文件把 Resolver 特別標示出來:
這張圖可以注意兩種箭頭:
因此不要把:
Browser
和:
Recursive Resolver
想成同一個角色。
比較接近:
Browser
   ↓
「幫我找 api.example.com」

Recursive Resolver
   ↓
自己一路去問 DNS Hierarchy
   ↓
把最後答案送回 Browser
Recursive Resolver 第一次並不知道:
example.com
到底是哪一台 DNS Server 負責。
所以它會先問 Root Name Server:
「example.com 在哪?」
Root 不會直接告訴它:
example.com = 203.0.113.10
Root 比較像是在說:
「你這是 .com,
去問負責 .com 的 TLD Name Server。」
所以:
Resolver
   ↓
Root
   ↓
.com TLD Server
這是一個「Referral」的概念。
TLD 是 Top-Level Domain,例如:
.com
.org
.net
.tw
.io
現在 Resolver 去問 .com:
example.com 到底誰負責?
TLD Server 還是不一定直接給你最終 IP。
它會告訴 Resolver:
「example.com 的 Authoritative DNS 在這裡。」
流程繼續變成:
Root
 ↓
.com TLD
 ↓
Authoritative DNS
最後 Resolver 來到:
example.com 的 Authoritative Name Server
這台 Server 才真正管理:
api.example.com
www.example.com
mail.example.com
等 DNS Records。
例如它可能回答:
api.example.com
        ↓
A Record
        ↓
203.0.113.10
Resolver 拿到答案後,再把 IP 傳回 Client。
完整流程:
Browser
   │
   │ api.example.com ?
   ▼
Recursive Resolver
   │
   │ example.com ?
   ▼
Root Name Server
   │
   │ 去問 .com
   ▼
.com TLD Name Server
   │
   │ example.com 的 Authoritative DNS 在這
   ▼
Authoritative Name Server
   │
   │ api.example.com = 203.0.113.10
   ▼
Recursive Resolver
   │
   ▼
Browser
接下來 Browser 才能拿:
203.0.113.10
建立後續 TCP / TLS / HTTP Connection。
如果每次開網站都要:
Resolver
 ↓
Root
 ↓
TLD
 ↓
Authoritative DNS
那延遲和 DNS Infrastructure 的負擔都會非常大。
所以 DNS 非常依賴:
Caching
實際上 DNS Cache 可能存在很多地方,例如:
Browser Cache
     ↓
Operating System Cache
     ↓
Recursive Resolver Cache
     ↓
真正進行 DNS Lookup
如果某一層已經有:
example.com → 203.0.113.10
那就不需要再走完整流程。
所以真正的 DNS Lookup 更接近:
Query
 ↓
有 Cache 嗎?
 ├─ Yes → 直接回答
 │
 └─ No
     ↓
   繼續查詢
這也是為什麼平常瀏覽網站時,不會每次都感覺到一整串 DNS Lookup 的成本。
Cache 最大的問題是:
如果 DNS Record 改了,Cache 裡還留著舊資料怎麼辦?
這就是 TTL(Time To Live)要處理的事情。
DNS Record 會有一個 TTL,例如:
api.example.com
A
203.0.113.10

TTL = 300 seconds
意思大致是:
Resolver 可以 Cache 這個答案 300 秒
在 TTL 還沒過期之前:
api.example.com ?
        ↓
Cache Hit
        ↓
203.0.113.10
不用再次問 Authoritative DNS。
如果 TTL 設得很長:
TTL ↑

Cache Hit ↑
DNS Query ↓
Latency ↓
DNS Server Load ↓
看起來很好。
但如果今天 Server IP 改了:
Old IP
203.0.113.10

        ↓ 改成

New IP
203.0.113.20
很多 Resolver 可能還 Cache 著舊 IP。
所以:
TTL 長
 ↓
DNS 更新傳播比較慢
反過來:
TTL 短
 ↓
Record 更新比較快被看到
但是:
Cache Hit ↓
DNS Query ↑
因此 TTL 其實就是:
Performance
     VS
Freshness
這和前面幾天 System Design 一直看到的觀念一樣:
幾乎沒有免費的最佳解,通常都是 Trade-off。
今天不需要把所有 Record Type 全部背起來。
先記最常看到的幾個。
| Record | 用途 |
|---|---|
A |
Domain → IPv4 |
AAAA |
Domain → IPv6 |
CNAME |
Name → 另一個 Name |
NS |
指定負責這個 Domain 的 Name Server |
MX |
指定接收 Email 的 Mail Server |
例如 A Record:
api.example.com
        ↓
203.0.113.10
CNAME 則比較像:
www.example.com
        ↓
example.com
        ↓
A Record
        ↓
203.0.113.10
所以可以先記:
A      = Name → IPv4
AAAA   = Name → IPv6
CNAME  = Name → Name
NS     = Domain → Name Server
這是我覺得 DNS 真正開始和 System Design 接起來的地方。
假設現在服務有三個 Region:
               ┌── US Server
               │
User ── DNS ───┼── Asia Server
               │
               └── Europe Server
DNS 不一定永遠回同一個 IP。
Managed DNS Provider 可以根據 Routing Policy 決定要回哪個 Endpoint。
假設:
Server A
Server B
希望:
A → 90%
B → 10%
可以使用類似 Weighted Routing 的策略。
用途可能包括:
新版本 Deployment
Canary Release
A/B Test
逐步移轉 Traffic
例如:
DNS Query
   ↓
Weighted Policy
   ├── 90% → Version A
   └── 10% → Version B
如果同一個服務部署在:
Tokyo
Singapore
Virginia
Frankfurt
可以根據不同 Endpoint 對使用者的網路延遲,選擇較適合的 Region。
概念:
Taiwan User
     ↓
DNS
     ↓
Asia Region
而不是:
Taiwan User
     ↓
US Server
目的就是降低 Network Latency。
也可以依據使用者所在位置做 Routing。
例如:
Europe User
     ↓
Europe Region

Asia User
     ↓
Asia Region
這不只和效能有關,也可能因為:
Data Residency
Content Licensing
Localization
Compliance
而需要不同路由方式。
到了大型系統裡,DNS 回傳的 Endpoint 不一定永遠相同。AWS Route 53 的 Geoproximity Routing 圖可以很直觀地看到這件事:

圖中的數字代表部署在不同地區的資源,例如:
1 → US West
2 → Europe
3 → Asia Pacific
4 → Africa
5 → Middle East
不同顏色區域表示不同來源位置的 DNS Query,可能被導向不同的 Endpoint。
要注意,這張圖示範的是 Geoproximity Routing,和前面提到的 Geolocation Routing 不完全相同:
Geolocation Routing
→ 根據使用者「位於哪個地理區域」套用規則

Geoproximity Routing
→ 根據使用者與資源的位置接近程度做 Routing
但兩者都能幫助我們建立同一個 System Design Mental Model:
User
 ↓
DNS
 ↓
Routing Decision
 ↓
適合的 Region / Endpoint
這就是 DNS 從單純的「Name → IP」開始進入大型分散式系統設計的地方。
另一個很重要的使用方式是:
Primary Region
     ↓
出問題
     ↓
Secondary Region
例如:
          Normal
User ──→ Region A

Region A unhealthy
        ↓

User ──→ Region B
這就是 Active-Passive 類型的 Failover 思維。
但 DNS Failover 有一個很重要的限制:
DNS 有 Cache。
如果 Resolver 還 Cache 著舊 IP,即使 DNS Provider 已經修改答案,Client 也可能暫時繼續連舊 Endpoint。
這又回到前面的 TTL。
所以 DNS Failover 的反應速度和 TTL 之間,也存在 Trade-off。
看到這裡會發現 DNS 好像也可以把 Traffic 分到不同 Server,那和 Load Balancer 有什麼差別?
先用最簡單的方式理解。
DNS Routing 比較像:
「我要告訴 Client 要去哪裡。」
例如:
api.example.com
       ↓ DNS
203.0.113.10
DNS 回完答案後,Client 就直接去連那個 Endpoint。
Load Balancer 則比較像:
Client
   ↓
Load Balancer
   ↓
Backend A
Backend B
Backend C
Client 的 Request 真的會先到 Load Balancer。
由 Load Balancer 再決定:
這一個 Request
要送去哪一台 Backend?
所以粗略來說:
DNS
↓
Global / Region-level routing

Load Balancer
↓
Request-level backend routing
這不是絕對規則,但可以先建立這個 Mental Model。
而這也正好接到明天的主題:
Load Balancer。
只看文字還是很抽象,所以今天直接用 dig 看。
Mac / Linux 可以試:
dig google.com
接著分別查看不同 Record:
dig google.com A
dig google.com AAAA
dig google.com NS
主要看輸出裡的:
ANSWER SECTION
你可以直接看到:
Domain
 ↓
DNS Record
 ↓
Value
今天最推薦實際跑:
dig +trace example.com
和一般:
dig example.com
最大的不同是 +trace 可以讓你比較直觀地看到 DNS delegation 的查詢鏈。
輸出會很長,不需要每一行都看懂。
先找這個概念就好:
Root
 ↓
.com
 ↓
example.com
 ↓
Final Answer
這正好就是今天學的:
Root Name Server
      ↓
TLD Name Server
      ↓
Authoritative Name Server
現在重新看昨天的 Request Flow:
https://api.example.com/users
Browser 首先需要:
api.example.com
       ↓
DNS
       ↓
IP Address
DNS 裡面又可以拆成:
Browser / OS Cache
        ↓ miss
Recursive Resolver Cache
        ↓ miss
Root
        ↓
TLD
        ↓
Authoritative DNS
        ↓
A / AAAA Record
        ↓
Cache according to TTL
        ↓
IP Address
拿到 IP 之後:
TCP Connection
      ↓
TLS
      ↓
HTTP Request
      ↓
Server
到這裡,昨天那條 Request Flow 就比原本多了一層真正的細節。
今天最重要的不是背 DNS 名詞,而是建立這個 Mental Model:
DNS
=
Distributed Naming System
+
Hierarchy
+
Caching
+
Traffic Routing
需要記住:


 iThome鐵人賽
 看影片追技術