
想像這樣一個早上:一早來公司,打開待核准的 PR 清單,卡片已經排了一長串。點開幾份,都是 Claude Code 協助完成,測試也亮著綠燈。程式交得很快,輪到我核准,壓力卻一下子上來了。
每份都得找規格、追假設、看呼叫端。我擔心的不是按鈕按得夠不夠快,而是:這些修改,我真的有足夠依據接受嗎?這是用來說明 Review 壓力的情境,不是本次量測的公司 PR 佇列。
昨天談到,導入 AI 要回頭看流程、人與工具能不能接得住。到了 Code Review,這個問題變得很具體:前面增加的產出,如果都要靠人從頭理解與查證,工作就可能只是換了一個人忙。
我把這個落差叫 Trust Debt(信任負債):修改已經到手,接受它需要的理解與驗證,卻沒有跟上。這是本文的工作用語,不是量測指標。
我不放心的事情並不都一樣。格式錯誤可以交給工具;規格和程式對不上,需要查材料;業務規則沒有決定,再多測試也替不了那個決定。
這些疑問其實都在問同一件事:這份交付的判斷,有沒有可以核對的依據?如果全部叫作「請 Reviewer 看一下」,人就得從頭分辨。我需要一套框架,安排工具、AI 與人各自查什麼。
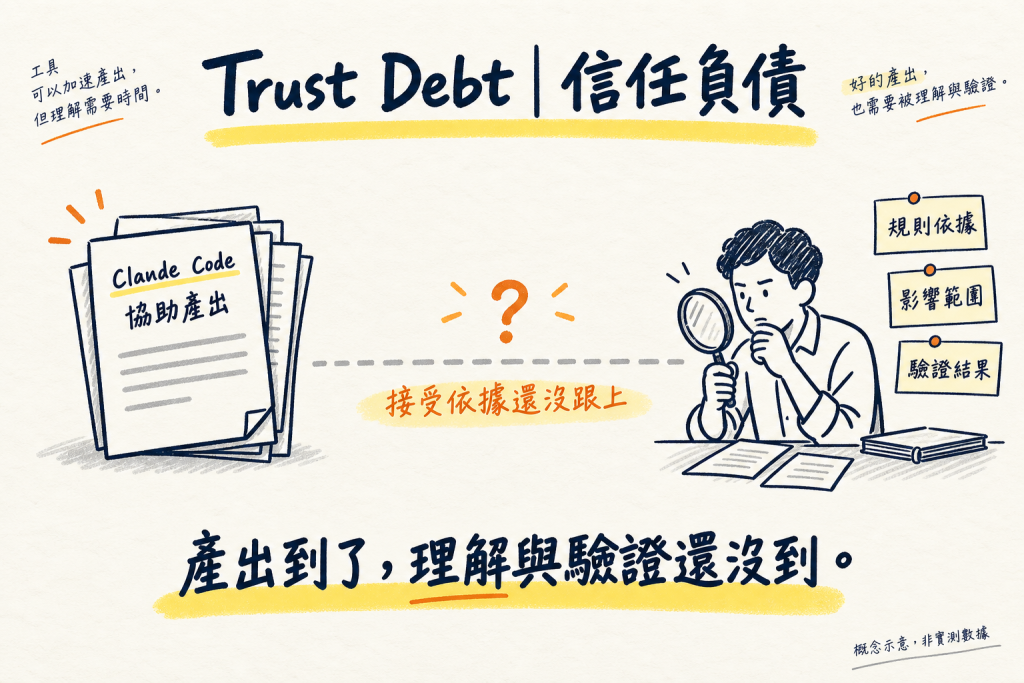
概念示意,非實測佇列或工時。
第一層,工具能明確判斷的,先交給工具。 編譯、格式、既有測試,以及實際配置的靜態分析,都應留下執行結果。測試失敗先回作者處理,不需要 Reviewer 用眼睛重跑。沒執行的檢查,不能順便寫成「都過了」。
第二層,讓 AI 帶著來源找問題。 給 Claude 的材料除了 diff,還要有規格版本、相關呼叫端與測試。我需要的是「哪段規格與哪段實作對不上」,而不是一串「建議加強品質」。AI 提供查核線索,人仍要核對它有沒有誤讀或漏看。
第三層,核心規則與例外交給能決定的人。 涉及授權、金額或核心狀態的變更,先找對 Owner。模型可以整理待決問題,不能自行補一條商業規則,再用自己寫的測試替它背書。
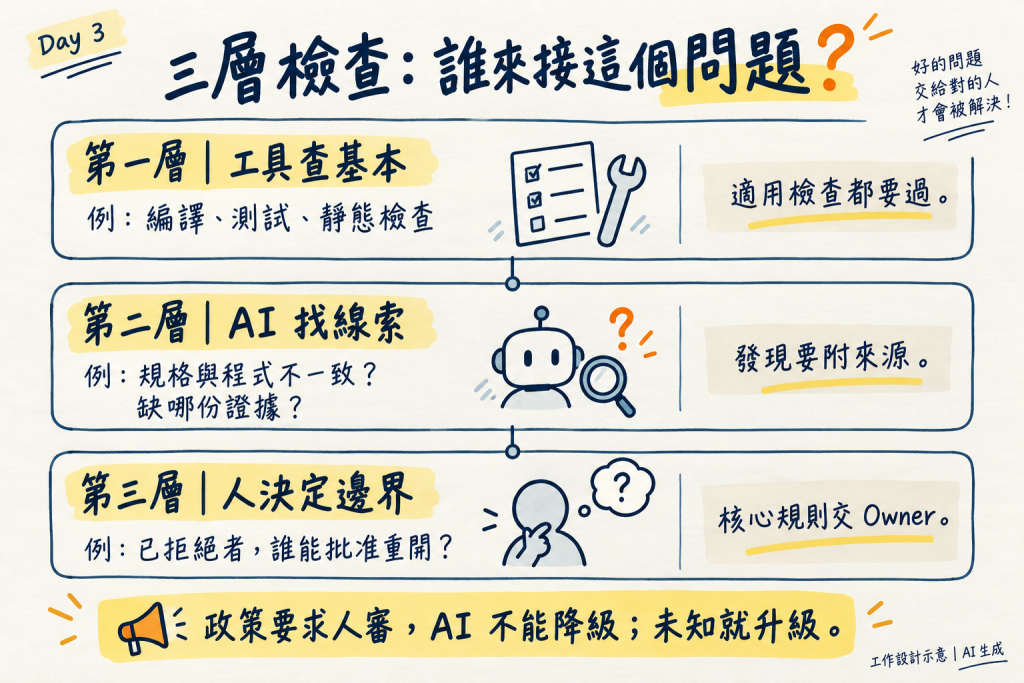
工作設計示意。三層是責任分工,同一份變更可以同時需要三層;Owner 可以提前參與。
團隊先約定必要人審條件,AI 可以補充升級理由,不能解除要求。純格式修改則按明確政策走簡化程序。這是準備採用的設計,還沒有部署成 PR 閘門。
Uber、Meta 與 GitHub 都談到相近的壓力:AI 增加了程式產出,人工理解與審查卻沒有自動跟上。我把他們的做法與對 RD 的幫助整理在一起:
| 公司/來源 | 怎麼分工 | 對 RD 的幫助 | 已公布結果與界線 |
|---|---|---|---|
| Uber uReview(2025) | 將意見生成、篩選、驗證與去重拆開,再收集工程師回饋 | 作者更早修掉問題;Reviewer 少看重複、低價值提醒 | 自動審查中位時間約 4 分鐘;約 75% 意見被回饋為有用,約 65% 在同一變更中得到處理。不是整份 PR 完成時間或 Bug 檢出率 |
| Meta RADAR(2026) | 結合資格條件、靜態規則、風險評分、LLM 審查與確定性驗證 | 讓符合條件的低風險變更走自動化,減少全部排人工審查的負擔 | 研究記錄變更量增加、及時審查比例下降,並評估分層自動化;不是所有變更都可交給 AI 放行 |
| GitHub 審查指南(2026) | 自動審查先找明顯問題,人追關鍵路徑、系統背景與接受條件 | 把人工注意力留給需要背景與判斷的地方 | 官方實務建議,並非 GitHub 內部排隊時間或節省工時的實測報告 |
所以我看這類框架的成效,會分開追三件事:作者等多久才收到有用回饋、Reviewer 花多少時間核對與返工,以及後續是否出現漏網問題。審查意見本身也會製造工作;提醒變多,不一定代表 RD 比較輕鬆。
這些實務支持分工思路,但不能直接換算成我們團隊省下多少工時。前面的三層與接下來的五問,仍需要用自己的交付結果檢驗。
前面談的是分工與做法,光看「工具先查、AI 補看、人來決定」,可能還是有點抽象。接下來用一個取消訂單的小案例,把同一份程式放進三層檢查:哪些已經驗過、哪些只是模型的假設,以及人到底要決定什麼。
先把自己放在網購的情境裡:你下了一筆訂單,商品還沒出貨,現在想取消。開發端收到的需求很簡單:「讓使用者可以取消尚未出貨的訂單。」
為了看清這種需求會留下什麼問題,我們另外做了一個可公開分享的 .NET 教學案例。「合成」指的是訂單資料與題目是為示範設計的,不是公司真實訂單;程式與測試則確實交給 Claude Code 產生,再於本機執行。
給 Claude Code 的程式骨架已經有三個狀態:是否出貨、是否付款、是否取消;回傳結果也有「是否要求退款」的欄位。但需求只說誰可以取消,沒有說已付款的訂單取消後,是否應由這個功能提出退款要求,還是交給另一個流程決定。
這就是 Reviewer 要留意的空白:欄位存在,不代表使用它的業務規則已經說清楚。 本題也明訂不連付款服務、不執行退款,退款欄位只是一個記憶體中的標記。
Claude Code 交回程式、測試、六條假設和四個待確認問題,原件見文末。我請另一個 AI 代理工具 Codex 在本機以 .NET 9 執行它原樣交回的測試:七組情境,共十八個檢查點,全數通過。這些檢查點就是測試裡的「斷言」。接著看它如何處理一筆尚未出貨、尚未取消的訂單:
var cancelledOrder = order with { Cancelled = true };
var refundRequested = order.Paid;
return new CancellationResult(cancelledOrder, refundRequested);
第一行把訂單標成已取消;第二行則把 Paid(已付款)直接接成 RefundRequested(要求退款)。也就是說,只要已付款,取消時就會標記要退款。這個選擇看起來合理,但誰確認過,取消功能就該做這個決定?
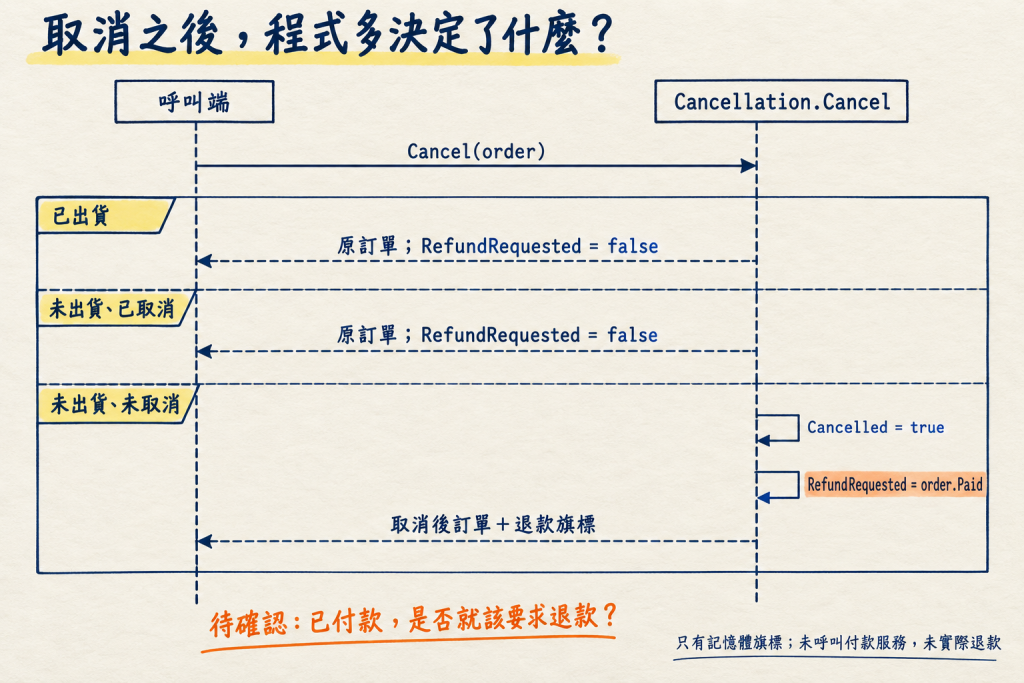
互斥分支的循序示意,省略 null 檢查。橘色處標出待確認的退款規則。
把三層放回來看,第一層已有本機測試結果,沒有完整 CI 或安全掃描結果。第二層要把需求與退款假設並排,指出缺少來源;本次材料是 Claude 自己列出的假設,沒有另跑獨立 AI Reviewer。第三層才是訂單 Owner 要回答的決定:取消是否負責要求退款?
十八個綠燈表示這七組情境中的實際輸出符合測試預期,不能證明業務同意退款假設。這裡需要的獨立依據,是已確認的規則與據此訂出的預期;換 Codex 執行同一套測試,不會讓模型自訂的退款預期自動得到確認。
壓力就在這裡。東西看起來齊了,測試也過了,繼續追會讓這一份停著;先按下去,未確認的決定就會跟著程式往後走。
對這份合成輸出,我會先要求補件:退款假設會改變行為,卻還沒有確認來源。若 Owner 明確接受某個範圍或風險,就留下條件與理由;沒有回答的部分,不能當成已接受。
我會要求送審材料回答五個問題:
可追溯:需求與規則在哪一版?改了哪些檔案?
獨立證據:測試預期來自哪條規則?實際輸出在哪裡?
語意邊界:哪些是新假設?誰確認,哪些仍未確認?
影響範圍:影響哪些呼叫端?哪些路徑尚未驗證?
接受責任:本次要求接受什麼?由誰裁決、理由是什麼?
三層安排誰查,五問整理交給他什麼。不是五格填滿就自動通過;其中一個未確認事項影響接受,就要把它寫成具體補件。
這次可以這樣退:
缺件:Paid → RefundRequested 的規則沒有確認來源。
請訂單 Owner 決定取消是否負責要求退款,並給出適用條件。
作者依確認結果修改程式與測試,附規則位置及執行結果。
Reviewer 核對這項缺件;其他未確認行為仍分別處理。
這是依合成輸出整理的退件範本,不是公司已發生的 PR 裁決。拿最近一份修改試填,最難回答的那格,才是要補的材料,不必再叫 Claude 泛泛地「多檢查一次」。
到這裡,我有了選擇:能查的先查,待決的交給對的人;缺件就說明缺什麼,不能用測試綠燈替代接受依據。
但退件只是開始。退件要求寫清楚,Claude 下一輪就會照做嗎?這次補好了,下次換個任務,還要重新提醒嗎?
這套做法是否減輕負擔,還要看有用回饋的等待時間、人工核對與返工,以及後續漏網問題。目前的合成案例說明了接受判斷的缺口,尚未證明團隊審查已經更快。
參考資料:


 iThome鐵人賽
 看影片追技術