
昨天補齊了可觀測性的三種資料:Log、Metrics、Trace。Log 和 Trace 讓 Claude 能沿著一筆訂單往下查;但每天開始工作,我不可能先把每筆訂單查一遍,才知道哪些需要處理。看整體要靠 Metrics,Metrics 要放上 Dashboard,團隊才看得到。
問題是,Dashboard 上該放哪些 Metrics?Day 23 已經看過:CPU 正常、API 回 200,通知還是沒送到。今天要放的,是使用者的工作有沒有完成:取消的訂單,後面都處理完了嗎?沒處理完的,卡在哪、該由誰接著處理?
這是第四幕「服務上線之後怎麼維運」的第三篇:Day 23 找出監控沒照到的問題,Day 24 讓 Claude 查得到線索;今天要讓團隊看得懂、知道交給誰。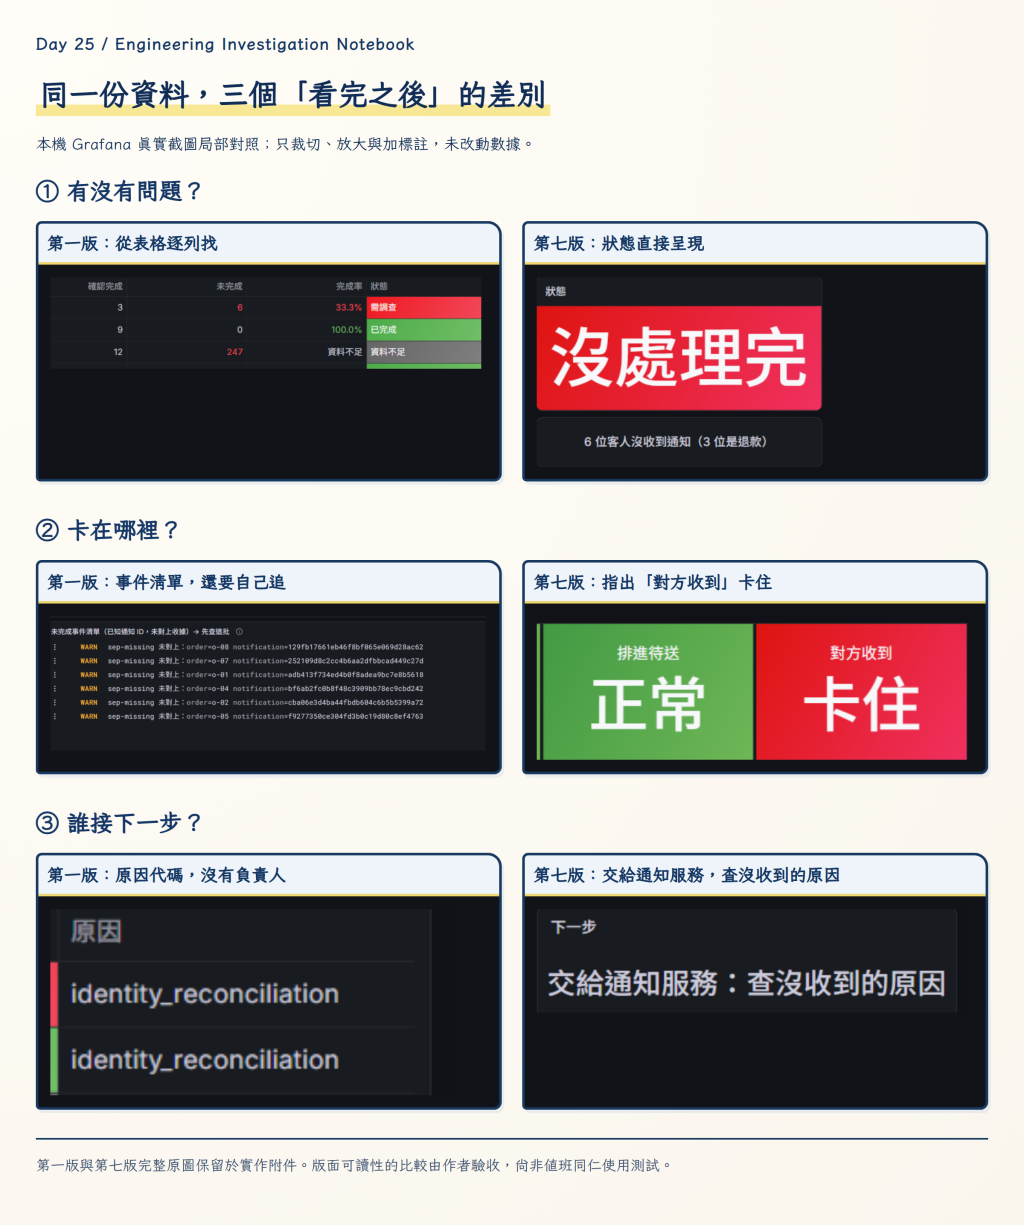
本機 Grafana 真實截圖局部對照。左側是第一版,右側是第七版;資料相同,都是 Claude 用 gcx 建的。完整原圖保留於實作資料。
兩張圖的數字一樣,第一版也通過了事前寫好的五項 Dashboard 檢查。差別在看完之後:第一版要讀完表格、再自己推下一步;第七版看完就知道處理到哪、該交給誰。
標題的問題,這篇用三個「然後呢」依序回答,每問一次往下一層:
三層都由 Claude Code 動手,也都被檢查抓到一個「看起來對、其實不對」的地方。範圍只到取消之後的通知,退款目前看不到;資料是教學紀錄在本機 Grafana 重放,不是 Production。
通知契約要求:每一次真正的取消狀態轉換,都要有對應的通知;使用者重按取消,不能多產生一次副作用。所以分母不是 HTTP 200,也不是所有取消請求。
| 想回答的問題 | 用什麼算 | 不能省略的條件 |
|---|---|---|
| 有多少取消需要通知? | cancel 紀錄中,transitioned=true 的事件 |
排除沒有狀態改變的重複取消 |
| 哪些已經收到? | 同一事件在對方留下的收據 | 對上 request_id、order_id,再核對 notification_id |
| 哪些還沒對上? | 需要通知的事件,扣掉已核對收到的 | 先列出是哪幾筆,不直接宣布漏送 |
| 哪些現在不能判斷? | 缺來源、缺通知編號,或沒有結束紀錄 | 保留未知,列出要補的資料 |
用這張表逐筆核對三份紀錄:每一筆取消,都去找對方的收據,看通知編號對不對得上(Day 23 說的對帳,就是這件事)。結果:漏送通知那次,9 筆對上 3 筆;修好後重跑,9/9;對方回得慢那次,259 筆只對上 12 筆。第三份最容易被算成「247 筆遺失」,但這 247 筆沒有通知編號,也沒有結束紀錄,只能寫「先補資料」,不能判成漏送。
這些判斷寫在離線核對程式 build.py 裡。我再刻意做幾種會騙過總數比較的資料:收據筆數相同、通知編號全錯;同一張收據重複;收據檔不見;發送端沒有通知編號;觀察還沒結束。連同三份原始紀錄,一共八項核對檢查。這八項就是接下來量 Claude 的那把尺。
我另開一個工作目錄,只放通知契約與原始紀錄,不給 build.py、算好的結果或答案,用 claude -p 請它自己寫 reconcile.py,工具只開讀寫檔案和執行它自己寫的程式。判準在它開始前寫好。
它沒有掉進最大的陷阱,沒有說 247 筆遺失。但八項裡有三項沒過:一項是把對方回得慢那份判成「還在處理」(正確是紀錄不全、先補資料),另外兩項是同一個錯。看它判斷「已完成」的地方,最後一行找到收據就加一:
got = by_req.get(rid, {})   # 用 request_id 找收據
if got:
    received += 1           # 找到就算完成,沒有比對 notification_id
請求對得上、筆數也對得上,畫面就會亮成全部完成;收據上的通知編號,是不是發送端送出的那一則,從頭到尾沒看過。總數對,不等於每一筆都對。
我把問題寫成審查意見交回去。它修好了通知編號的比對,卻在「對方回得慢」那份修過頭,從「還在處理」變成「全部卡住要查」,更接近把未知寫成遺失。修正版過了六項:通知編號那兩項修好了,但對方回得慢那份還是判錯,原本通過的「觀察還沒結束」也被改壞。我推測原因有一半在我(沒有做對照):審查意見只說「不要判等待」,沒說該判什麼。數字對不對,固定檢查抓得到;「該補資料還是該去查」,界線要人先寫進規格。
數字對了。然後呢?值班的人拿到的還是一張表,看完不知道卡在哪、要做什麼。
我用 Day 24 的本機 Grafana,把 build.py 的核對結果(不是 Claude 寫的版本)送進 Prometheus 與 Loki,核對結果本身就成了新的 Metrics;再請 Claude 用 gcx 自己探索指標、建 Dashboard。這次 Claude Code 只能用列出來的 gcx 指令(另外用 --plugin-dir 載入官方的建圖 Skill),帳號也只開一個資料夾。
要看的是 --allowedTools:它就是權限邊界,只列出要用的 gcx 子命令,gcx config 不在裡面(它可能印出憑證)。15 次執行裡有兩次,Claude 一開始想先看 gcx 說明或跑 gcx config,都被擋下,這正是設計要的結果。
# 建 Dashboard:只開列出來的 gcx 子命令,官方 Skill 用 --plugin-dir 載入
claude -p "$PROMPT" --model sonnet --strict-mcp-config --plugin-dir ./gcx-skill \
  --allowedTools "Read,Write,Edit,Skill,Bash(gcx metrics query:*),Bash(gcx logs query:*),Bash(gcx dashboards get:*),Bash(gcx dashboards update:*)"
事前寫好的五項 Dashboard 檢查,例如完成率要用對方收據算、不能拿系統自己記錄的已送數當完成,第一版全部通過。但這五項只保證數字算對,保證不了看完知道要做什麼:第一版是一張五列的表加兩大片事件清單,數字都對,卻看不出卡在哪。
接下來每一版,我看截圖驗收,把意見原句交回 Claude 修改。從第一版到第七版,加上定案前的四次小修,Claude 一共執行 15 次。設計原則是從驗收裡長出來的:
第一版的問題,換成讀者自己可以檢查的方式:拿同樣三個問題,回頭看開頭的對照圖。
| 問題 | 第一版 | 第七版 |
|---|---|---|
| 有沒有問題? | 掃五列表格找紅色「需調查」;資料不足那列的 247 也是紅字 | 左上紅燈「沒處理完」,上方一句話結論 |
| 卡在哪? | 只有應完成、已確認,看不出卡在哪一段 | 七段流程,「對方收到」紅燈「卡住」;兩段灰色「看不到」 |
| 交給誰、做什麼? | 原因欄是代碼,沒有負責人 | 右上「交給通知服務:查沒收到的原因」,下方「誰處理」 |
驗收的人是我自己,還沒找值班同仁只看截圖實測。
一個在 Claude 那邊:有一版找不到我新送的調查卡資料,改接了已經停用、還沒過期的舊指標;另一版把殘留的舊資料也算進去,表格拉得太高,下面空了一大片。另外它看不到畫面,每一輪都寫「沒辦法截圖,請你確認」,版面只能靠截圖驗收。每一版的驗收意見與偏離都留在實作資料。
另一個錯在我這邊。交驗收前,我自查發現:結論句寫「另有 259 筆取消的通知看不到有沒有送到」,但這 259 筆裡有 12 筆有對方收據,已經確認收到;真正看不到的是 247 筆。
前面那張核對表算得是對的,錯在把結果寫成句子的那段程式。同一個分母問題,在顯示層又出現一次。 改成「259 筆取消中,247 筆看不到通知有沒有送到」。
知道卡在對方收到、要交給通知服務了。然後呢?值班的人打開系統,第一步查哪裡?
交給通知服務的人打開系統,還是得從頭查起。所以我想讓 Claude 先查一輪,把結果放回 Dashboard。這一段一共跑了四輪:
| 輪次 | 改了什麼 | 結果 |
|---|---|---|
| 一 | 不給工具,同一題問到底 | 資料不足那項也推出原因 |
| 二 | 規則選題,唯讀工具查證 | 成立 |
| 三 | 改白話 | 把查不到寫成沒有 |
| 四 | 說明篩選方式,查不到只能寫「沒查到」 | 成立 |
第一輪不給查詢工具,兩個有問題的項目問同一題:「為什麼會這樣?」漏送通知那項方向對;資料不足那項,它也推出「疑似大多沒有真正送出」。證據不夠時,它還是傾向給一個原因。
第二輪改兩件事:
呼叫時,--tools "" 讓它不能讀寫檔案或執行指令,只剩唯讀查詢;--json-schema 固定輸出欄位,結果才放得進 Dashboard。
# 調查卡:不開內建工具,只給唯讀 MCP,輸出固定欄位
claude -p --model sonnet --tools "" --strict-mcp-config --mcp-config mcp.json \
  --allowedTools mcp__observability__query_observability \
  --json-schema "$CARD_SCHEMA" --max-budget-usd 1.5 < prompt.txt
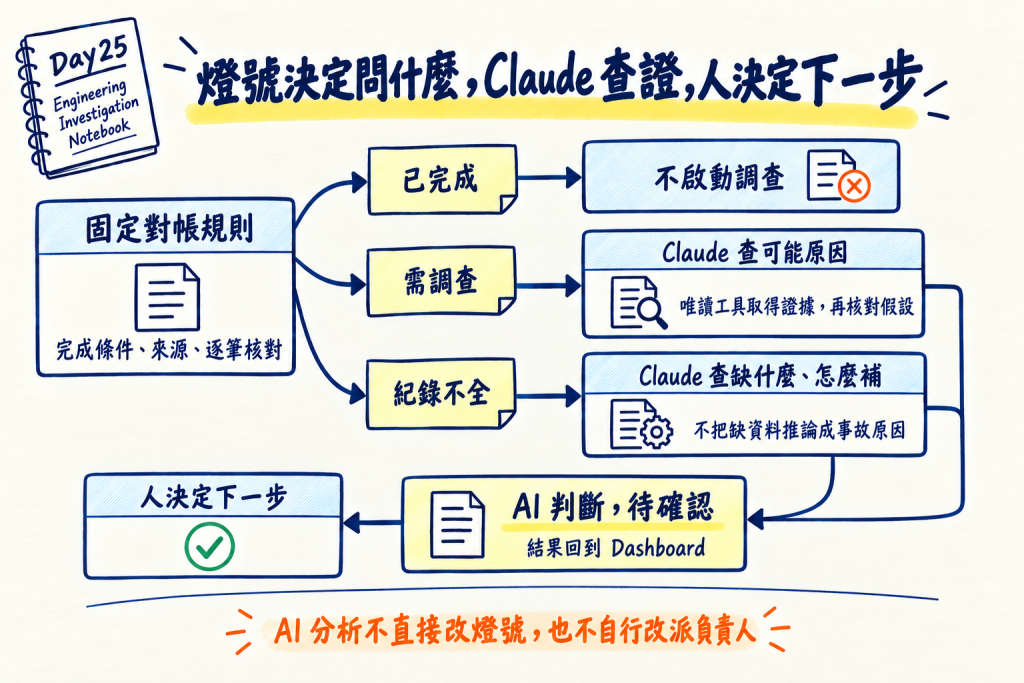
規則先決定問什麼;Claude 用唯讀工具查證,結果回到 Dashboard 等人確認,不直接改燈號或負責人。
這一輪成立:漏送通知那張,查到 6 筆停在「延後」之後就沒有任何紀錄,對方也沒有收據;資料不足那張沒有推原因,只列出缺的資料。
結果放在 Dashboard 最下面,標「AI 判斷,待確認」,不影響上面的燈號與負責人。
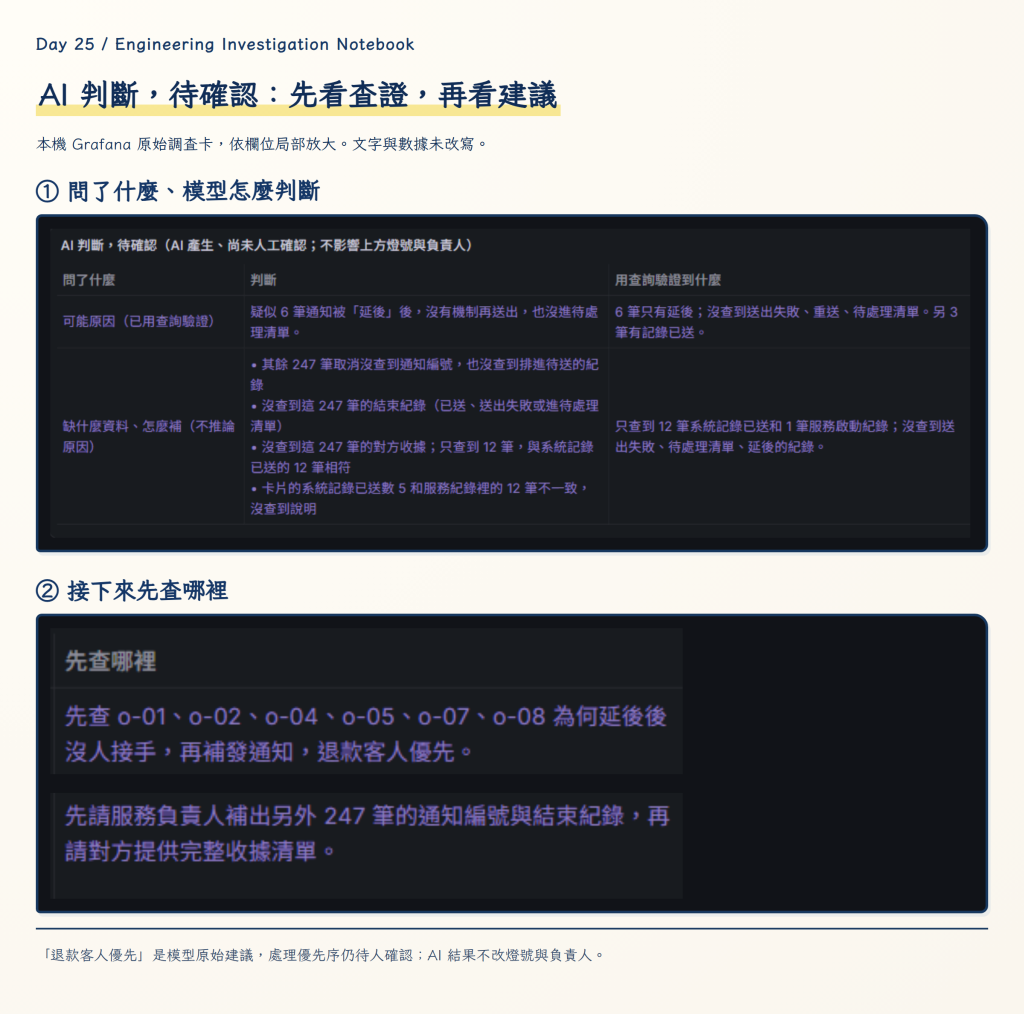
第七版 Dashboard 的 AI 判斷區,本機實際截圖局部放大。「退款客人優先」保留模型原始建議,仍待人確認,不是已核准的處理順序。
卡片原本寫滿 queue_depth、dead_letter 這類術語,違反前面的白話原則。我請它改白話,第三輪術語拿掉了,卻出了另一個錯:資料不足那張用錯篩選方式,9 次查詢都沒查到資料,卡片寫「這一次的服務紀錄在這裡看不到」。實際上紀錄在,換個篩選方式就查得到。稽核檔留下的兩種寫法:
# 第三輪:用文字比對找 sep-slow,紀錄內文沒有這幾個字 → 0 筆
{service_name="order-api-replay"} |= "sep-slow" |= "notify_sent"

# 第四輪:run 是每筆紀錄上的欄位,要用欄位篩選 → 查到 12 筆系統記錄已送
{service_name="order-api-replay"} | run="sep-slow" | event=~"notify_sent|notify_failed|dead_letter|notify_deferred|startup"
查不到,不等於沒有。 第四輪補上篩選方式,並規定查詢沒結果時只能寫「沒查到」;顯示的欄位沒有英文,最長 56 字。
每輪各跑一次、判準跑前寫好,不代表穩定度;也沒有量人工省下多少時間。這張卡只做第一步分流:問一題、查一輪、標待確認。原因是不是真的對,還要另外驗。
這不是新點子。Datadog 的 Bits AI SRE、Grafana Cloud 的 AI 助手,都在做「告警響起,AI 先提假設、用遙測資料查證」。我們沒有 Grafana Cloud,自己搭的最小版本就是這樣:規則決定問什麼,Claude 用唯讀工具查,結果標待確認,燈號還是規則說了算。
今天卡在「對方收到」:6 位客人沒收到通知,交給通知服務;另外 247 筆看不到,先請資料平台補資料。 逐筆核對找出哪幾筆沒對上,Dashboard 指出卡在哪一段、交給誰,調查卡再說先查哪裡。
Dashboard 的價值不是把數字畫出來,而是讓人看完知道下一步。Claude Code 可以幫忙算、畫、先查一輪,但「怎樣才算對」要人先定好。
漏送通知那張調查卡還建議「補發通知,退款客人優先」,但今天的 AI 只建議、不動手。漏送通知的修法,Day 23 已經做過。不過同一套核對裡,還有一輪的數字怎麼看都不對勁,而且問題不在通知。那一輪到底發生了什麼?下一篇讓 Claude 從頭查起。
參考資料:
build.py 與三次核對結果、Claude 寫核對程式的兩輪與八項檢查、Dashboard 15 次執行(提示、回覆、dashboard.json、截圖)、調查卡四輪,以及各版事前判準、驗收原話與偏離紀錄。原始紀錄不隨本篇公開,trace 與稽核檔改放摘要,說明見教學包 README。實跑成本(sonnet,各一次):核對兩輪 50 回合、約 5 分鐘、US$0.65;建 Dashboard 15 次、393 回合、約 39 分鐘。

 iThome鐵人賽
 看影片追技術