

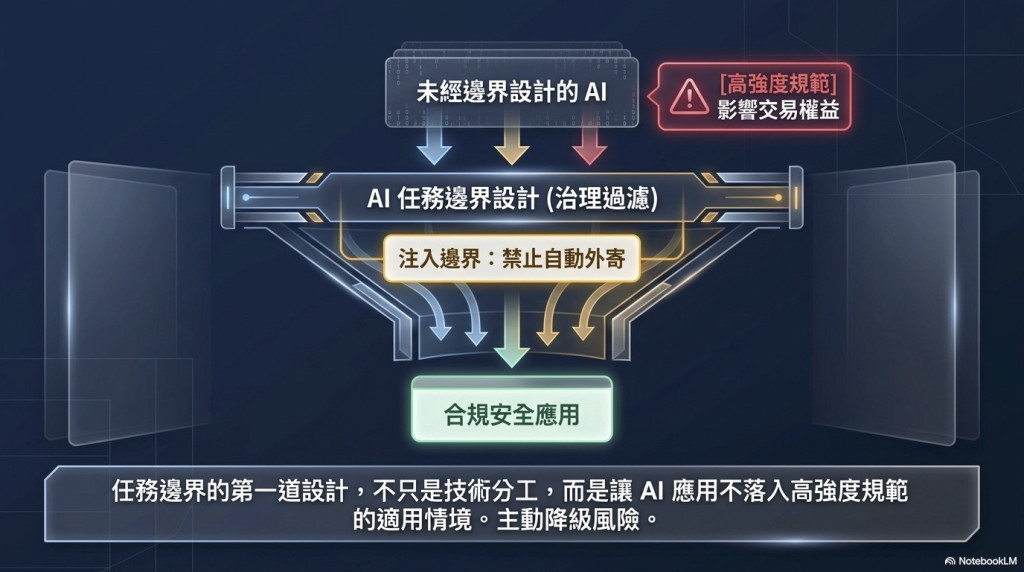
在企業推動數位轉型的過程中,最令人擔憂的現狀莫過於:「邊界不寫下來,AI 的能力範圍就等於每個使用者的想像力範圍。」 尤其在金融保險營運場景,生成式 AI 與傳統系統截然不同;傳統系統沒開發的功能就是做不到,但 AI 只要使用者改一句提示詞(Prompt),就能輕鬆地「多走一步」。今天它在分類郵件,明天可能就在草擬回覆,後天那份草稿若被直接寄出,風險將瞬間失控。
作為治理的第一道防線,我們不能僅憑感覺分工,而必須建立一套具備客觀判準的層級體系。這套框架的核心目的,是為了因應**「保險業自律規範」**。透過明確的邊界設定,我們可以確保 AI 應用不至於誤入「直接與消費者互動」或「影響交易權益」等高強度監管的紅燈區。
| 層級 | 定義 | 判準 |
|---|---|---|
| ✅ 可自動執行 | AI 完成後直接生效,事後抽查。 | 錯誤代價低、錯誤容易被發現,且不涉及外部溝通或客戶權益。 |
| 💡 僅供建議 | AI 產出建議值,最終值由人工決定。 | 錯誤代價具備「不對稱性」,或判斷過程包含業務裁量權。 |
| 🧑⚖️ 必須人工決定 | AI 不得產出決定,僅能負責整理材料。 | 直接影響案件走向、涉及對外承諾或組織資源分配。 |
| ⛔ 禁止執行 | 絕對不得交給 AI,即使是「僅供參考」也不行。 | 屬於全域禁止清單、高敏感情境,或輸入資料違反安全紅線。 |
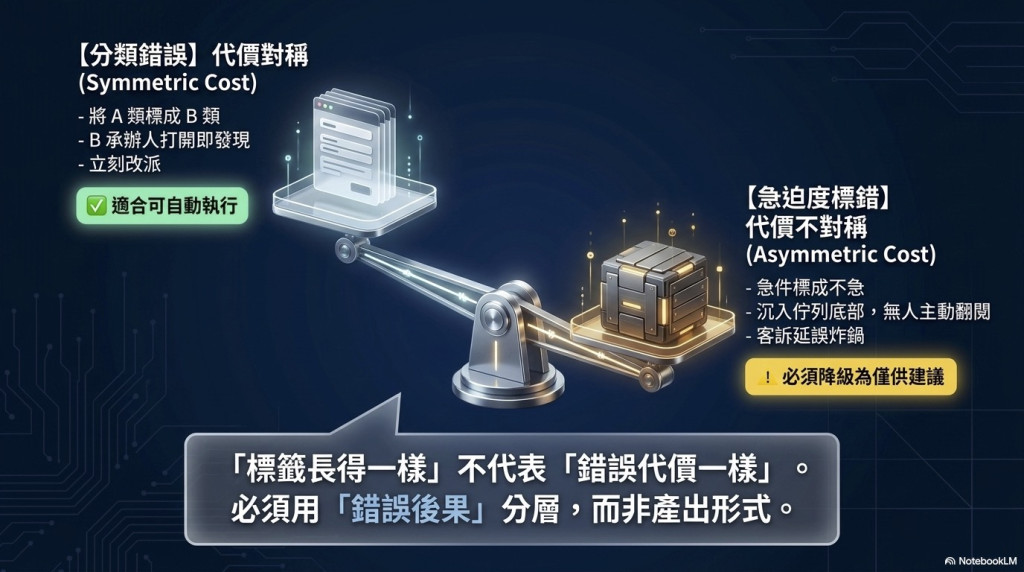
在開發「公用信箱需求分類」場景時,曾出現過一個極具教育意義的治理決策轉折。在 v0.1 版本中,我們直覺地將「需求分類」與「急迫度判斷」都設為「可自動執行」,因為兩者在技術形式上都是「貼標籤」。
然而,進一步審視後發現,這兩者的錯誤後果完全不同。當「需求分類」出錯(例如將 A 類標為 B 類),B 類承辦人一打開信件就會立刻發現並改派,這種錯誤代價是「對稱」且「顯性」的。但「急迫度」若判斷錯誤(例如將急件標為不急),這封信會安靜地沉在佇列底部,且因為沒人會主動檢查標示為「不急」的佇列,這個錯誤將變為隱形的「沉默錯誤」(Silent Error),直到造成嚴重客訴才被察覺。
> 「標籤長得一樣」不代表「錯誤代價一樣」。用產出形式分層是錯的,要用錯誤後果分層。
因此,在 v1.0 版本中,我們果斷將「急迫度判斷」降級為「僅供建議」,要求必須經由人工確認,未經確認的信件不得進入低優先序佇列。這種基於錯誤代價不對稱性的治理決策,正是確保 AI 安全落地的關鍵。
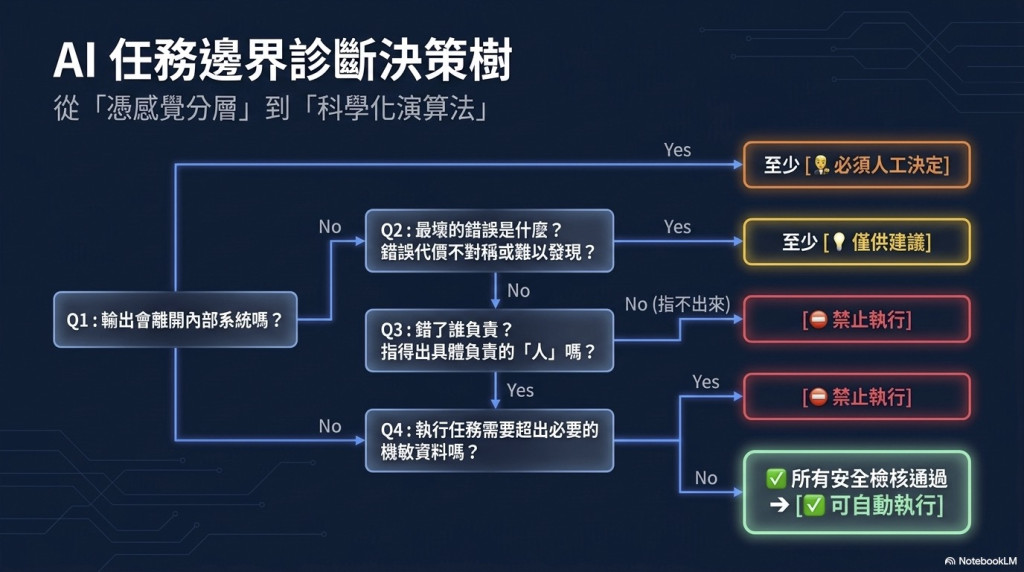
為了將模糊的「直覺」轉化為「客觀判準」,我們要求團隊在定義 AI 任務層級時,必須依序詢問以下四個問題:
除了場景專屬的邊界,企業必須設立一組優先於所有場景的「全域禁止清單」,以防杜法律與合規風險:
值得注意的策略細節是:「禁止自動外寄」(G1)是讓許多場景從風險黃燈轉為綠燈的關鍵。 透過切斷 AI 直接對外的鏈結,我們實質上規避了 AI 代表公司承諾其無法負擔之法律責任的風險,從而降低了整個專案的合規壓力,加速部署進度。
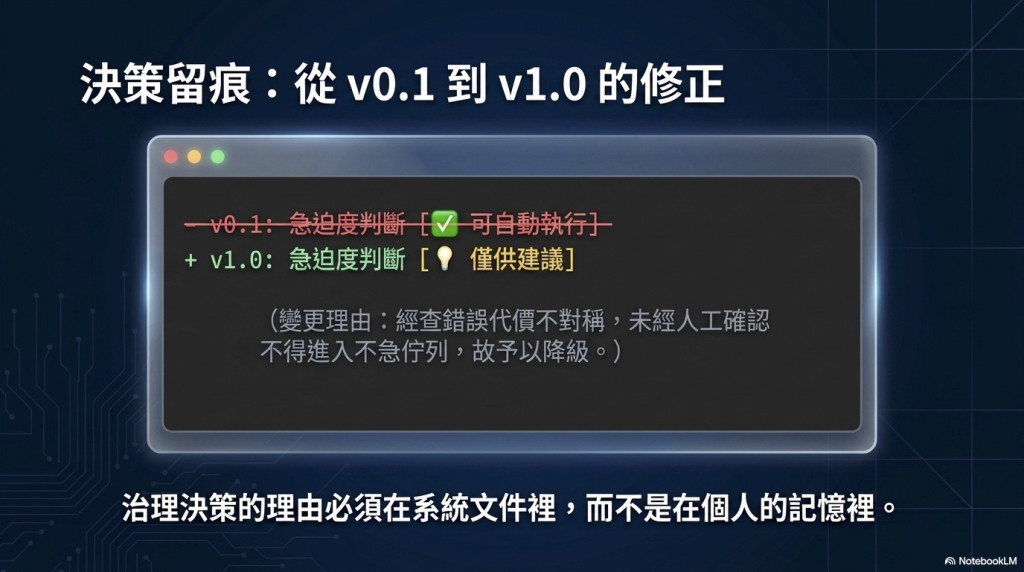
AI 治理的精髓在於「決策留痕」。我們之所以將「急迫度判斷」從 v0.1 的自動執行降級為 v1.0 的僅供建議,這背後的決策理由與邏輯必須被清晰記錄在治理文件(如 docs/governance/)中,而非僅存在於開發人員的記憶裡。這不僅是為了因應未來的合規稽核,更是為了建立組織的集體智慧。
當邊界定義完成,下一步(Day 4)我們將進入更細緻的「AI 規格」定義,將業務需求轉化為 AI 可執行的輸入、輸出與處理規則。
結尾提問: 在您的企業中,AI 的邊界是由嚴謹的制度與文件定義的,還是由員工隨興嘗試的提示詞(Prompt)定義的?


 iThome鐵人賽
 看影片追技術