
系列:「一人艦隊:用一群 AI CLI 打造跨平台代理 mesh」— 第 20 篇
紀錄日期:2026-09-17
昨天做完子任務重用率之後,留了一句:那個數字只顯示在手機畫面上,App 一關就沒了。今天就做這件事——讓每次 fan-out 留下一行紀錄。
coordinator(Z13)今天第三天不在 Tailscale 網路上。第一天我為此寫了一整段感想,第二天把手機指向這台 Mac 就繼續做,今天連提都不想提了。這大概就是備援的真正價值:它讓一件本來會毀掉一天的事,變成一行環境說明。
今天刻意把凍結的名單縮成三個:iPad 上的 app-local 模型、這台 Mac 上的 claude 和 agy。
昨天卡住的那台 m1 被我拿掉了。 它的 daemon 活著、API 有回應,但 attempt 永遠停在排隊。那是別人的機器,我昨天查到「可達但不接手」就停手了。今天要跑兩輪驗收,不想每一輪都被它拖到卡在「停止中」。
這件事要說清楚,因為它會影響等一下那個 100% 的完成率:那不是系統變好了,是我挑了容易的路。 這種話如果不寫在數字旁邊,三個月後看到「完成率 100%」的人會誤會。
每次合併完成,就往裝置的瀏覽器儲存空間寫一筆:
export interface RunRecord {
  task_id: string;          // 完整的,不是畫面上那八碼
  at_unix: number;
  coordinator: string;
  manifest_sha8: string | null;
  plan_mode: "auto" | "split" | "same";
  dispatched: number;       // 派出去幾份
  completed: number;
  failed: number;
  pending: number;          // 寫這筆時既沒完成也沒失敗的
  task_state: string;       // 合併當下的任務狀態
  merged: boolean;
  adoption: { adopted; considered; ratio; shingle; threshold } | null;
}
四個刻意的決定:
一、它不是收據。 這條線我劃得很清楚。收據是給 coordinator 的、要簽章、要能被別人驗證;這份紀錄是發起端自己的記帳,不簽章、不上傳。一旦本機記帳混進收據,別人就得連我這台裝置的時鐘和我自己定義的指標一起信任——那是在賣一個我付不起的保證。
二、把量尺跟數字存在一起。 shingle(片段長度)和 threshold(門檻)跟著每一筆走。因為門檻是我拍腦袋定的 15%,之後一定會改,而改的那一天如果只存了比例,所有歷史就全部變成不可比的垃圾。
三、上限 50 筆,同一個任務重複記會覆寫。 手機不是檔案庫。而「先用三份輸出合併、後來又有一份回來再合併一次」是同一次跑,不是兩次。
四、頭條用中位數。 樣本個位數的時候,一次 0% 或 100% 會把平均拉走二十個百分點。
還有一個看起來很小、但我認為是今天最重要的欄位設計:ratio 和 completion_rate 在沒東西可量的時候回 null,不是 0。「量過了,結果是零」和「沒得量」是兩件事,把它們合併成 0,指標會在資料最少的時候最不可信——正好是你最需要它的時候。
寫入的時機我改了兩次。第一版寫在「任務終止」時,但昨天才剛學到教訓:任務可能永遠不終止(一台不回報,整件事卡在「停止中」)。那樣的話最需要被記錄的那幾次——出事的那幾次——反而一筆都留不下來。
第二版改成「合併產出答案時」。理由是:有答案可看,這一次對使用者來說就算數了,不管系統內部收乾淨了沒有。紀錄裡的 task_state 欄位會誠實寫下當時的狀態,所以事後分得出來哪幾次是提早合併的。
const key = `${taskId}:${adoption?.considered ?? -1}`;
if (recordedRef.current === key) return;
recordedRef.current = key;
setRuns(appendRun(buildRunRecord({ … })));
那個 key 帶上「這次合併看到幾份可量測的輸出」,是為了處理一個具體情境:先用三份合併、過一會兒第四份回來了、使用者再按一次合併。第二次應該覆寫第一次的紀錄(同一個任務),但也確實應該被重新記錄一次(數字變了)。用 task_id 當去重鍵、用 considered 當變更偵測,兩件事就都對了。
it("treats unreadable storage as no history instead of breaking", () => {
  expect(loadRuns(throwing)).toEqual([]);                        // 無痕視窗
  expect(() => appendRun(rec("x"), throwing)).not.toThrow();
  expect(loadRuns(mem("not json at all"))).toEqual([]);           // 寫到一半被砍
  expect(loadRuns(mem(JSON.stringify({ not: "an array" })))).toEqual([]);
  expect(loadRuns(mem(JSON.stringify([{ junk: 1 }, rec("ok")])))).toHaveLength(1);
});
瀏覽器儲存會失敗,而且失敗得很安靜:無痕模式、使用者清掉資料、配額滿了,有些情況連讀都直接丟例外。輔助功能壞掉不准拖垮主功能——我為這件事寫的測試比寫功能本身還久。
順手做了評估環境的一半:三題固定的題目,畫面上一排按鈕直接帶入。
三題刻意不同形狀,不是為了「可比」而已,是為了讓它們在不同的地方壞掉。
E3 是我最期待的一題,因為它問的正好是我前天遇到的真實處境:
A task is stuck: three workers finished, one never reports back. Should the requester be shown a merged answer from the three, or nothing at all until every worker reports? Give one recommendation and the single strongest argument against it. Under 120 words.
前天我自己的答案是「給」,而且當天就把那顆按鈕做了出來。把同一個問題丟回給艦隊,看它們會不會給出我沒想到的反對理由,本身就是一種對系統的使用方式——這比「幫我寫一段文案」更接近我想要這個 mesh 做的事。
(今天還沒跑 E3,因為兩輪 E2 已經把時間用完了。明天補。)
參與者還是漂移的(今天三台、昨天五台、前天十二台),所以這還不是真的評估環境。但一次固定一個變數,已經是我現在能做到的。
跑之前我對「拆成子任務」這個模式其實有點成見。前天十二台那輪,planner 拆出「做字數稽核」「寫投影片大綱」「寫講者提示」這類跟正文無關的工作;昨天五台那輪,它假設每台都能讀專案檔案,而當天派工的權限是唯讀不給工具,四份工作的前提當場不成立。
今天這輪完全沒有這兩個毛病。同一個 planner、同樣的拆解模式,差別只在題目形狀:前兩次是開放式的「解釋一件事」,今天是「列五個東西」。
題目愈有結構,規劃者愈不容易亂跑。 這是一個可以驗證的假設,而且正好可以用固定題組來驗:E2(清單)應該最穩,E1(散文)中間,E3(判斷)最容易失控,因為它根本不該被平行拆開。等三題各跑幾次,這個假設就有數字可以對。
這也是為什麼我把三題設計成不同形狀,而不是三題同類型的——評估題組的價值不只在可比,還在於它能同時當實驗的自變數。
做完跑兩輪驗收。同一題(E2)、同一組三台機器、只換拆解模式。
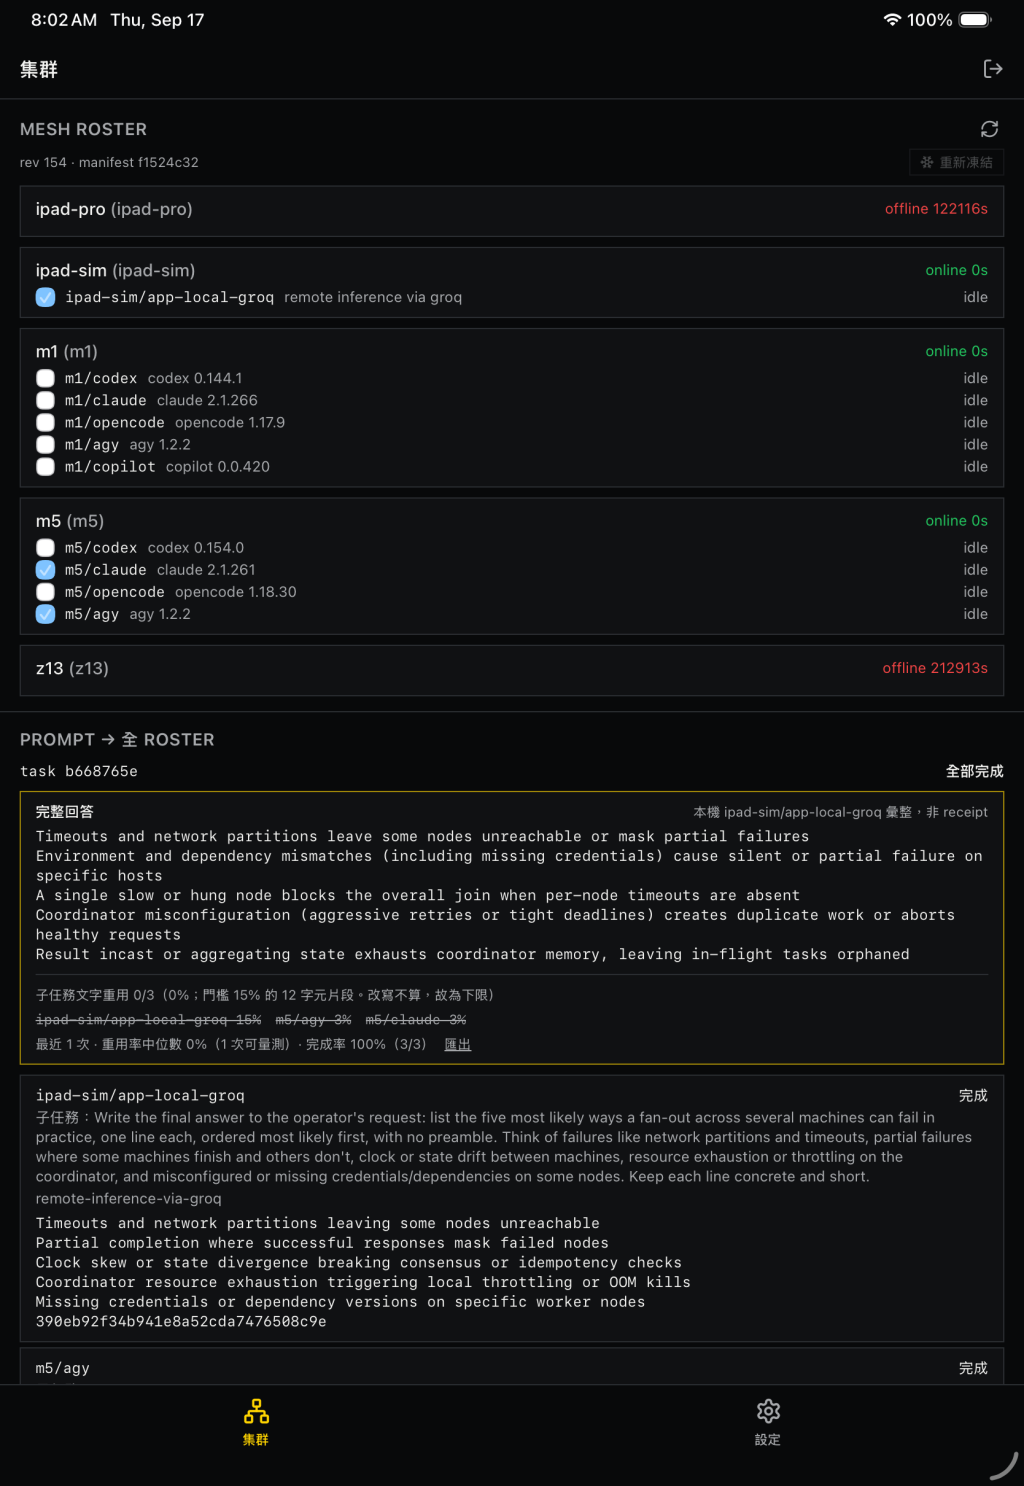
三台全部完成,重用率 0/3。三個百分比(15%、3%、3%)全部被畫上刪除線。
我第一個反應是指標寫壞了。去看 planner 拆出來的子任務才知道不是。給其中一台的原文是:
Review the top five practical failure modes of a fan-out … from the angle of the coordinator side … Produce a ranked list … so the operator's final answer can be cross-checked against it.
planner 安排了一個產出者(寫最終清單)和兩個複核者(一個從 coordinator 角度、一個從 worker 角度),而且明確告訴複核者「你是用來給最終答案做交叉檢查的」。
三份子任務並排看更清楚:
| 參與者 | 被指派的工作 | 重用率 |
|---|---|---|
| iPad 的模型 | 寫出最終答案:五個失敗模式,一行一個,最可能的排前面,不要前言 | 15% |
| m5/agy | 從 coordinator 側複核,產出最多五條排序清單,供最終答案對照 | 3% |
| m5/claude | 從 worker 側複核,同上 | 3% |
而複核者交出來的東西品質很好。m5/agy 的第一條是:
Misconfigured timeouts: premature deadlines fire against normal tail-latency variance, unnecessarily aborting healthy requests.
這句話完全沒有進最終答案,但它不是垃圾——它是一個排序意見。指標看得到文字,看不到影響。
複核者的文字,本來就不該出現在最終答案裡。 複核的價值在於它改變了產出者寫什麼,不在於它自己的句子被抄進去。
所以 0/3 不是系統失敗,是指標的定義撞到了系統的正確行為。
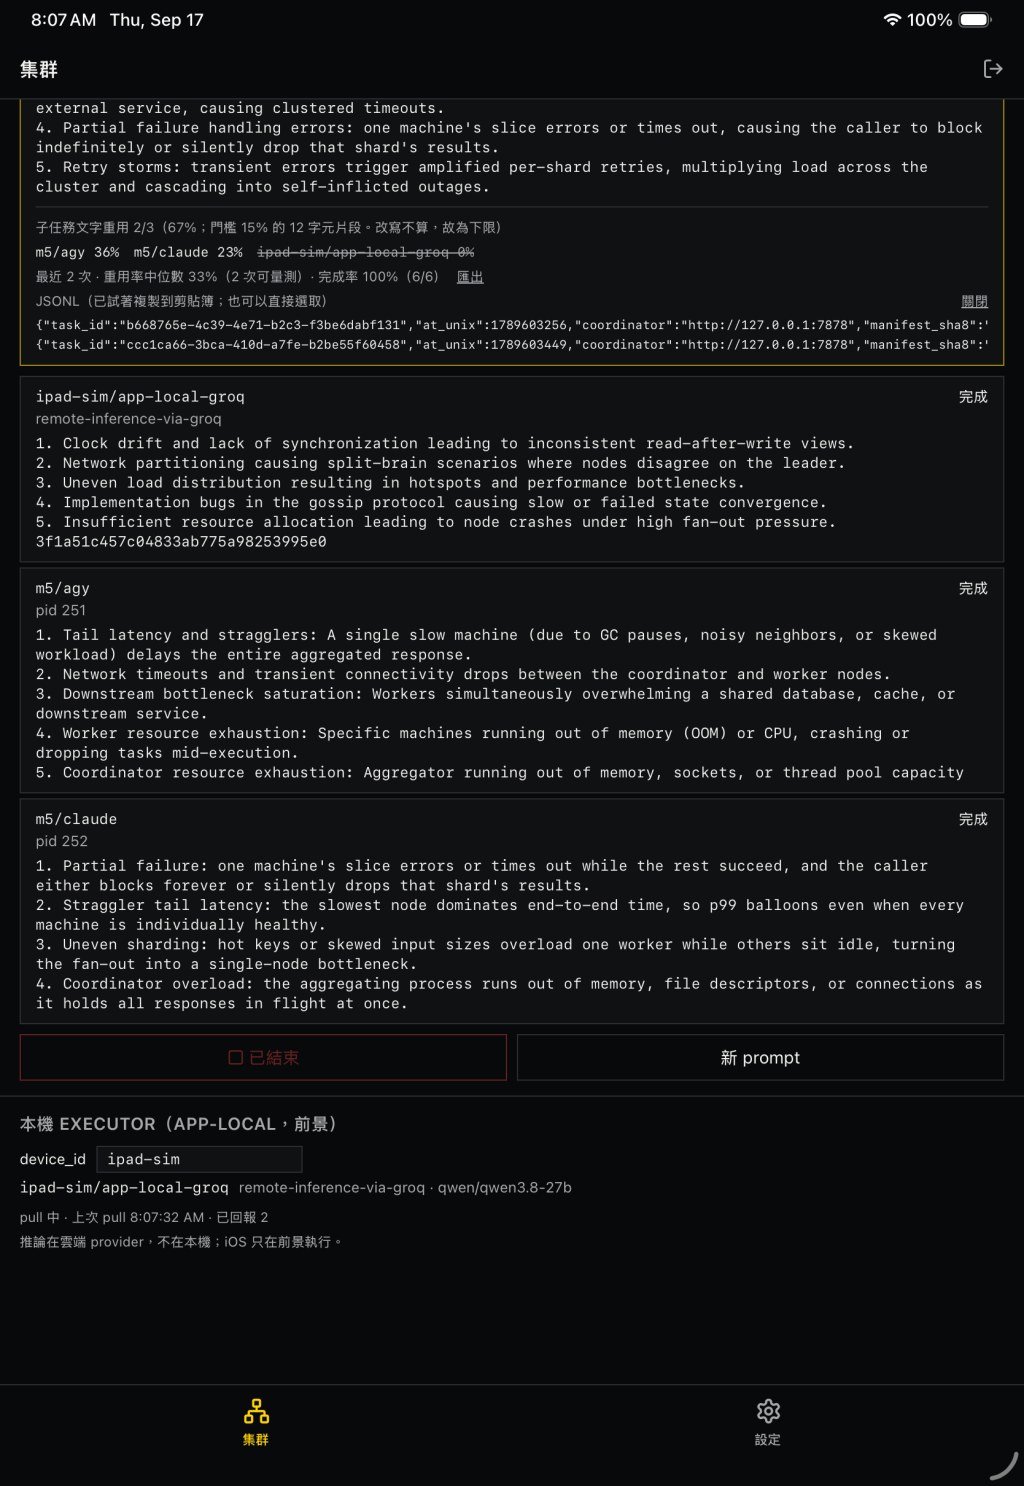
三台各自寫一份五行清單,重用率 2/3(67%)。
三份的角度差很多。一台的第一條是「一台出錯或逾時,其他成功,呼叫方要嘛永遠等下去、要嘛默默丟掉那一片的結果」;另一台的第一條是「時鐘漂移導致讀寫視圖不一致」。最終合併保留了前者的骨架,後者完全沒進去——所以它是 0%。
這次指標量到的東西是對的:那份內容確實沒有被採用。合併的模型在五個名額裡選了別的。
| 拆成子任務 | 同一題給全部 | |
|---|---|---|
| 完成 | 3/3 | 3/3 |
| 文字重用 | 0/3(0%) | 2/3(67%) |
| planner 的角色分配 | 一個產出、兩個複核 | 三個都產出 |
| 這個數字代表 | 指標的限制 | 真的有被採用 |
同一題、同一組機器、同一個合併模型,只因為拆解方式不同,指標從 0% 跳到 67%。
如果今天只跑第一輪,我很可能會下「拆成子任務比較差」這個完全錯誤的結論,然後去改一個沒有壞的 planner。
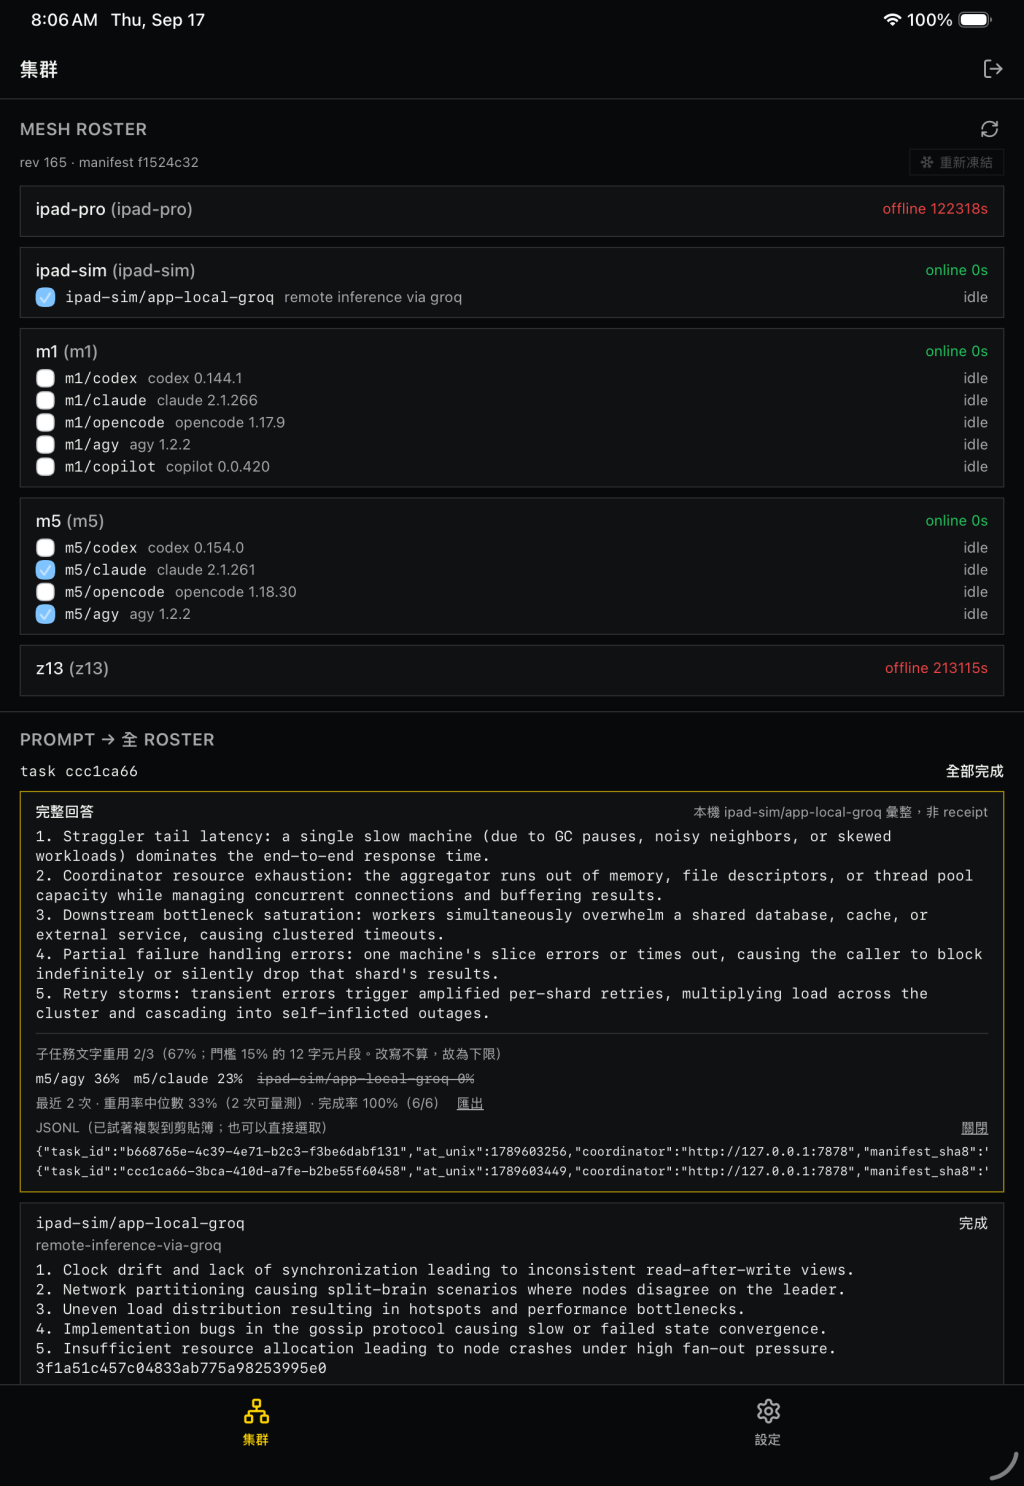
完整回答下面多了一行:
最近 2 次 · 重用率中位數 33%(2 次可量測)· 完成率 100%(6/6) 匯出
按匯出會把 JSONL 複製到剪貼簿,同時印在一個可以手動選取的區塊裡:
{"task_id":"b668765e-4c39-4e71-b2c3-f3be6dabf131","at_unix":1789603256,…
{"task_id":"ccc1ca66-3bca-410d-a7fe-b2be55f60458","at_unix":1789603449,…
之所以兩條路都做,是因為 iOS 的 WebView 對剪貼簿授權不保證成功,而且失敗時通常不吞聲。與其做一個「有時候會靜靜失敗」的按鈕,不如永遠把東西攛出來。
這跟前幾天那條原則同一家族:降級要看得見。快照標「(快照)」、不完整的合併標「(其餘未回報)」、複製可能失敗就把原文也印出來。
畫面上的任務編號只有八碼,而 coordinator 沒有「列出所有任務」的端點。所以事後想撈某一次的細節,只有發起端知道完整編號——而發起端也沒把它記下來。我前幾天還把這件事寫成給契約的建議。
現在它就在紀錄的第一個欄位裡。我做這條紀錄是為了指標,順手把一個跟指標無關的痛點補掉了。
兩筆資料,一筆 0%、一筆 67%。
兩筆的時候當然一樣。但把它想成三筆:如果明天再跑一輪拿到 70%,平均變成 45.7%,中位數變成 67%——中位數會誠實地說「多數情況接近 67%,有一次例外」,平均則會給出一個從來沒發生過的 45.7%。
在我這種樣本數永遠只有個位數的場景,這個差別不是學術問題。我現在唯一會拿這個數字做的決定是「要不要去改 planner」,而那個決定應該基於「多數情況長什麼樣」,不是基於一個被異常值拉走的平均。
歷史那行放哪裡。 一度想開一個獨立的「統計」分頁,後來放棄。一個要特地點進去才看得到的數字,等於不存在。它現在貼在完整回答的正下方,你每次拿到答案都會順眼看到「這是最近幾次裡的第幾好」。指標要跟它想影響的那個決定放在同一個畫面上,否則只是裝飾。
匯出為什麼同時做兩件事。 剪貼簿和可選取的原文都給。因為 iOS 的 WebView 對剪貼簿授權不保證成功,失敗時通常不吞聲。與其做一顆「有時候會靜靜失敗」的按鈕,不如永遠把東西攛在那裡,複製成功只是加分。
有了 JSONL,離線分析就是幾行的事。腦中排了三個問題,每一個都要十筆以上才有意義:
三個問題現在一個都答不出來,但它們從「模糊的感覺」變成了「等資料夠了就能算」。今天真正的產出不是那條歷史線,是把三個問題放進了可回答的隊列。
做到一半有個念頭:既然要存紀錄,何不順便把每次的完整輸出也存下來?事後要重算任何指標都不必重跑。
沒做。三個理由:
只存數字、不存內容,是今天這個設計裡我最有把握的一個決定。
| 項目 | 結果 |
|---|---|
| 每次 fan-out 一行紀錄 | 已驗證:兩輪都寫入,匯出可讀 |
| 固定題組 E1/E2/E3 | 已上畫面 |
| 兩輪對照(只換拆解模式) | 0/3 vs 2/3,完成率都是 3/3 |
| 新增測試 | 8 個(含 3 個測儲存壞掉) |
| 全專案測試 | 99 個全綠 |
| 型別檢查 | 0 錯 |
| commit | b64ef034 |
| coordinator | 本機 daemon;Z13 連續第三天離線 |
| 誠實註記 | 完成率 100% 是因為我把會卡住的那台排除在名單外 |
今天所有改動都在手機端的程式裡,Rust 那顆 binary 一行都沒碰。這是刻意的。
紀錄、指標、題組——這三樣都是「發起端想知道什麼」的問題,不是「艦隊之間怎麼對話」的問題。一旦把它們寫進 core,就等於要求每台機器都同意我的指標定義、我的門檻、我選的三道題。而我今天才剛證明我的指標在某些情況下會誤導自己。
還在變的東西不要往契約裡放。 等到某個指標連續十次都給出可解釋的數字、我也能說清楚它什麼時候會錯,那時候再提議把它變成契約的一部分。在那之前,它待在我自己的手機上,錯了只有我承擔。
這條界線這幾天被反覆用到:昨天那個 nonce 被截斷的問題我沒有自己偷改驗證規則,而是寫成備註;今天這些東西我沒有塞進 core。契約是大家的,實驗是自己的。
那台不接 attempt 的 m1,今天被我從名單裡拿掉,不是修好。
我很清楚這是債。今天的 100% 完成率買在這筆債上,而且每多繞過一次,就多一次「其實這個系統在四台以上的規模下沒有被驗證過」的空白。前天那次十二台的 fan-out 至今仍是規模最大的一次,而那次的成績是 12/13。
真正要修它,得能看 m1 那台的日誌,而那是別人的機器。所以今天做的是:把「為什麼被排除」寫進報告、把備註交出去、在文章裡標明數字的來源條件。在多人的艦隊裡,誠實標註自己繞過了什麼,比偷偷修好別人的機器更重要。
前天我寫「指標最危險的時候不是它不準,是別人以為它準」。今天遇到更細的一層:
指標會在系統做對事情的時候給你難看的數字,而那個難看的數字看起來跟真的問題一模一樣。
分辨這兩者的唯一方法是回去看原始資料——今天是去讀那三個子任務的原文。如果我只看那行摘要,我會改錯地方,而且會很有信心地改錯。
所以加一條個人規則:任何指標第一次給出極端值(0% 或 100%)的時候,都要回頭看一次原始資料,才准把它寫進結論。 中間值可以相信趨勢;極端值幾乎總是在說「你的定義和現實對不上」。
從 9/15 到今天,每一天的發現都長得很像:
三次都是定義和現實之間有一條沒人明說的縫,而且三次都是在系統正常運作、沒有任何錯誤訊息的情況下現形的。沒有例外堇出、沒有紅字、測試全綠。
這類問題只有兩種方法會被抓到:真的去用它,或者真的去讀原始資料。自動化測試抓不到,因為測試只會驗證我已經想到的那個定義。
讓 planner 在拆題時標註每個子任務是「產出」還是「複核」。指標只對產出型計算重用率,畫面上也能直接告訴使用者「這台是複核,本來就不會出現在答案裡」。這條是今天兩輪比較直接指出來的,而且一次修好兩件事。
Z13 如果回來,先用同一組腳本把前兩天欠的真機測試對它重跑一次。


 iThome鐵人賽
 看影片追技術