
系列:「一人艦隊:用一群 AI CLI 打造跨平台代理 mesh」— 第 19 篇
紀錄日期:2026-09-16
昨天那一晚(Day 18)在測手機進背景多久算離線的時候,順手記了三張待辦。今天全部動手:
online 0s,看起來像艦隊還活著。第一張是昨天在真機 iPad 上撞到的,第二張是昨天自己看截圖時發現的,第三張是前天欠下的。三張都做完了,而且在做完之後又撞到第四件事,那件事才是今天真正的收穫。
先講環境:coordinator(Z13)今天整天仍然不在 Tailscale 網路上。昨天我還為這件事寫了一大段感想,今天就只是換一台繼續做——把手機指向這台 Mac 自己的 daemon。同一顆 binary,換個網址而已。這種「昨天的災難今天變成例行公事」的感覺,其實就是工程進展的樣子。
契約第 6 節寫的是:手機不跑常駐程式,只在 App 在前景的時候,每秒去 coordinator 拉一次任務。這是 iOS 的限制決定的,沒有討論空間。
但我的程式綁的是畫面。執行迴圈寫在 Mesh 畫面(集群分頁)的元件裡,隨著這個元件掛載而啟動、卸載而停止。前幾天為了讓 demo 順手,我加了一個「App 重開時回到上次離開的分頁」的行為。兩件事湊在一起就出事了:
使用者上次停在「設定」分頁 → App 重開回到設定 → Mesh 畫面沒掛載 → 執行迴圈不存在 → 手機不 pull → coordinator 三十秒後標它離線。
昨天在真機 iPad 上就是這樣:裝置解鎖著、App 明明開著、畫面亮著,可是 coordinator 的名冊上完全沒有它。當時我還以為是網路問題,切到「集群」分頁之後十三秒它就上線了,才知道是自己的架構問題。
這是那種「兩個各自合理的決定湊出一個洞」的典型。回到上次分頁是好行為;把迴圈放在畫面裡在單畫面 App 也是好行為。錯的是它們碰在一起之後,沒有人去重讀契約那句「在前景」。
新開一個檔案 meshExecutorContext.tsx,把下面這些東西整組搬出 Mesh 畫面:
device_id(這台手機在艦隊裡的名字)然後由手機外殼(那個管上下分頁的元件)掛一次:
return (
  <MeshExecutorProvider>
  <div className="flex flex-col h-[100dvh] bg-spectyn-bg">
    …header…
    <main><Outlet /></main>
    …tab bar…
  </div>
  </MeshExecutorProvider>
);
外殼在兩個分頁之間切換時不會卸載,所以迴圈也不會。
Mesh 畫面的單元測試是直接 render(<MobileMesh />) 的,沒有外殼。如果我讓畫面硬性依賴 provider,四個測試全部要改成包一層 wrapper。改測試本身不難,但那等於用「測試配合程式」換「程式好看」,而且一旦哪天有人在別的地方單獨渲染這個畫面,它就靜靜地不動了。
所以取用的 hook 寫成這樣:
/** 外殼提供的執行器狀態;沒有外殼時退回畫面自己開一個
 *  (單獨渲染、單元測試都還能跑)。 */
export function useMeshExecutor(): MeshExecutorState {
  const fromShell = useContext(Ctx);
  const local = useExecutorState(fromShell === null);
  return fromShell ?? local;
}
useExecutorState(active) 裡面所有副作用都用 active 開關,所以有 provider 的時候,那個 fallback 只是一組空殼狀態,不會重複去讀金鑰、不會重複跑迴圈。Hook 規則(每次渲染都要呼叫一樣的 hooks)也沒有被違反。
env 預種本來也掛在 Mesh 畫面上。也就是說:一支開在「設定」分頁的手機,連設定都不會被種進去。我之前推 env 檔給 iPad 的時候一直覺得「怎麼有時候要重開兩次才生效」,現在知道原因了。它跟迴圈一起搬家之後,這個症狀也一起消失。
這種修正最容易騙自己:打開 App、看畫面上寫「pull 中」、覺得好了。但畫面上那行字是 App 自己說的。
所以我完全不看畫面,改從 coordinator 那一側量:把模擬器停在「設定」分頁,然後從 coordinator 每十三秒抓一次名冊,抓十二次,只看那支手機的 presence。
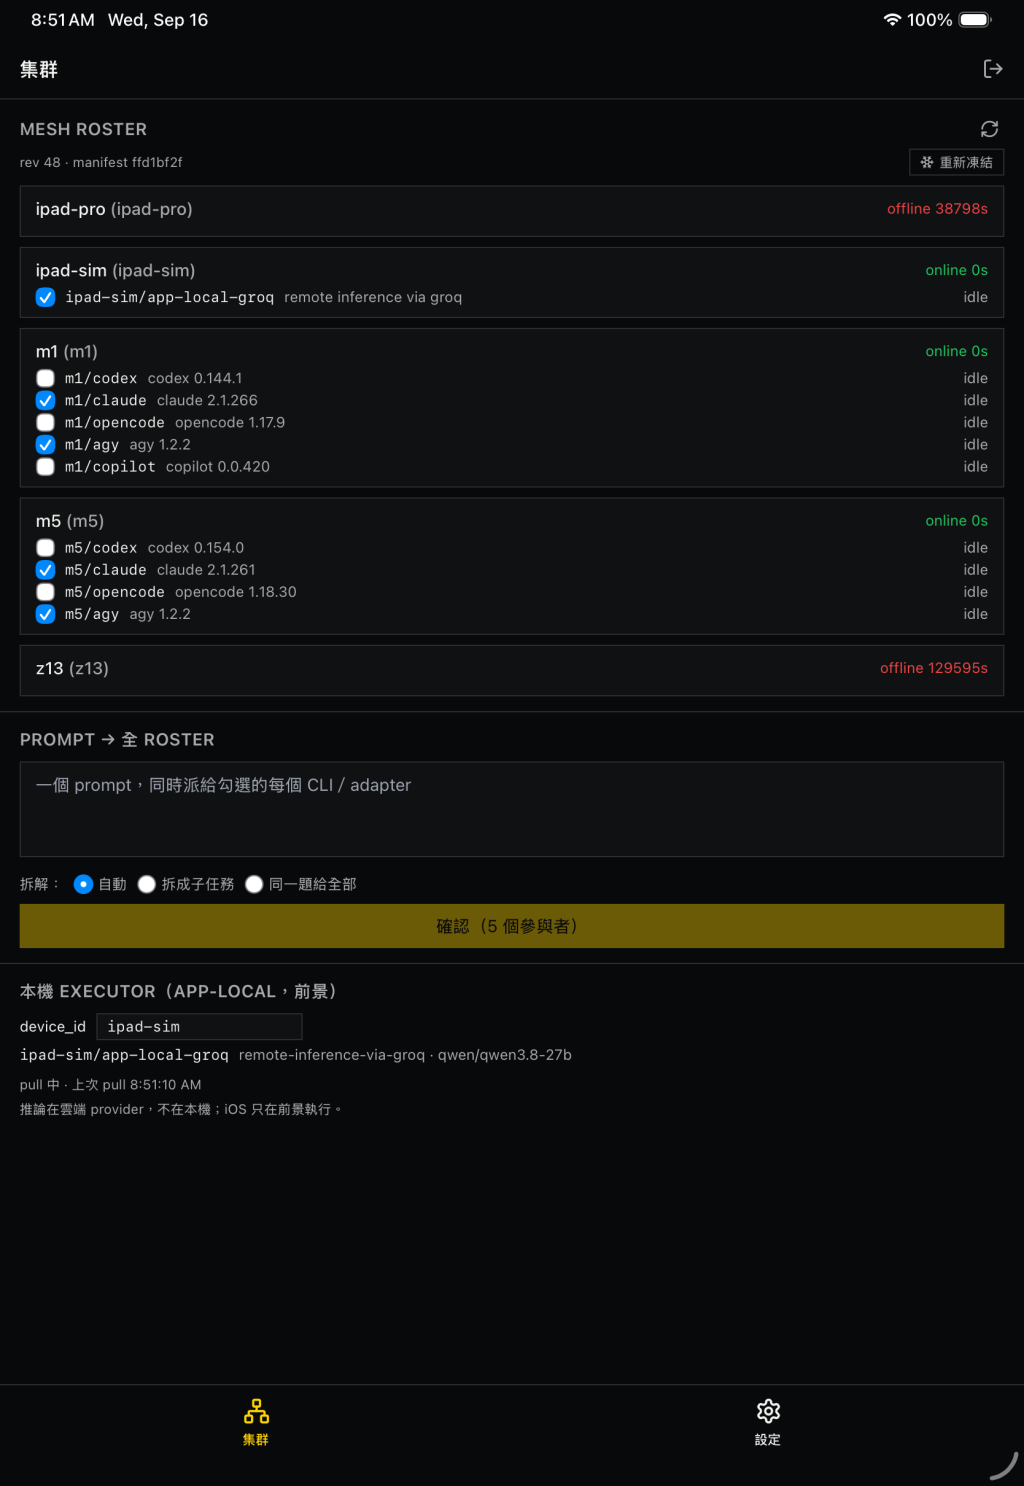
(手機停在「設定」分頁,Mesh 畫面根本沒有掛載)
{"tab":"settings","state":"online","age_s":0.0}
{"tab":"settings","state":"online","age_s":0.0}
{"tab":"settings","state":"online","age_s":0.0}
…共 12 筆,約 156 秒,全部 online、age 0 秒
age_s 是「距離最後一次 pull 幾秒」,全程 0 代表 coordinator 每次被問到的時候,那支手機都剛剛才報到過。舊版在三十秒後就會變 offline。
我喜歡這個驗證,因為它跟我的信念無關:coordinator 是另一個行程,它只知道有沒有收到 HTTP 請求。
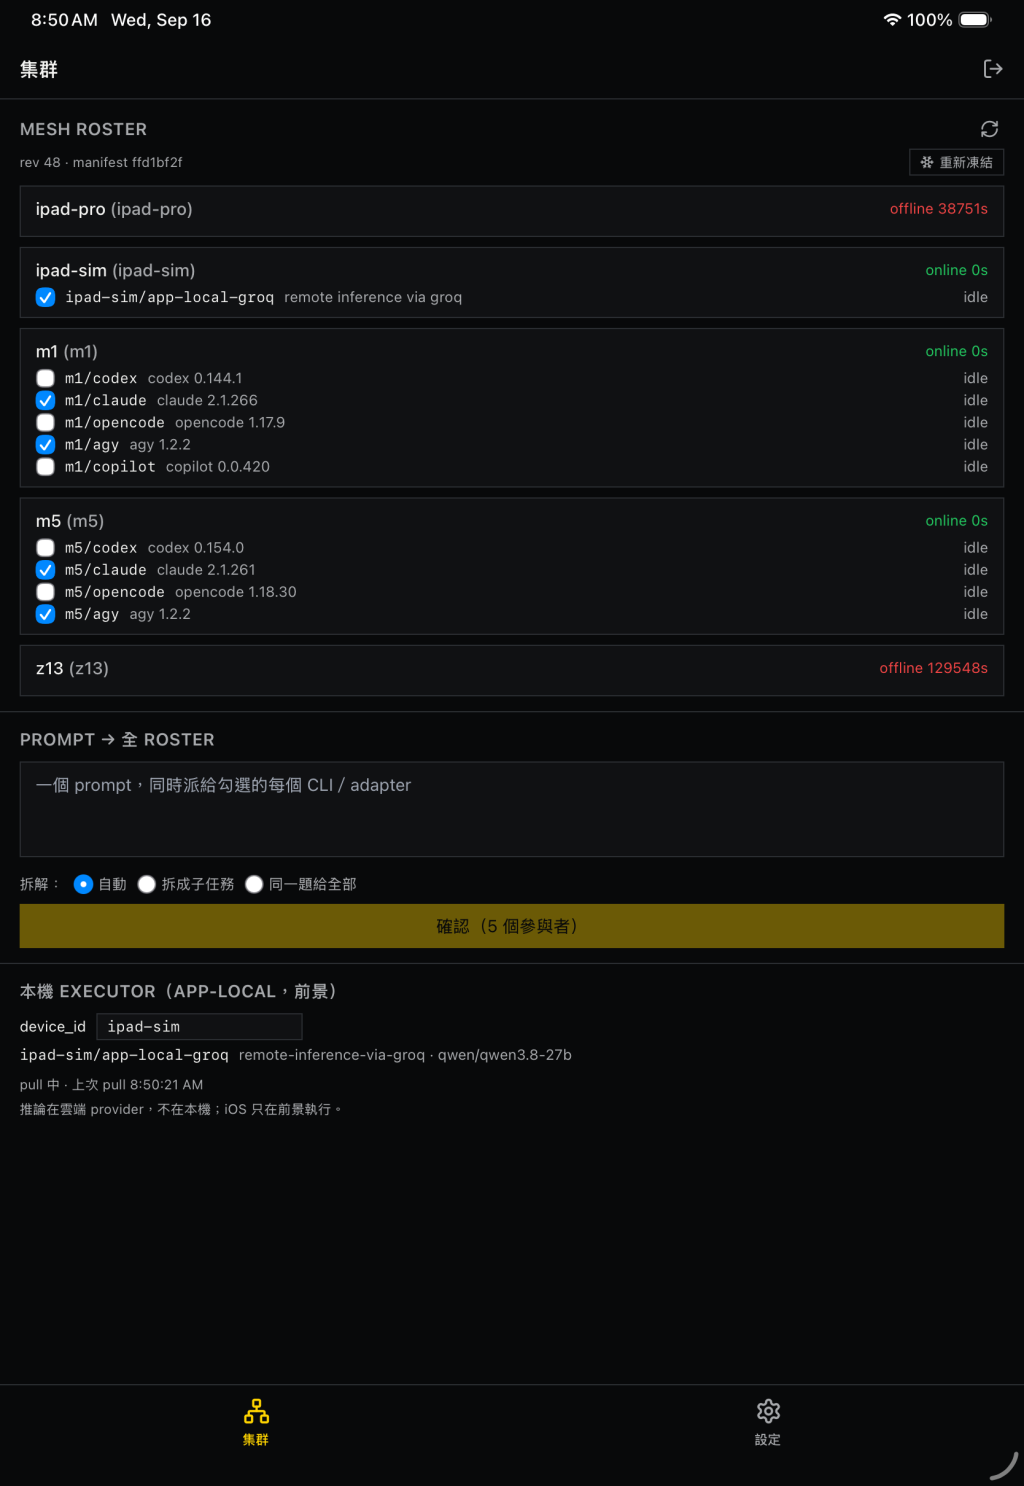
昨天 Z13 從網路上消失之後,我截了一張手機畫面。上面兩行紅字很誠實地寫著名冊拉不到、pull 逾時。但下面整排裝置還在,m1 和 m5 旁邊是綠色的 online 0s。
那個 0s 是拍快照那一瞬間的年齡,而畫面不會隨時間往上加。所以十分鐘後,它還是綠色的 online 0s。
一個只掃一眼綠字的人會以為艦隊活得好好的。這比沒有資訊更糟:它用一個曾經為真的事實,製造一個現在為假的印象。
名冊刷新失敗、而手上還有上一份成功的快照時:
opacity-50)程式上就是記住最後一次成功的時間,然後在失敗期間每秒重算一次年齡:
const rosterStale = rosterErr !== null && roster !== null;

useEffect(() => {
  if (!rosterStale) return;
  const h = setInterval(() => setStaleTick((n) => n + 1), 1000);
  return () => clearInterval(h);
}, [rosterStale]);

const snapshotAgeS = useMemo(
  // staleTick 是讓這個計算每秒重跑一次的相依
  () => (rosterStale && rosterOkAt !== null
    ? Math.max(0, Math.round((Date.now() - rosterOkAt) / 1000))
    : null),
  [rosterStale, rosterOkAt, staleTick],
);
「凍結 roster」是把當下看到的艦隊組成寫成一份 manifest,之後每次派工都要跟它逐 byte 相符。如果讓人在 coordinator 已經不可達的時候凍結一份死掉的快照,等於把一組過期的參與者變成之後所有派工的硬性要求——接下來每一次 fan-out 都會被 fail-closed 擋下來,而且錯誤訊息會指向參與者不符,沒有人會想到根因是十分鐘前凍錯了。
寧可當下按不下去,也不要事後查半小時。
這個行為用畫面測試釘住:讓名冊先正常載入,然後把 coordinator 換成會逾時的版本,斷言三件事。
it("keeps the last good roster but marks it a snapshot once the coordinator stops answering", async () => {
  render(<MobileMesh />);
  await pollUntil(() => expect(screen.getByTestId("presence-m1")).toHaveTextContent("online"));
  expect(screen.queryByTestId("roster-stale")).toBeNull();

  // coordinator 消失(Z13 離開 tailnet,2026-09-15)
  mocks.get.mockImplementation(async (p: string) => {
    if (p === "/rpc/mesh/roster") throw new Error("The request timed out.");
    return ok({ snapshot_revision: 1043, attempts: [] });
  });

  await pollUntil(() => expect(screen.getByTestId("roster-stale")).toBeInTheDocument());
  // 裝置留在畫面上——但再也不會被當成活的 online
  expect(screen.getByTestId("presence-m1")).toHaveTextContent("(快照)");
  expect(screen.getByLabelText("凍結 roster")).toBeDisabled();
});
單元測試證明的是「我的元件在假的失敗下會這樣」。我還想看到真的 App 在真的斷線下的樣子。
問題是:要製造「本來連得上、突然連不上」這個轉折,不能直接把手機指向一個死掉的網址(那樣它從頭到尾沒有成功過,也就沒有快照可留)。我需要一條可以中途拔掉的線。
做法是在 coordinator 前面架一個三十行的 TCP 轉送程式,聽 7999、轉給 7878,然後把手機指向 7999。等名冊正常載入之後,把轉送程式殺掉。對手機來說,這就是 coordinator 突然人間蒸發。
import socket, threading
def pipe(a, b):
    try:
        while True:
            d = a.recv(65536)
            if not d: break
            b.sendall(d)
    except Exception: pass
    finally:
        for s in (a, b):
            try: s.close()
            except Exception: pass

srv = socket.socket(); srv.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
srv.bind(("127.0.0.1", 7999)); srv.listen(64)
while True:
    c, _ = srv.accept()
    u = socket.create_connection(("127.0.0.1", 7878))
    threading.Thread(target=pipe, args=(c, u), daemon=True).start()
    threading.Thread(target=pipe, args=(u, c), daemon=True).start()
這種「可以中途拔掉的線」在測分散式系統的時候很好用,比改設定檔或關服務乾淨:服務本身完全沒有被動到,其他使用它的東西照常運作,只有這一條線斷掉。整段測試前後,這台 Mac 上的 daemon 一秒都沒有重啟過。
拔線前:
拔線十三秒後:
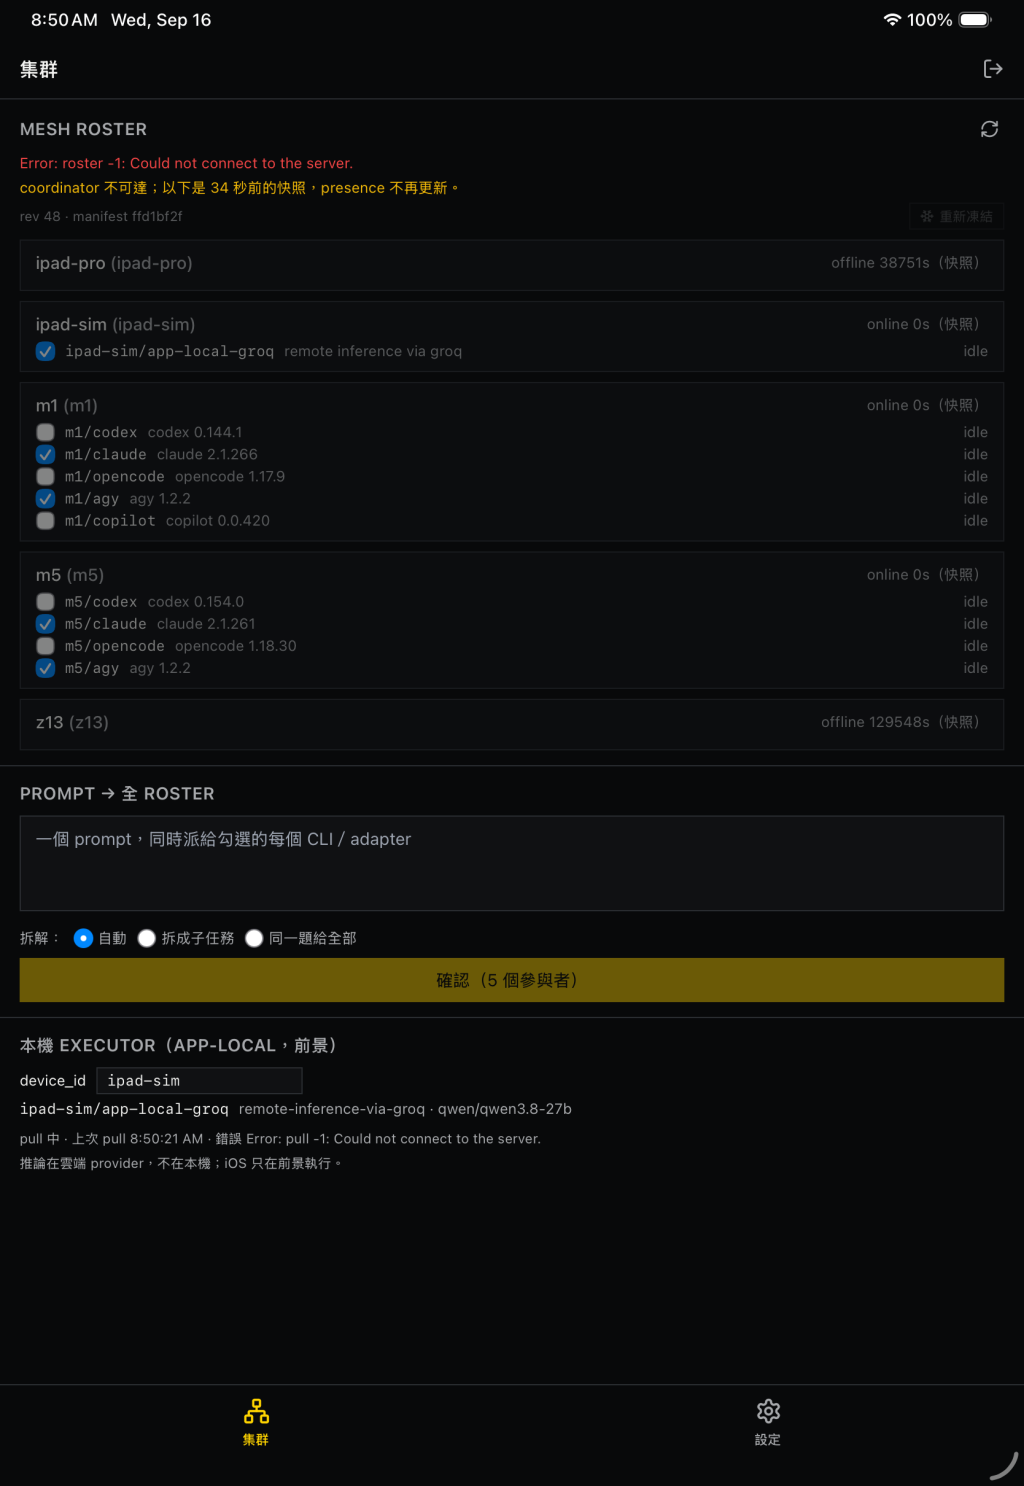
黃色那行寫著「coordinator 不可達;以下是 13 秒前的快照,presence 不再更新。」每一台裝置後面都掛著灰色的「(快照)」,整塊淡掉,凍結鈕變成不能按。這正是我要的:畫面把自己知道的和不知道的分開講。
這一段的細節寫在今天另一個系列那篇(Day 03|評估|做),這裡只講結論和動機。
前天那次 12 台的 fan-out,我在文章裡寫「planner 拆出 12 份子任務,最後只有 3 份進了回答」。那個 3/12 是我自己翻畫面數出來的。沒有定義、沒有來源、下次也不會自動重算。
今天把它變成程式:把每份輸出切成十二個字元一段的片段,扣掉和題目重疊的部分,看有多少比例出現在最終合併的回答裡,超過 15% 就記為被重用。三個單元測試釘住語意。
它只測逐字重用,改寫不算,所以永遠是下限。這句話我寫在函式註解裡,也寫在手機畫面上——指標最危險的時候不是它不準,是別人以為它準。
修完三件事,跑一次真的 fan-out 驗收。
五個參與者:m1 上的 claude 和 agy、m5 上的 claude 和 agy、iPad 上的 app-local 模型。題目是「用白話跟新同事解釋這個 mesh 怎麼把一個 prompt 跑遍多台機器,200 字以內」。拆解模式選「拆成子任務」。
結果:
| 參與者 | 結果 |
|---|---|
| m5/claude | 完成 |
| m5/agy | 完成 |
| iPad 的 app-local 模型 | 失敗:incomplete_receipt: nonce not echoed |
| m1/claude | 從頭到尾排隊 |
| m1/agy | 從頭到尾排隊 |
先看 planner 這次怎麼拆。同一題「用白話解釋這個 mesh 怎麼運作、200 字以內」,它派出去的子任務是:
拆得其實不差:一個寫草稿、三個去查證、一個當編輯。問題在於它假設每個工人都能讀到專案檔案,而這次派工的 scope 是唯讀且不給工具(read-only-no-tools)。m5/claude 的回答第一句就是「我沒辦法對照專案檔案,這個工作階段禁止瀏覽檔案,而且草稿本文也沒有放進訊息裡」——它照樣寫出了一份好答案,但它是照著題目描述寫的,不是照著程式碼寫的。
換句話說,planner 拆出來的五份工作裡,有四份的前提在派工當下就不成立。這件事昨天的 12 台那輪也發生過(那次是拆出「字數稽核」「投影片大綱」這類 meta 工作)。planner 不知道工人手上有什麼權限,是這個系統現在最具體的一個缺口。
iPad 那份的內容其實寫得很好,用了一個派對籌備的比喻解釋協調者和工人。但它被判失敗,錯誤是「收據不完整:輸出裡沒有回顯 nonce」。
原因是兩個各自合理的決定:
答案寫滿了 256 token,nonce 在結尾,被截掉了。於是一份正確的回答被判為造假。
這條我不自己偷改,寫成給契約的備註:nonce 要嘛允許放在輸出開頭,要嘛另外開一個欄位回傳,不要要求它出現在一段長度受限的自由文字的尾巴。
m1 的 daemon 是活的,/api/version 有回應,名冊上它是 online。但那兩個 attempt 就停在排隊,一動也不動。
那是別人的機器。我查到「可達但不接手」就停手,寫進報告交給那個節點自己查。跨機除錯最容易出事的就是熱心。
我按了停止。契約第 4.3 條寫得很清楚:停止指令送出後,畫面只能寫「停止中」,要等到終止事件才准寫「已停止」;超過三十秒沒有終止事件的 attempt 標成「未知」。
於是畫面變成:任務「停止中」,m1 那兩個 attempt 顯示「未知 · process tree 尚未退出」。行為完全正確,契約沒有錯,實作也沒有錯。
但結果是:三份已經完成、內容正確的輸出,使用者一份整合回答都拿不到。
因為我的合併是在任務「終止」時才觸發的。而任務永遠不會終止,因為有一個節點安靜了。
一個節點安靜,另外三個節點的成果全部作廢。這不是契約的錯,是我的介面把「有沒有答案可看」綁死在「任務有沒有收乾淨」上。這兩件事在分散式系統裡本來就不該綁在一起——前者是使用者的需求,後者是系統的內務。
任務還沒完成、但已經有可合併的輸出時,畫面出現一顆按鈕:
先用已完成的 N 份輸出彙整(其餘未回報)
按下去就用手上有的東西產出完整回答,括號裡誠實寫著有幾份沒回報。
{synth.status === "idle" && mergeableCount > 0 && shownTask !== "completed" && (
  <button onClick={() => void synthesize()} data-testid="merge-now">
    先用已完成的 {mergeableCount} 份輸出彙整(其餘未回報)
  </button>
)}
按鈕上那句「(其餘未回報)」是刻意寫進去的。使用者按下這顆按鈕拿到的東西,和五台全部回報之後拿到的東西,在畫面上長得一模一樣——如果不標示,兩者就分不出來了。系統可以降級,但不能讓降級的結果看起來像完整的結果,這跟修正二的「(快照)」是同一條原則。
再跑一次同樣的題目,按鈕如期出現,按下去,完整回答出來了,下面帶著今天做的重用率:
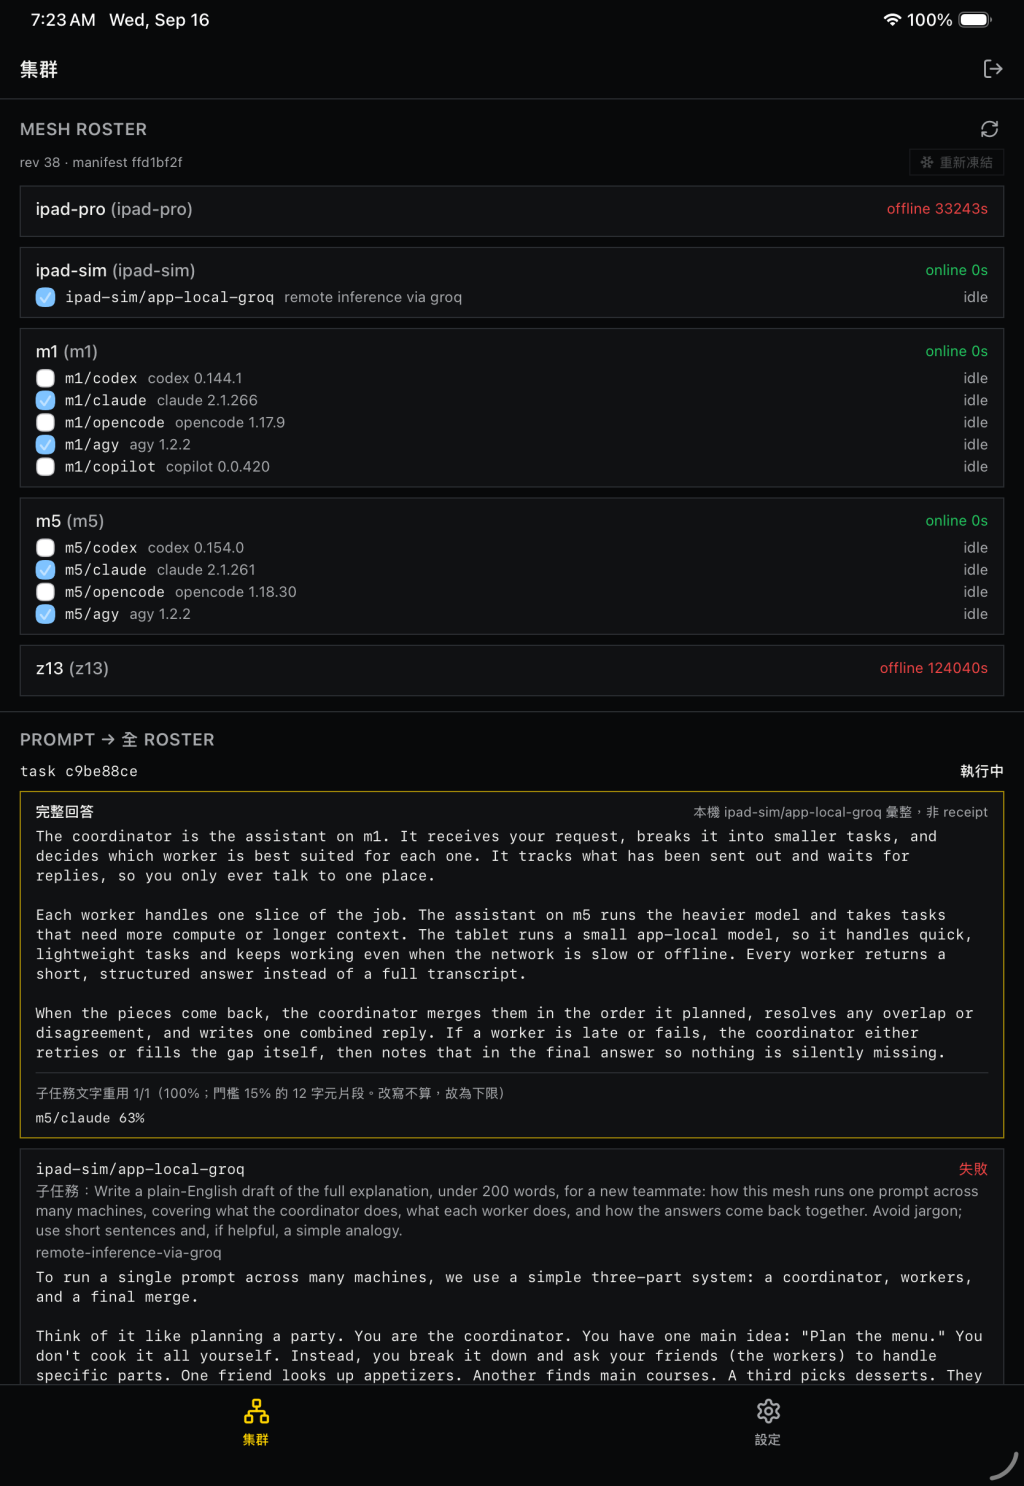
子任務文字重用 1/1(100%;門檻 15% 的 12 字元片段。改寫不算,故為下限)
m5/claude 63%
五個位置,一份成品。數字很難看。但它是程式算的,不是我數的,而且下次會自動再算一次。
| 項目 | 結果 |
|---|---|
| pull 迴圈脫離分頁 | 已驗證:設定分頁停 156 秒,coordinator 全程看到 online、age 0 秒 |
| 名冊快照誠實化 | 已驗證:畫面測試 + 真 App 拔線實測(13 秒前快照) |
| 子任務重用指標 | 已驗證:3 個單元測試 + 真跑一次 |
| 卡在「停止中」拿不到回答 | 當天發現、當天修 |
| 測試 | 30 個全綠 |
| 型別檢查 | 0 錯 |
| commit | eb2012b6 |
| coordinator | 仍是本機 daemon;Z13 整天離線 |
nonce not echoed 對手機端是可預期的失敗模式,因為輸出上限會截掉尾端。建議允許 nonce 放在輸出開頭,或另立欄位回傳。三個修正裡,最有價值的不是任何一個修正本身,而是它們的共同形狀:每一個都是「程式做的事」和「契約說的事」之間的縫。
三次都不是有人寫錯 code,是實作在契約沒有明說的地方自己補了一個假設,而那個假設在正常情況下看不出來,只有在某個節點安靜、某台機器離線、某個使用者停在別的分頁的時候才會現形。
所以今天結束時我加了一條個人規則:每次寫「什麼時候要做 X」的條件式,先回去看契約那句話的主詞是什麼。 是 App?是畫面?是任務?是裝置?主詞錯了,程式就會在邊角崩塌。
Z13 回來的話,用同一組腳本對它重跑一次,把數字補進 Day 18 那篇。不回來就繼續在本機做下一件事:讓每次 fan-out 把「派幾份、完成幾份、重用幾份」寫成一行紀錄存下來,這樣重用率才有機會累積成趨勢,而不是每次都是孤零零的一個數字。


 iThome鐵人賽
 看影片追技術