
昨天我們用 Python 啟動 Discord Bot,也完成了第一個 !hello 文字指令。
不過,現在的 Bot 只會執行預先寫好的程式,還不具備理解問題與產生回答的能力。要讓它成為可以協助工作的 AI 員工,下一步就是準備語言模型。
今天先不急著把模型接進 Discord,而是安裝 Ollama,並在自己的電腦上執行 qwen3.5:4b。完成後,我們會直接從終端機輸入中文問題,確認本地模型可以正常回覆。
qwen3.5:4b
使用大型語言模型時,常見的做法可以分成兩種:
兩種方式都能讓程式取得 AI 回覆,但執行模型的位置不同。
| 比較項目 | 本地模型 | 雲端 API |
|---|---|---|
| 模型執行位置 | 自己的電腦 | 服務供應商的伺服器 |
| 網路需求 | 模型下載完成後,可在本機推論 | 呼叫模型時需要連線 |
| 資料傳送 | 提示詞可以留在本機處理 | 提示詞需要傳送給 API 服務 |
| 費用方式 | 主要使用自己的硬體資源 | 通常依使用量計費 |
| 硬體需求 | 需要足夠的記憶體、儲存空間與運算能力 | 本機硬體需求較低 |
| 模型能力 | 受到本機可執行模型大小的限制 | 通常可以使用較大型的模型 |
| 維護工作 | 自己下載、更新與管理模型 | 由服務供應商維護模型環境 |
本地模型不一定比雲端 API 好,雲端 API 也不一定適合所有情況。
如果重視快速開發、模型能力與服務擴充,雲端 API 通常比較方便。如果希望在自己的電腦測試模型、減少每次呼叫的費用,或讓提示詞留在本機處理,本地模型會是另一種選擇。
這個系列先使用本地模型,目的是了解 Discord Bot、Python 程式與語言模型之間如何連接。
Ollama 是一個在本機下載、管理與執行語言模型的工具。
它把模型啟動與推論流程包裝成簡單的指令。安裝完成後,可以使用類似以下的方式執行模型:
ollama run qwen3.5:4b
Ollama 負責下載與載入模型,接收問題後在本機產生回答;之後 Python 也會透過它呼叫 Qwen。
模型名稱中的 4b,代表模型大約有 40 億個參數。一般來說,參數越多,模型檔案與執行時需要的記憶體也會增加。
Qwen 3.5 在 Ollama 提供多種大小,可以依照電腦狀況選擇:
| 模型 | 官方模型檔大小 | 適合情況 |
|---|---|---|
qwen3.5:0.8b |
約 1.0 GB | 硬體資源有限,先確認流程能否執行 |
qwen3.5:2b |
約 2.7 GB | 希望降低記憶體與運算負擔 |
qwen3.5:4b |
約 3.4 GB | 在速度、資源需求與回答能力之間取得平衡 |
qwen3.5:9b |
約 6.6 GB | 電腦有更多記憶體與運算資源 |
模型檔大小不等於實際執行需要的記憶體。Ollama 還需要載入模型權重、上下文與其他執行資料,實際需求會受到模型格式、上下文長度、CPU、GPU 與作業系統影響。
如果不確定自己的電腦適合哪個版本,可以先從較小的模型開始。確認速度與記憶體使用情況後,再逐步換成更大的模型。
今天選擇:
qwen3.5:4b
它的規模比 0.8B、2B 大,但比 9B 以上的版本更容易在一般個人電腦上測試。
模型標籤與檔案大小可以在 Ollama 的 Qwen 3.5 模型頁面確認。
前往 Ollama 官方下載頁面,依照自己的作業系統選擇 macOS、Windows 或 Linux 版本。
macOS 或 Linux 也可以使用官方安裝指令:
curl -fsSL https://ollama.com/install.sh | sh
安裝完成後,執行:
ollama --version
如果終端機顯示 Ollama 版本資訊,代表指令已經可以使用。
使用 macOS 或 Windows 應用程式時,開啟 Ollama 後,服務通常會在背景執行。
如果使用命令列環境,或服務尚未啟動,可以執行:
ollama serve
這個終端機需要保持執行。接下來可以另外開啟一個終端機視窗,繼續下載與測試模型。
如果 Ollama 應用程式已經在背景執行,就不需要重複執行 ollama serve。
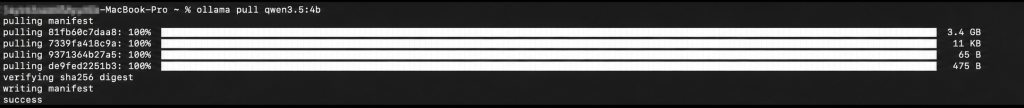
執行:
ollama pull qwen3.5:4b
Ollama 會開始下載模型檔案。所需時間會受到網路速度影響。
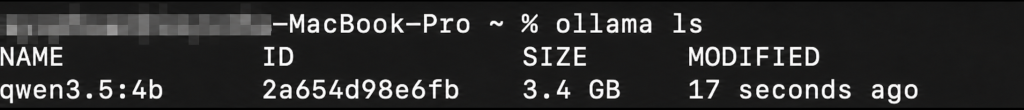
下載完成後,可以查看目前已安裝的模型:
ollama ls
清單中應該可以看到:
qwen3.5:4b
執行以下指令進入對話模式:
ollama run qwen3.5:4b
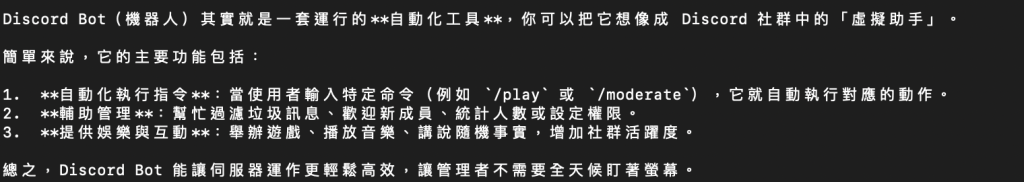
看到輸入提示後,可以測試一個簡單的繁體中文問題:
請使用繁體中文,簡單說明什麼是 Discord Bot。
模型預期會直接在終端機產生中文回答。
這裡的回答內容不需要和文章範例完全相同。語言模型每次產生的文字可能不同,重點是確認:

輸入以下指令可以離開對話模式:
/bye
第一次執行 ollama run qwen3.5:4b 時,Ollama 需要先把模型載入記憶體。因此,從送出問題到開始出現回答,中間可能需要等待比較久。
模型載入後,如果它仍然保留在記憶體中,後續問題通常可以省去大部分載入時間。不過,實際速度仍然會受到硬體、問題長度、回答長度與當下系統負載影響。
可以輸入相同問題兩次,分別記錄:
| 測試 | 模型載入時間 | 回答總時間 |
|---|---|---|
| 第一次執行 | 4.46s | 86s |
| 第二次執行 | 0.32s | 97s |
這裡記錄的是自己電腦上的實際結果,不需要和其他人的數字相同。
也可以使用以下指令查看目前載入中的模型:
ollama ps
如果清單中仍然顯示 qwen3.5:4b,代表模型還在執行或保留於記憶體中。
如果要主動停止模型,可以執行:
ollama stop qwen3.5:4b
第一次跟第二次回答的等待時間記錄

qwen3.5:4b 已經能在終端機回答繁體中文問題。第一次測試的模型載入時間是 4.46 秒,第二次降到 0.32 秒,表示模型留在記憶體後確實省下了載入時間。
不過,第二次的回答總時間反而從 86 秒增加到 97 秒。模型載入較快,不代表整次回答一定比較快,回答長度和當時的系統負載也會影響結果。
下一步會用 Python 呼叫 Ollama API,不再依靠終端機手動輸入問題。


 iThome鐵人賽
 看影片追技術