
昨天我們安裝了 Ollama,也成功在終端機執行 qwen3.5:4b。
不過,目前還是由人手動輸入 ollama run 與模型對話。Discord Bot 如果要使用 Qwen,就必須讓 Python 程式可以主動送出問題並取得回答。
今天要使用 httpx.AsyncClient 呼叫 Ollama 的 /api/chat,並把這段邏輯整理到 services/llm_serviceapi.py。除了取得模型回答,也會加入逾時、錯誤處理與推論統計。
這次先把範圍放在一條完整流程:使用 httpx.AsyncClient 呼叫 Ollama API,將 stream 設為 false,再從回應中取出 message.content。程式會放進 services/llm_serviceapi.py,並一起處理逾時、連線錯誤、請求時間與 Token 統計。
Ollama 啟動後,會在本機提供 HTTP API。Python 不需要直接操作模型檔案,只需要把問題送到 API:
Python 程式
    ↓ HTTP POST
http://localhost:11434/api/chat
    ↓
Ollama
    ↓
qwen3.5:4b
    ↓ JSON
Python 取得回答與統計
今天使用 /api/chat,因為它以對話訊息的形式接收內容。每一則訊息包含:
role:訊息角色,例如 user 或 assistant
content:實際的訊息內容這個格式之後也能擴充成多輪對話。
Discord Bot 與 Ollama 都需要等待回應。如果這段等待阻塞了整個程式,Bot 就可能來不及處理其他事件。
httpx.AsyncClient 提供非同步 HTTP 請求,可以搭配 async 與 await 使用:
async with httpx.AsyncClient() as client:
    response = await client.post(url, json=payload)
等待 Ollama 回覆時,Python 還能處理其他非同步工作,也比較容易接回 discord.py。
先啟用 Python 虛擬環境,再安裝 httpx:
python -m pip install httpx
接著更新 requirements.txt:
python -m pip freeze > requirements.txt
今天會用到以下檔案:
Ai-Company/
├── services/
│   ├── __init__.py
│   └── llm_serviceapi.py
├── tests/
│   └── test_llmserviceapi.py
├── bot.py
├── manual_testapi.py
└── requirements.txt
llm_serviceapi.py:使用 HTTPX 呼叫 Ollama APImanual_testapi.py:真的連線到本機 Ollama,確認整體流程test_llmserviceapi.py:使用 Fake Response 測試程式邏輯,不會真的啟動模型專案中的
llm_service.py是使用 Ollama 官方 Python 套件的版本;今天聚焦在直接呼叫 HTTP API 的llm_serviceapi.py。
我用 dataclass 把回答與統計資料整理在一起:
from dataclasses import dataclass


@dataclass(frozen=True)
class LLMUsageAPI:
    request_duration_seconds: float
    total_duration_ns: int | None
    load_duration_ns: int | None
    prompt_tokens: int | None
    completion_tokens: int | None

    @property
    def total_tokens(self) -> int | None:
        if self.prompt_tokens is None or self.completion_tokens is None:
            return None
        return self.prompt_tokens + self.completion_tokens


@dataclass(frozen=True)
class LLMResponseAPI:
    content: str
    usage: LLMUsageAPI
呼叫服務後,回答放在 result.content,時間與 Token 則放在 result.usage。
接著建立服務類別:
import os
import time

import httpx


DEFAULT_OLLAMA_HOST = "http://localhost:11434"
DEFAULT_OLLAMA_MODEL = "qwen3.5:4b"


class LLMServiceAPIError(RuntimeError):
    pass


class LLMServiceAPI:
    def __init__(
        self,
        host: str | None = None,
        model: str | None = None,
        timeout: float = 120.0,
        transport: httpx.AsyncBaseTransport | None = None,
    ) -> None:
        self.host = (
            host or os.getenv("OLLAMA_HOST", DEFAULT_OLLAMA_HOST)
        ).rstrip("/")
        self.model = model or os.getenv(
            "OLLAMA_MODEL", DEFAULT_OLLAMA_MODEL
        )
        self.timeout = timeout
        self.transport = transport
程式會優先使用傳入的參數,其次讀取環境變數,最後才使用預設值。
transport 在正式執行時保持為 None。單元測試則能傳入 httpx.MockTransport,用 Fake Response 驗證請求與解析邏輯。
chat() 會先準備傳給 Ollama 的 JSON:
async def chat(self, message: str) -> LLMResponseAPI:
    payload = {
        "model": self.model,
        "messages": [
            {
                "role": "user",
                "content": message,
            }
        ],
        "stream": False,
    }
其中:
model 指定 qwen3.5:4b
messages 放入使用者訊息stream: false 要求 Ollama 等回答完成後,一次回傳完整 JSONOllama 的 /api/chat 預設使用串流回覆。今天先將它設為 false,讓回應解析保持單純。
語言模型產生回答需要時間,因此服務預設等待 120 秒:
started_at = time.perf_counter()

try:
    async with httpx.AsyncClient(
        timeout=self.timeout,
        transport=self.transport,
    ) as client:
        response = await client.post(
            f"{self.host}/api/chat",
            json=payload,
        )
        response.raise_for_status()
except httpx.TimeoutException as error:
    raise LLMServiceAPIError(
        "Ollama 回應逾時,請稍後再試。"
    ) from error
except httpx.HTTPStatusError as error:
    raise LLMServiceAPIError(
        f"Ollama API 回傳錯誤狀態:{error.response.status_code}。"
    ) from error
except httpx.RequestError as error:
    raise LLMServiceAPIError(
        "無法連線到 Ollama,請確認服務是否已啟動。"
    ) from error

request_duration = time.perf_counter() - started_at
這裡處理三類問題:
TimeoutException:模型未在設定時間內完成回覆HTTPStatusError:API 回傳 4xx 或 5xx 狀態碼RequestError:Ollama 沒有啟動、網址錯誤或其他連線問題response.raise_for_status() 會檢查 HTTP 狀態碼,避免程式把錯誤回應當成模型回答。
當 stream 設為 false,Ollama 會一次回傳完整 JSON。回答位於:
{
  "message": {
    "role": "assistant",
    "content": "模型產生的回答"
  }
}
程式先將 Response Body 轉成 Python dict,再檢查 message.content:
try:
    data = response.json()
except ValueError as error:
    raise LLMServiceAPIError(
        "Ollama 回傳的資料不是有效 JSON。"
    ) from error

message_data = data.get("message")
content = (
    message_data.get("content")
    if isinstance(message_data, dict)
    else None
)

if not isinstance(content, str) or not content.strip():
    raise LLMServiceAPIError(
        "Ollama 回傳內容缺少 message.content。"
    )
除了確認欄位存在,也會排除空字串,避免 Discord Bot 收到無法顯示的內容。
這次會記錄兩種資料。
request_duration_seconds 是從 Python 送出請求,到完整收到回應的實際等待時間。
Ollama 的回應還包含:
total_duration:整次請求的處理時間load_duration:載入模型所花的時間prompt_eval_count:輸入 Token 數量eval_count:輸出 Token 數量Ollama 的 duration 欄位使用奈秒,因此程式以 _ns 結尾保留原始單位:
usage = LLMUsageAPI(
    request_duration_seconds=request_duration,
    total_duration_ns=data.get("total_duration"),
    load_duration_ns=data.get("load_duration"),
    prompt_tokens=data.get("prompt_eval_count"),
    completion_tokens=data.get("eval_count"),
)

return LLMResponseAPI(
    content=content.strip(),
    usage=usage,
)
輸入與輸出 Token 都存在時,total_tokens 屬性會將兩者相加。
manual_testapi.py 會真的呼叫本機 Ollama,用來確認 Python、HTTP API 與 qwen3.5:4b 可以一起運作:
import asyncio

from services.llm_serviceapi import (
    LLMServiceAPI,
    LLMServiceAPIError,
)


async def main():
    service = LLMServiceAPI(timeout=300)

    try:
        result = await service.chat(
            "請使用繁體中文,簡單說明什麼是 Discord Bot。"
        )
    except LLMServiceAPIError as error:
        print(f"測試失敗:{error}")
        return

    print(f"回答:{result.content}")
    print(f"Prompt Token:{result.usage.prompt_tokens}")
    print(f"輸出 Token:{result.usage.completion_tokens}")
    print(f"總 Token:{result.usage.total_tokens}")
    print(
        f"請求耗時:"
        f"{result.usage.request_duration_seconds:.3f} 秒"
    )


if __name__ == "__main__":
    asyncio.run(main())
確認 Ollama 已經啟動,再執行:
python manual_testapi.py
執行成功後,終端機會顯示 Qwen 的回答、輸入與輸出 Token,以及 Python 實際等待的時間。
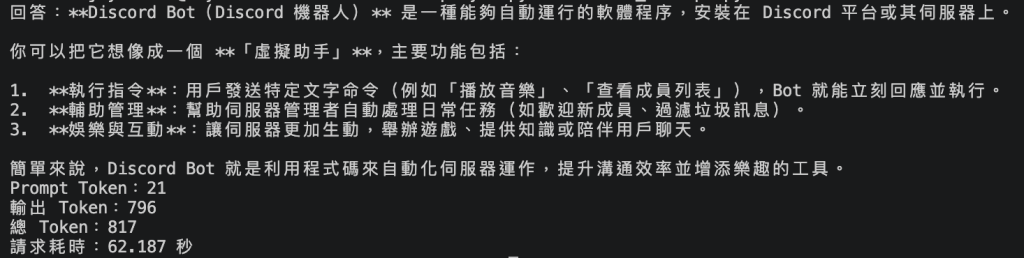
test_llmserviceapi.py 的用途不同。它使用 Fake Response 快速檢查程式邏輯,不會真的呼叫 Ollama;manual_testapi.py 才是確認本機模型整合是否成功。
執行 manual_testapi.py 後,Python 已經能把 Prompt 交給本機的 qwen3.5:4b,再取得 message.content、請求時間與 Token 統計。逾時、HTTP 狀態和連線問題也統一轉成 LLMServiceAPIError。
這些細節都留在 services/llm_serviceapi.py。Discord Bot 之後只要呼叫 LLMServiceAPI.chat(),不用再把 HTTP 請求和回應解析寫進 bot.py。


 iThome鐵人賽
 看影片追技術