
情境是這樣的:你寫了一份 Markdown —— 可能是內部教學、可能是給新人的上手文件,也可能就是這 30 天的某一篇。然後有人問你要 Word,有人問你有沒有 簡報,有人說 傳個連結給我就好。
比較糟的處理方式,是開三個不同格式的檔案各寫一次。一段時間之後,檔案開始不同步,三份內容互相矛盾,而且通常你不會馬上發現 —— 是三個月後某個同事拿著舊版本來問你才發現。
所以今天的做法只有一條:**Markdown 是唯一真相,其他格式都從它轉出來,而且永遠可以整份重生。**下面把三條路徑實際走一遍,而且是可以照抄的走法。
第一條用一支 Python 腳本,產出一個可以直接傳給別人的單一網頁。我最推薦先做這條,因為它零安裝。
# 先把腳本抓下來(純標準庫,不用裝任何東西)
curl -O https://gist.githubusercontent.com/n913239/7ae7d88cfbc51d5540201891bb1ff6f4/raw/md_to_single_html.py

python3 md_to_single_html.py 你的文章.md out.html
預期輸出:
輸出: out.html (0.06 MB)
檔案大小跟著你內嵌的圖片走 —— 沒有圖的話會小很多。
三個檢查點:
我實跑的時間是 0.025 秒。這個數字重要的不是「快」,而是它沒有相依—— 純標準庫,不用 pip install 任何東西。
給主管、給行政、給要在上面改追蹤修訂的人。
pandoc input.md -o output.docx
但你八成會卡在這裡。 我在自己機器上跑的結果是:
pandoc: command not found
這台電腦沒裝 pandoc,先裝:brew install pandoc(3.11)。裝完把 Day 2、Day 3 當時的草稿丟進去轉,每篇大約 0.1 秒。
轉出來會遇到兩件事,而且它們都不會報錯:
bottom,儲存格之間沒有框線。兩篇草稿、13 張表,tblBorders 是 0 個。containerization 被折成兩行、ContainerizationError 折成三行 —— 它按內容平均分欄,不管哪一欄裝的是不能斷的長字。第二件事我差點漏掉。一開始我是把 .docx 解開,直接讀 XML 驗的:每一欄的寬度都正常,最窄也有 0.75 吋,於是判斷欄寬沒問題。轉成 PDF 真的看一眼,containerization 才斷成 containeri / zation 兩行 —— 那一欄裝的是 16 個字元、中間沒有任何斷點的英文字。數字是對的,結論是錯的。 讀 XML 告訴你檔案裡寫了什麼;看渲染結果,才是使用者真正會看到的 —— 所以下面的檢查點全部改成「打開來看」,一個都不靠讀 XML。
檢查點(每一個都要真的把檔案打開):
docx skillpandoc 是「一行指令」的代表;另一個代表是 Anthropic 官方的 docx skill(Day 4 裝來試的那包 document-skills 裡的一個)。它的做法完全不同:Claude 讀你的 md,寫一支 docx-js 腳本、跑一次,再照 skill 裡的流程轉 PDF、出圖、自己看一遍。 同一份 day02.md,我用 claude -p 無人值守跑了一次,要求跟上面三個檢查點一樣:
| pandoc | 官方 docx skill |
|
|---|---|---|
| 怎麼做 | 一行指令 | 寫一支 21.9 KB 的 md2docx.js,自己解析 md 再組 docx |
| 時間 · 成本 | 0.33 秒 · 0(這次帶 4 張圖,比上面的 0.1 秒慢) | 12 分鐘 · $3.64(48 回合) |
| 表格框線 | ❌ 只有標題列一條 | ✅ 四邊都有 |
| 長英文字沒折斷 | ❌ containerization 斷成兩行 |
✅ 一個都沒斷 |
| code 等寬 | ✅ | ✅(Menlo) |
| 再跑一次 | 決定性 | 腳本是決定性的(0.19 秒,內容逐位元相同);寫腳本那 12 分鐘不是 |
| 相依 | pandoc 279 MB | Node + docx 套件(SKILL.md 說「已預裝」,我的機器上沒有,它自己 npm install);驗證還要 LibreOffice |
同一張表,兩邊渲染出來長這樣(LibreOffice 轉 PDF 後截的):
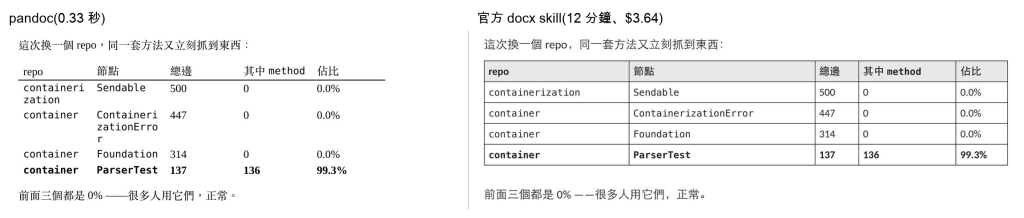
三個檢查點它全過,而且過的方式值得記:欄寬不是平均分,是先量每一格最長的不可斷 token保底,剩下的再按比例分;塞不下就把那張表的字級縮 0.5pt 直到剛好 —— 這正是 pandoc「按內容平均分欄」做不到的事。
但這張表要整張看,不能只看打勾。它用 12 分鐘和 $3.64 換來的東西,是一支之後 0.19 秒就能重跑的腳本 —— 所以它跟今天的規則不衝突:md 還是唯一真相,腳本存進 repo,產物一樣整份重生。衝突的只有一件事:那支腳本本身不是決定性產物,下次再叫它寫,長出來的不會是同一支。所以腳本要存,不要每次重生。
npx --yes @marp-team/marp-cli --no-stdin input.md -o slides.html
--no-stdin 不是可有可無的。 我第一次照官方那行寫(沒加它),在腳本裡跑 —— 它掛了 37 分鐘。
不是在下載。套件早就抓完了,129 MB 躺在 ~/.npm/_npx/ 裡。我去看那個 process:**CPU 0%、沒有任何網路連線、狀態 S(睡眠)。**它在等 stdin,而腳本裡沒有 tty,所以它會等到天荒地老。
加上 --no-stdin:1.38 秒。
37 分鐘和 1.38 秒的差別,是一個旗標。而它「失敗」的樣子是安靜地不結束 —— 沒有錯誤訊息可以 Google。
Marp 的規則是用 --- 分頁,所以你的 Markdown 得先為它調整 —— 這條路對原始檔的侵入性最高:它會逼你把文章寫成投影片的節奏。
而「侵入性最高」具體長這樣。我丟一頁 15 個項目符號進去:
slides.html 照樣產出來。程式碼區塊倒是沒被切 —— Marp 會自動縮字級去把它塞進去。兩行都塞下了,代價是字變小;行再長一點就會小到看不清楚。
檢查點:
要把每一頁輸出成圖來檢查:
npx --yes @marp-team/marp-cli --no-stdin --images png input.md—— 但這一步會叫起 Chrome(5.73 秒),純 HTML 那步不用。
上面三條是我實跑過的。同一件事還有很多人用別的工具做,列在這裡讓你挑;這一節我沒跑,只查了。星數是 2026-09-16 從 GitHub 抓的,會一直變,看量級就好:
| 要產什麼 | 工具 | 星數 | 什麼時候選它 |
|---|---|---|---|
| Word / 簡報 / PDF | Anthropic 官方 document-skills(docx / pptx / pdf / xlsx)—— docx 那支練習二實跑過了 |
— | 要 AI 直接產、格式要細(它底下是 docx-js、python-pptx 這些函式庫,產出的是腳本,腳本存下來一樣能重生) |
| 簡報 | Slidev / reveal.js | 48.7k / 72.3k | 要動畫、要互動、簡報是主角;Marp(3.8k)是三者裡最接近純 Markdown 的 |
| 簡報 / 原型 | Claude Design(claude.ai 內建,2026-04 上線,Pro 以上) | — | 用描述直接產 PPTX / HTML / PDF,不用先把 md 改成投影片節奏;代價是產物不是從你的 .md 決定性長出來的,同一段描述兩次結果不同 —— 跟「可整份重生」相衝 |
| Typst | 56.0k | 要排版精確又不想碰 LaTeX;但它是自己的語法,不是 Markdown | |
| 整個文件站 | mdBook / MkDocs | 22.1k / 22.4k | 不是一篇,是一整本 |
| 學術 / 報告 | Quarto | 6.0k | pandoc 的上層,要嵌程式輸出(圖表、表格)進文件 |
還有一個**「反方向」的類別,跟今天的規則剛好互補:把別人給你的 Word、PDF、簡報變回 Markdown**。MarkItDown(微軟,184k)、Docling(IBM,66.5k)、MinerU(80.0k)都是為了餵 LLM 而生的。一行 markitdown 檔案.docx > 檔案.md,就能把「唯一真相」搬回 .md。你接手一份只有 Word 的文件時,第一步就是它 —— 先變回真相,再從真相往三條路產。
前面都在處理文字。但你的文章不是只有文字 —— 有封面、有流程圖,而這兩種圖的來源完全不同,能不能重生也完全不同。
封面和插畫交給 Gemini 或 ChatGPT,這件事它們比任何程式都強。問題在於:同一個 prompt 跑兩次,你不會拿到同一張圖。
所以它牴觸了今天那條規則 —— 產物要能整份重生,而生成的圖不能。
解法不是放棄,而是把 prompt 跟圖放在一起:
<!-- Gemini prompt: 科技/專業簡報風格、深藍灰底、扁平化、無襯線黑體白字、16:9,
     一個人的剪影站在一張巨大的知識圖前面,圖上只有三個節點是亮的 -->
你保住的不是那張圖,是「再產一張同風格的圖」的能力。
而畫風那一串要寫死。我固定用「科技/專業簡報風格、深藍灰底、扁平化、無襯線黑體白字、16:9」,三十篇下來才會看起來像同一個系列 —— 一致性靠的不是模型的記性,而是那行註解。
這裡要先講一個很多人搞混的區分。
Claude 沒有影像生成模型。 它畫不出封面,也畫不出插畫。但它可以用程式碼畫圖 —— mermaid、SVG、p5.js,都是文字。claude.ai 上的 Claude Design 也是同一類:它畫的是 HTML,不是像素。
flowchart LR
    MD[index.md] --> HTML[單一 HTML]
    MD --> DOCX[Word]
    MD --> SLIDES[簡報]
這四行就是一張流程圖。而它跟「貼給 ChatGPT 生一張流程圖」差在哪?
改一個框。 生成的圖要重講一次 prompt、重生整張、還不保證其他地方不變;這四行你改一個字就好,而且 git diff 看得出來改了什麼。
**生成的圖適合「感覺」,畫出來的圖適合「結構」。**而技術文章裡需要精確的那些 —— 流程、架構、狀態 —— 全部是結構。
順帶一提,生成式的圖還有一個具體的毛病:**它寫不好字。**把流程圖交給生圖模型,方框裡的中文常常會變成「像字但不是字」的東西。
寫的時候不用另外裝東西就看得到圖:VS Code 從 1.121(2026-05)起,把 Mermaid 預覽內建進 Markdown 預覽;GitHub 的 README 與 issue、Notion 的程式碼區塊選 Mermaid,也都直接畫。
兩種圖,來源不同、工具不同,但真相全部都是文字:
| 圖 | 真相是什麼 | 進得了 git |
|---|---|---|
| 封面 | 那行 Gemini prompt | ✅ |
| 流程圖 | mermaid 原始碼 | ✅ |
圖是產物。產物壞了可以重生,前提是產生它的那句話還在。
而那句話該放哪裡?跟文章放在一起,放在 .md 裡 —— 因為那份 .md 本來就是唯一真相。
一份 md 走三條產出路徑,相依與代價差很多:
| 路徑 | 要裝什麼 | 首跑 | 錯誤的樣子 |
|---|---|---|---|
| 單一 HTML | 無(純標準庫) | 0.025 秒 | — |
| Word | pandoc(bottle 279.4 MB) | 0.10 秒 | 框線消失、長字折斷 |
| 簡報 | npx 現抓 129 MB | 37 分鐘 → 1.38 秒 | 內容安靜地少一截 |
docx skill 三個檢查點全過,代價 12 分鐘、$3.64;換來的是一支 0.19 秒可重跑的腳本 —— 腳本要存,不要每次重生
這一篇留下的心法:
Markdown 是唯一真相,產物永遠可以整份重生。
選工具先算相依:一年跑兩次的挑功能最強的,**每天要跑的挑明年還會在的那個。**而遇到不能重生的產物 —— 像生成的圖 —— 就把產生它的那句話收進
.md,那句話才是真相。
順帶一提,這篇本身就是這條規則的產物 —— 它是一份 md,等一下會變成 iThome 上的一篇文章。如果哪天要變成別的格式,重生一次就好。
md_to_single_html.py(225 行,純標準庫,無第三方相依):gist.github.com/n913239/7ae7d88c… 要重現本文這一版,用釘住 revision 的網址(內容永遠不變):raw/7a8942d6…/md_to_single_html.py
docx skill 那次的 prompt、md2docx.js、cost 與兩版渲染頁:原始檔未另外公開,數字如正文(Claude Code 2.1.271,Opus 5,2026-09-16)@marp-team/marp-cli,本文用 npx --yes 現抓):github.com/marp-team/marp-cli


 iThome鐵人賽
 看影片追技術