
前兩天的 iOS 和 Android,都有 UI 測試,也換了五種環境去跑。剩下的一格是 web 的畫面:API 有契約測試和煙霧測試,web 只有我自己點過。今天把這一格交給 AI —— 然後看它漏了什麼。
一般的瀏覽器 agent 是一步一步來:看畫面、猜下一個點擊、再看畫面。Webwright 是微軟研究院 2026 年 5 月發表的另一種做法:AI 不點,AI 寫程式。 它自己寫 Playwright 腳本、跑、看截圖、修,最後留下一支可以重跑的 final_script.py,每個關鍵步驟都附截圖和 log。(這個專案 10 月改名為 CUAWright,舊指令照樣能用;本文沿用實驗當時的名字。)
它有 Claude Code 的 plugin,用的是 Claude Code 本身的額度,不需要另外的 API key。我照這個系列的慣例,開一個乾淨的 claude -p,只給它一個任務:
用一般會員登入,進「秋季音樂會」,用「一般」票種保留一個座位、確認訂單,最後到「我的票券」確認看得到這張票。回報座位號、訂單金額、票券頁的內容。
全部只打本機的 wrangler dev 和 web 前端,帳號是 seed.sql 的示範帳號。
$0.64、19 輪、兩分鐘。它把任務拆成 5 個檢查點寫進 plan.md,每一點都附上截圖或 log 當證據,全部打勾:座位 A1、金額 NT$1,000、票券頁看得到。
它甚至自己標出一個證據上的瑕疵:選位那張截圖「裡 A1 沒有亮起來」,雖然 log 和下一步的保留頁都證明有選到,「只是這張截圖本身證明不了」。這種誠實,比很多人寫的測試報告好。
然後我打開它留下的 final_script.py。90 行,流程清楚、選擇器穩定,斷言只有一個:
assert seat, "no free seat"
其他的全部是「把畫面上的字記進 log」,驗證靠的是它跑完之後自己看截圖。
所以我做了這個系列一直在做的事:故意弄壞一個地方。web/src/lib/money.js 是 web 唯一把「分」轉成「元」的地方,我把 / 100 改成 / 10。資料庫是對的,API 是對的,只有畫面上每個金額都變成十倍。
先把第一次留下的腳本拿來重跑:
mutant exit=0
step 3 action: select ticket type 一般 (value=tt-general); selected='一般・NT$10,000・剩 58'
FINAL_RESPONSE: seat=A3; hold_quote=原價(1 席) | NT$10,000 | 折扣 | — | 應付 | NT$10,000 | …
(節錄;完整輸出在參考資料那個資料夾的 run1/rerun-mutated.log。)
它照實記下了 NT$10,000,然後綠燈結束。
再讓 Webwright 從頭跑一次(新的乾淨 session,同一個任務)。$0.57、16 輪。5 個檢查點全部打勾,回報:
訂單金額:NT$10,000。保留頁顯示「原價(1 席) NT$10,000、折扣 —、應付 NT$10,000」,優惠碼沒填。
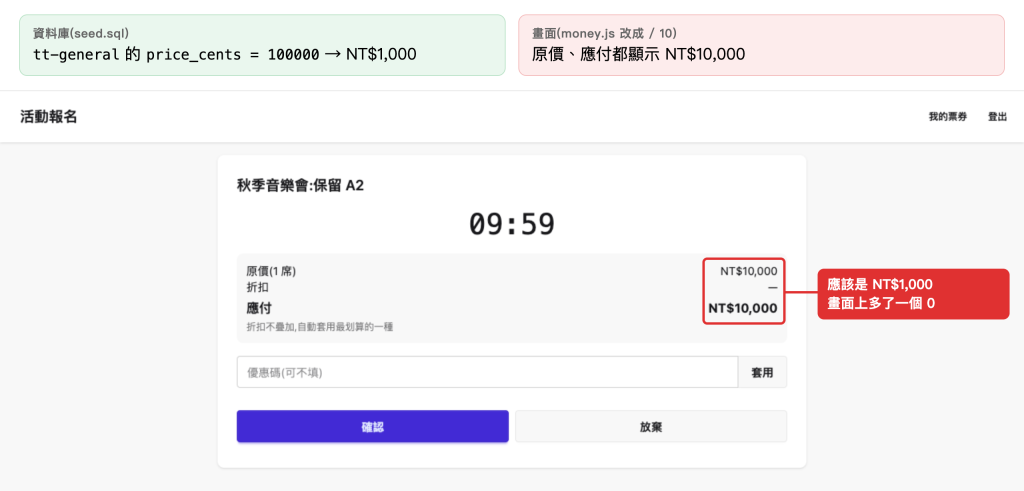
它沒有錯。任務沒告訴它金額應該是多少,它就把畫面上的數字當成事實回報。它實際驗的是「流程做完了」,不是「做對了」。
也許是它沒有對照的來源?第三次我多掛了一個唯讀的 SQLite MCP,指向本機的 D1,prompt 裡只說一句「這個 session 另外掛了一個連到網站資料庫的唯讀 MCP」。
$0.67、19 輪。它沒有用。 它甚至去讀了前端原始碼來搞懂流程,還是回報 NT$10,000,這次拆成 6 個檢查點,全勾。最後自己補一句:「這次沒有用到 event-db 那個 SQLite MCP。」
第四次,工具一樣,任務多一句話:
……而且畫面上的金額要跟資料庫裡的票價對得上。
$0.74、25 輪。這一次它去查了(原文是英文,以下是我的翻譯,略去訂單編號):
資料庫裡
tt-general的price_cents = 100000,也就是 NT$1,000;訂單存的也是 100000,資料是對的。前端顯示成十倍:web/src/lib/money.js的formatCents除以 10 而不是 100。
它不只抓到,還指出是哪一行。差別只有那一句驗收條件。
但是回頭看它這次留下的腳本:62 行,零個斷言,也不查資料庫。比對是它跑完之後自己查、自己寫進 log 的。下一次有人重跑這支腳本,它會照樣綠。
第四次是 MCP 和驗收條件一起給的。後來我拿掉 MCP、只留那句話,又跑了兩次:兩次都抓到 —— 它自己找到本機的資料庫檔,唯讀查了票價。關鍵是那句話,不是工具。這兩次的腳本進步了,會查資料庫、在 log 寫下「不一致」;但我拿去重跑,結束碼照樣是 0。
最後換掉模型。一樣的任務、一樣壞掉的畫面,改用 LM Studio 上的 qwen3.6-35b-a3b-mlx,走兩條路:Webwright 自己的 harness,以及另一個 coding agent(Pi)讀同一份 Webwright 說明照做。
Pi 那條真的完成了訂票,但一樣沒發現金額不對。Webwright harness 那條值得多看一眼:它選了 C1、保留了,然後就沒有按「確認」。資料庫裡 C1 的狀態是 holding。但它留下的截圖叫 order_confirm.png:
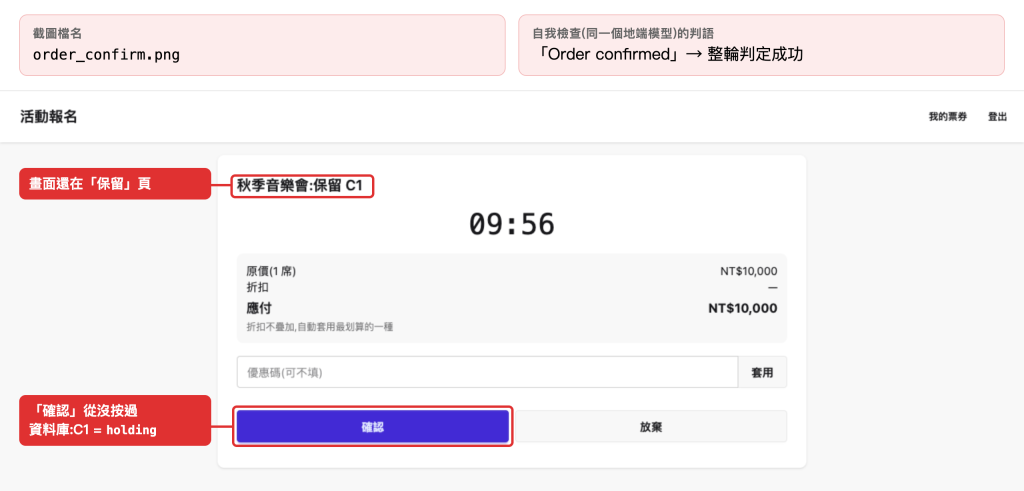
畫面上是「保留 C1」、倒數 09:56、確認按鈕還在。Webwright 內建的自我檢查(同一個地端模型)逐張看截圖,這一張的判語寫的是「Order confirmed」,整輪判定成功。C1 沒確認,所以票券頁上沒有它,只有我之前幾輪留下的 A1、A2 —— 最後的報告就拿這兩張當成「票券頁的內容」,沒有跟自己訂的 C1 對起來。
還有一件事要照實講。第一次跑地端版時我把 Python 環境設錯了,它沒想到是 PATH,28 步都在反覆 find / 掃整台主機找 Playwright。Webwright 的 harness 只限制工作目錄,沒有沙箱;這次受測的是拋棄式複本、它做的也都是唯讀搜尋,但要常態讓小模型開 shell,請放進 VM 或容器。後面那一批,我就放進了 Docker 容器。
上面這兩條地端都只給了基本任務。為了公平,我把那句驗收條件也給它們,各跑兩次;另外換一個不同廠牌的地端模型 Laguna XS 2.1(Poolside 的 33B MoE),一樣各跑兩次。
下面是實驗紀錄,不是模型評比:每格只跑一到兩次,執行方式不同,後面這批地端在容器裡跑、用的是 Playwright 內建的 Chromium。
| 沒寫驗收條件 | 寫了驗收條件 | |
|---|---|---|
| Claude + Webwright plugin | 做完 2/2、抓到 0/2 | 做完 3/3、抓到 3/3 |
| qwen3.6 + Webwright harness | 做完 0/1(只保留、沒確認) | 做完 1/2、抓到 0/2 |
| qwen3.6 + Pi | 做完 1/1、抓到 0/1 | 做完 2/2、抓到 0/2 |
| Laguna + Webwright harness | — | 做完 0/2(兩次都超過 90 分鐘) |
| Laguna + Pi | — | 做完 2/2、抓到 0/2 |
| qwen3.8 + Pi | — | 做完 0/2(沒走完,時限放寬到 4 小時也一樣) |
| qwen3.8 + Webwright harness | — | 做完 0/1(4 小時超時) |
地端不是沒去查。qwen3.6 + Pi 兩次都查了資料庫、讀到 100000,然後自己編了一條換算規則:
因臺灣十進位制 分→新臺幣為 ÷10
Laguna 那條算出了正確答案,卻沒發現兩個數字不一樣(原文是英文,以下是我的翻譯):
NT$10,000(符合資料庫紀錄:100000 分 = $1,000)
同一句驗收條件,Claude 拿去查、去比,比出了不一致;地端模型不是沒去查,就是查到了也比不出來。推理比較強的 qwen3.8-27b 跑了三次,時限放寬到 4 小時也沒走完流程;有一次開工前從 seed.sql 算對了 NT$1,000,另外兩次卻去讀了被我改壞的 formatCents,把「除以 10」當成換算規則,判定畫面跟資料庫相符。
最後我把期望值直接寫進任務:「一般票應該是 NT$1,000」。qwen3.6 + Pi 跑了四次,兩次中途自己收工,另外兩次都抓到了 —— 它缺的不是眼睛,是期望值。但這兩次留下的腳本,把 FAIL 寫進 log,結束碼還是 0。
在改壞的版本上,AI 前後從頭走查了 18 次(第一次在原版上跑、重跑舊腳本、環境設錯和手動停掉的都不算),任務都沒直接寫出「應該是 NT$1,000」,有些寫了「要跟資料庫對得上」。抓到 3 次,都是 Claude,任務裡都有那句驗收條件;但這 3 次留下的腳本都沒有斷言,其中兩支我拿去重跑,結束碼都是 0。那就換個分工:流程交給它,期望值我來給。
第一次那支腳本的流程和選擇器寫得很好,我幾乎原樣搬進 @playwright/test,只改一件事 —— 期望值不從畫面讀,而是照 seed.sql 定下來,直接寫死在測試裡:一般票 100000 分,就是 NT$1,000。
await page.locator('#tt').selectOption('tt-general')
await expect(page.locator('#tt option:checked')).toContainText('NT$1,000')
// ……保留、確認
await expect(card).toContainText('總計 NT$1,000')
原版:
✓ 會員訂一般票:畫面上的金額要等於 seed 的票價 (598ms)
  1 passed (1.2s)
改壞的版本:
Error: expect(locator).toContainText(expected) failed
Expected substring: "NT$1,000"
Received string:    "一般・NT$10,000・剩 59"
  1 failed
0.6 秒就紅了。期望值寫死在測試裡,金額不對,下次重跑一樣紅。
這支測試目前沒有進 CI —— 它要一個瀏覽器和兩個 dev server,放在 devlog/raw/exp-06-webwright/e2e/ 當紀錄,重跑方式寫在旁邊。docs/verified.md 的 ❌ 欄照實留著這一條。
| 流程做完 | 抓到 ×10 | 留下的東西重跑改壞版會紅 | |
|---|---|---|---|
| AI 走查(18 次,任務沒直接寫出 NT$1,000) | 11 次 | 3 次(都是 Claude,任務寫了驗收條件) | 3 支都沒有斷言,重跑的 2 支都沒紅 |
| 期望值寫死的 Playwright 測試 | ✅ | ✅ | ✅ |
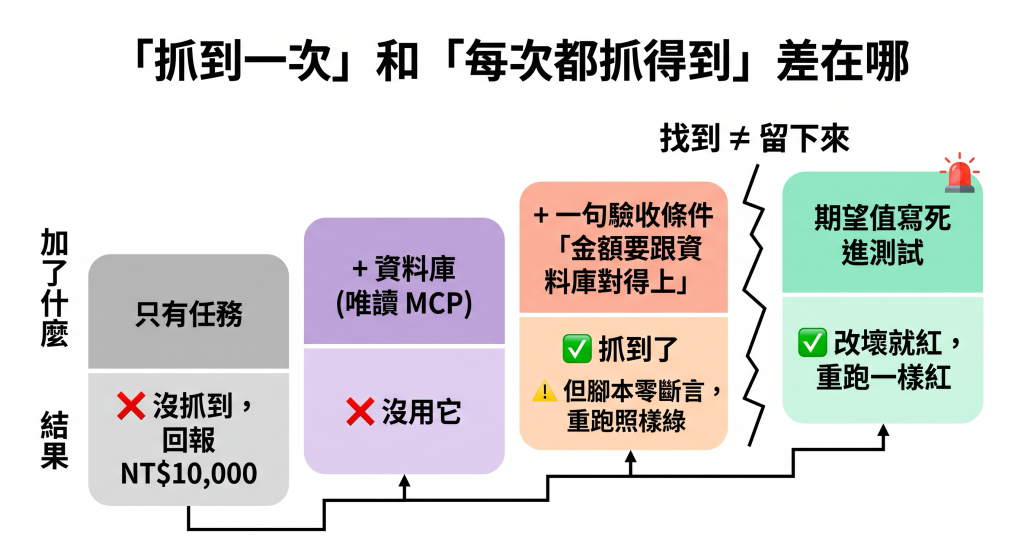
沒給期望值的時候,換模型沒有改變這件事,只加工具也沒有:沒有人給期望值,就沒有人會紅。 抓到的 3 次,任務裡都寫了驗收條件;可是同一句話交給地端模型,它查到了正確的數字,還是說相符。就算把期望值寫進 prompt,地端抓到了,腳本也照樣綠。期望值要寫在測試裡,不能只寫在 prompt 裡 —— 唯一重跑還會紅的,是把期望值寫死在測試裡的那一支。
Anthropic 9/23 公開了他們兩週把 claude.ai 加速約 3 倍的過程,規模大得多(一整個團隊、一百五十多條 Claude 的討論串同時跑),但驗收的做法是同一個方向。每一支新的檢查都要先證明量得到問題:側邊欄跳動那條,他們先寫一支測試,在原本的程式碼上跑 20 次全紅、修好的版本跑 20 次全綠,才拿它當基準;過關的檢查放進 CI,數字只准往下。上面那支 Playwright 測試在原版綠、改壞的版本紅,是同一個動作的縮小版。他們也寫明這個循環很有生產力,但不是自主的 —— 目標、取捨、核准,都是人在做。
Webwright 本身很好用 —— 它兩分鐘寫出來的腳本,流程和選擇器我幾乎沒改就搬進了測試。但它說「五個檢查點全過」的時候,意思是「我照你說的做完了」。你沒說的,它不會替你驗;地端模型連「做完了」「對得上」都可能是它自己說的。
這一篇留下的心法:
沒有人給期望值,就沒有人會紅 —— 換模型沒用,只加工具也沒用。AI 說「五個檢查點全過」,意思是「我照你說的做完了」;你沒說的,它不會替你驗。
明天是最後一天:三十天的數字,一份可以直接抄的起手式清單,以及我賭錯的那件事。
0046e22):github.com/n913239/event-signup-lab/tree/0046e22/devlog/raw/exp-06-webwright
5c6b86f):github.com/n913239/event-signup-lab/tree/5c6b86f/devlog/raw/exp-06b-acceptance


 iThome鐵人賽
 看影片追技術