
Day 1 我說,如果只帶走一句話,我希望是這句:
一份你沒驗過就採信的 code,比沒有那份 code 更危險。
三十天過去,這句話我沒有改,但我對它的理解變了。
後十天,我在 event-signup-lab 把一個活動報名系統從規格做到後端,以及 web、iOS、Android 三個前端。它不上架,所以沒有「多少人用了它」這種成績單;我最想讓人記住的是兩個數字:AI 在七條題目上踩穿 0 條;我自己的檢查壞了 19 次。(「踩穿」指違反了定好的規則、而且沒有任何檢查擋下。)
| 規則 | AI 第一版(只拿到需求的乾淨 session) | 裁判 |
|---|---|---|
| 金額精度(25) | ✅ 整數、沒有浮點;/ 100 的寫法被靜態檢查擋下;單位選了元(prompt 沒給,是規格空白) |
零浮點靜態檢查 + 測試向量 |
| 折扣順序(25) | ✅ 空白時選了疊加;我改成擇優後,約兩成的隨機輸入算出不同金額 —— 定義換了,不是它錯 | 測試向量 + fuzz |
| 價格快照(22、25) | ✅ schema 自己設計了下單當下的單價欄位 | schema 斷言 + 改價測試 |
| 超賣、座位唯一(26) | 🟡 batch + CHECK、唯一索引都對;只差一條錯誤優先順序:它交卷時那條還沒寫成測試,我補上之後它才紅 |
閘門重跑 5 次 + 真實多連線 |
| 保留 TTL 三方競態(26) | ✅ 到期那一刻,原持有人送出確認、別人搶位、清掃排程同時發生;它把釋放和搶位放在同一個 batch 裡,原持有人一律輸 | 閘門讓三件事同時放行,重跑 5 次(單一 process;真實多連線沒跑) |
| JWT 邊界(24) | 🟡 六個測試過四個,紅的兩個是時鐘從哪來 | 六個測試 + 簽章比對 |
七條題目沒有一條踩穿,紅的幾次也都不是它的判斷錯 —— 併發那次是那條優先順序我沒給它,JWT 那兩次是時鐘從哪來;反覆出事的是硬規則「時間是參數」—— 三份 AI 版在 SQL、JWT、參數預設值裡各藏了一個時鐘,都能跑,但「剛好等於邊界」的那一刻測不到。另一個失準的是工期:我排 9/21 全通、spec-kit 排 10/2,實際是 9/27 —— 9/17 到 9/26 一個 commit 都沒有,9/27 一天 119 個,兩份排程都假設寫程式的是人。Cloudflare 的用量都在免費額度內:流量全是我自己打的,用量比例最高的一項也只到 1.71%。草稿裡原本還寫「N+1 會讓 rows read 翻十倍」,實跑之後 N+1 反而少讀(N+1 讀 52 列、JOIN 讀 60 列),貴的是查詢次數(N+1 查 27 次、JOIN 只要 1 次)—— 結論還是寫成一次 JOIN,但理由換了。
我賭錯的那件事也在這裡。我原本把這七條當成「AI 的失誤區」:埋好陷阱,等它踩。開賽前的前置實驗四個陷阱它四個都沒踩(devlog/prior-experiments/),這一輪也一樣 —— 缺陷大多不在實作,在規格的空白處:單位、優先順序、時鐘從哪來,沒說的它會替你決定。而最不可靠的是我自己的檢查:19 次裡,有抓不到的(工具不存在而全綠)、抓太多的(CI 逾時設太短),也有我自己的腳本和 UI 測試印出假綠燈。我拿一套沒驗過的檢查去驗 AI —— 而這正是我整個系列在批評的事。
如果你要開一個新專案、而且打算讓 AI 寫大部分的 code,這是我三十天之後會照做的順序。
動手之前
開始寫之前
wrangler login 跳出授權頁,一次要 28 項權限 —— DNS、Billing、Cache、AI、Queues 全包。老實說,那一整頁權限名稱我大半看不懂,一路按 Authorize 是最省事的。我做的是把授權頁截圖丟給 Claude,只問一句「幫我看一下,只開最小權限就好」。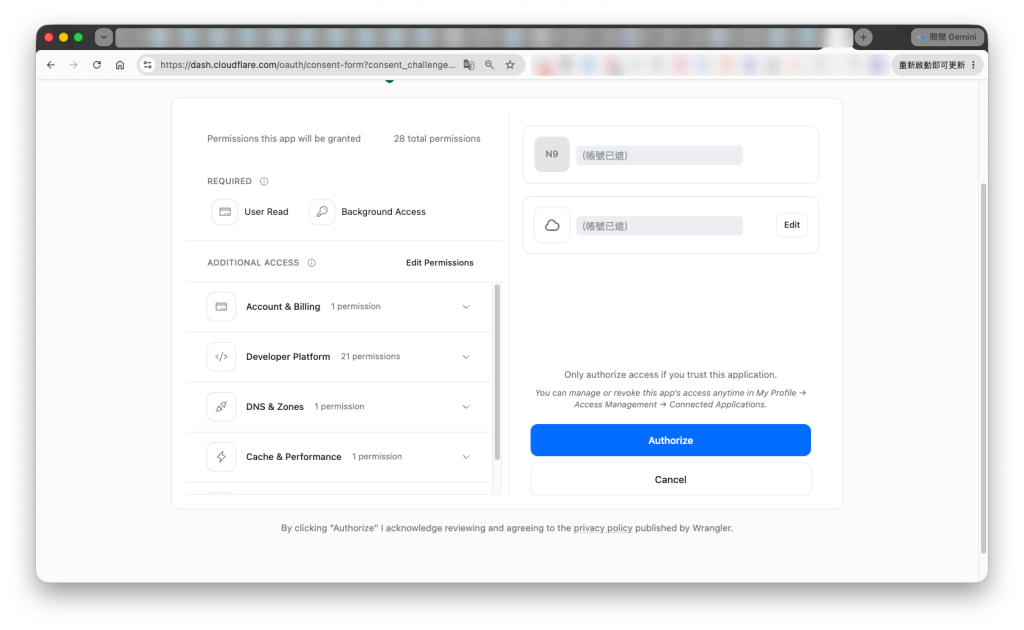
它叫我先按 Cancel,給了一行帶 --scopes 的登入指令,並逐項說明每個權限拿來做什麼。但它第一版的指令是錯的:多放了一個 offline_access,wrangler 直接回 Invalid authentication scope。我把錯誤畫面再截給它,它才改口:那一項是授權頁上必要的「Background Access」,wrangler 會自己加,不能手動指定。第二次,授權頁剩 6 項,每一項都答得出為什麼需要。
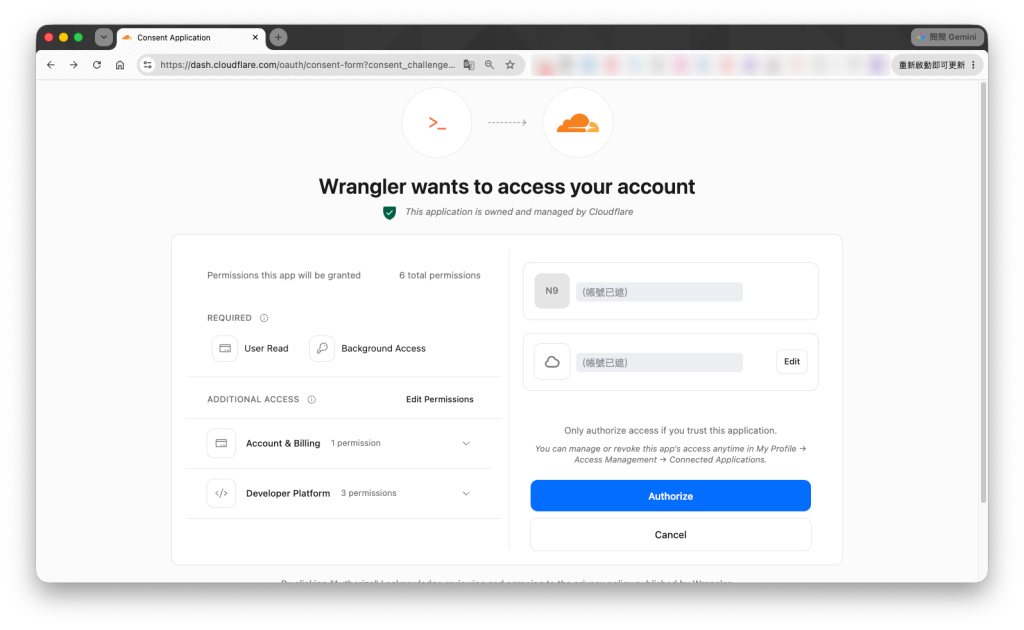
這件事我覺得比任何一條規則都值得抄:預設值不是你的決定。 最小權限原則聽起來像資安團隊的口號,落到個人開發者身上其實是一個很具體的動作 —— 每一項權限都要答得出「為什麼需要」,答不出來就不開,之後真的用到再補。看不懂不是理由,AI 很擅長把一頁權限清單翻成人話;但它也會錯,所以最後把關的是平台的錯誤訊息和你自己的確認,不是它的第一個答案。權限的人工關卡在 Xcode 那邊也有:用 Xcode 的 MCP 時,每開一個新的 mcpbridge process,Xcode 就跳一次「允許存取」,要你自己按。
寫的時候
FOR UPDATE 的資料庫上,讓唯一索引和 CHECK 拋錯,整批回滾。驗收的時候
前 20 天備工具,後 10 天拿來用。照用途整理:
| 用途 | 工具 | 篇 |
|---|---|---|
| 寫程式、跑實驗 | Claude Code(日常的互動 session;實驗用 claude -p 開乾淨 session) |
全系列 |
| 讀陌生的 repo | graphify(把 repo 畫成知識圖) | 2–4 |
| 把規格問完整 | Plan Mode、/grill-me、OpenSpec、spec-kit |
7、8、20、21–26 |
| 把規則留下來 | CLAUDE.md、slash command 與 skill、hook | 6、11–12、17 |
| 接外部工具 | MCP(SQLite、Xcode) | 14–15、27、29 |
| 隔離 | 空目錄、換目錄、VM、Docker 容器 | 4、16、28–29 |
| 地端模型 | LM Studio + Pi | 19、29 |
| 後端 | Cloudflare Workers + Hono + D1、wrangler | 21–30 |
| 契約與前端 | OpenAPI 3.1;web(Vite)、iOS(SwiftUI + swift-openapi-generator)、Android(Jetpack Compose + OpenAPI Generator) | 23、27、28 |
| 測試 | Vitest、XCUITest、Compose UI 測試、Playwright | 9、22–29 |
| 驗收與稽核 | 自己寫的靜態檢查(check-*.sh + self-test.sh)、Stryker 突變測試、iOS 與 Android 的無障礙稽核、Webwright 走查 |
19、22–29 |
| 最後一道門 | GitHub Actions | 27 |
工具換得掉,換不掉的是起手式清單裡的順序:先定規則、再讓 AI 寫、最後用會紅的東西驗。
照 docs/verified.md 的 ❌ 欄,加上實作和寫文章時發現的:
ios/。 Day 28 的參考實驗,AI 照抄的就是沒修的那一版。開工前我把前 19 天備的工具分成天天用、偶爾、不帶三堆,猜錯的有兩個方向:排進「天天用」的 Claude Code permissions 設定、hook、/commit 都沒用上 —— 真正擋錯的是寫進 repo 的測試和靜態檢查;排在「偶爾」的隔離環境,卻是整個後半的地基。
這次參加鐵人賽,規劃階段只想了簡單的主題和方向:前 20 天寫 Claude 的應用與心法,後 10 天安排一個全端的實作。規劃時,AI 的創造力很強,主題常常無限發散;它也常在文章裡自創一些奇怪的詞和口訣。所以後來統整時,前前後後改了不下五次主題。寫系列文跟做專案不一樣 —— 專案的需求通常有方向、有明確的目標,系列文的方向得自己先定下來。這是這次學到很寶貴的一課。
AI 的優點也很明顯。只要定好方向、想到可以做實驗的點,它的動手能力很強,能很快做完一個又一個 lab;有想測的方向,也能很快跑完,而且動手之前,就能先估出要花多少成本(token、時間)。以前要手工做的部分,真的省下了大量時間。
另外,AI 整理文件的能力很好,但你得先有自己的想法和規劃,不然它會選一個比較通用的寫法,結果就可能跟你當初設想的不一樣。先規劃、再實作,通常是比較好的做法。
審稿也可以交給 AI。現在很流行讓不同的角色、甚至不同的 agent 交叉審稿 —— 例如 Claude 開兩個角色,一個寫、一個挑;或是 Claude 寫、Codex 審。不同的角色、不同的模型看的角度不一樣,交叉看比較容易抓到漏掉的地方;但不管是誰審,建議都要逐條判斷,跟實際跑過的結果衝突時,以跑過的為準,才不會被幻覺帶著走。
最後一點:AI 寫文章很快,內容又多又完整,所以取捨反而變得重要 —— 適當地刪,也是很好的做法。
三十天前那句話,現在我會加一個後半句:
一份你沒驗過就採信的 code,比沒有那份 code 更危險。
而一套你沒驗過就拿去驗別人的檢查,比沒有那套檢查更危險。
因為前者你至少還會提防,後者會讓你安心。
AI 可以讓你很快做出一個作品,也可能讓你對一件事開始感興趣。但軟體工程裡還有很多東西得靠自己補,資安是最明顯的一塊。上面「沒有做到的事」裡的「登入以外沒有限速」「email 可以被列舉」「token 存在 localStorage」,要看得出它們為什麼是取捨、什麼時候不能再取捨,靠的是自己的底子。
作品可以跟 AI 一起做完,學習不行。該補的基礎知識和技能,最後還是得自己一樣一樣補上。
謝謝一路看到第 30 天的你。這個系列的程式碼、測試和每一次實驗的原始紀錄都在 event-signup-lab,大部分的測試和實驗照著 README 都能重跑;起手式那份清單,也歡迎直接拿去用 —— 用的時候記得,連這份清單也先驗過再信。
這三十天,AI 在七條題目上一條都沒踩穿;我自己的檢查壞了 19 次。盡信 Claude,不如無 Code —— 而盡信自己的檢查,也一樣。
n-plus-1.mjs 可重跑):github.com/n913239/event-signup-lab/tree/a4b5c98/devlog/raw/day28-free-tier


 iThome鐵人賽
 看影片追技術