
上一篇介紹了 Weekly AI Tools Scout,讓 AI 每週幫我找跟目前專案有關的資訊。不過看完報告後,我還是會自己挑哪些要留下來。
有些是現在用得到的,有些還不確定,但感覺之後可能有用,我也會先存進知識庫。對我來說,存下來不代表決定採用,只是希望之後想研究時,不用重新找一次。
而我平常主要透過 MCP 存入,不一定會打開知識庫網頁操作。
以前比較在意的是有沒有存好,這次就想順著自己平常的使用方式,了解請 AI 幫忙保存資料之後,背後到底做了什麼。
MCP 的全名是 Model Context Protocol。在這個專案裡,我先把它理解成讓 AI 用戶端呼叫知識庫工具的溝通方式。
知識庫的 mcp_server.py 裡定義了幾個工具,例如:
| 工具 | 用途 |
|---|---|
add_item |
把資料交給知識庫處理與保存 |
get_item |
依照資料編號讀取內容 |
search_knowledge |
搜尋可能相關的資料 |
count_items |
查詢資料筆數 |
我請 AI 保存資料時,需要由 AI 呼叫對應的工具,再由工具背後的程式處理。
MCP 本身沒有替我保存文章,真正寫入資料庫的是知識庫裡的 Python 程式。
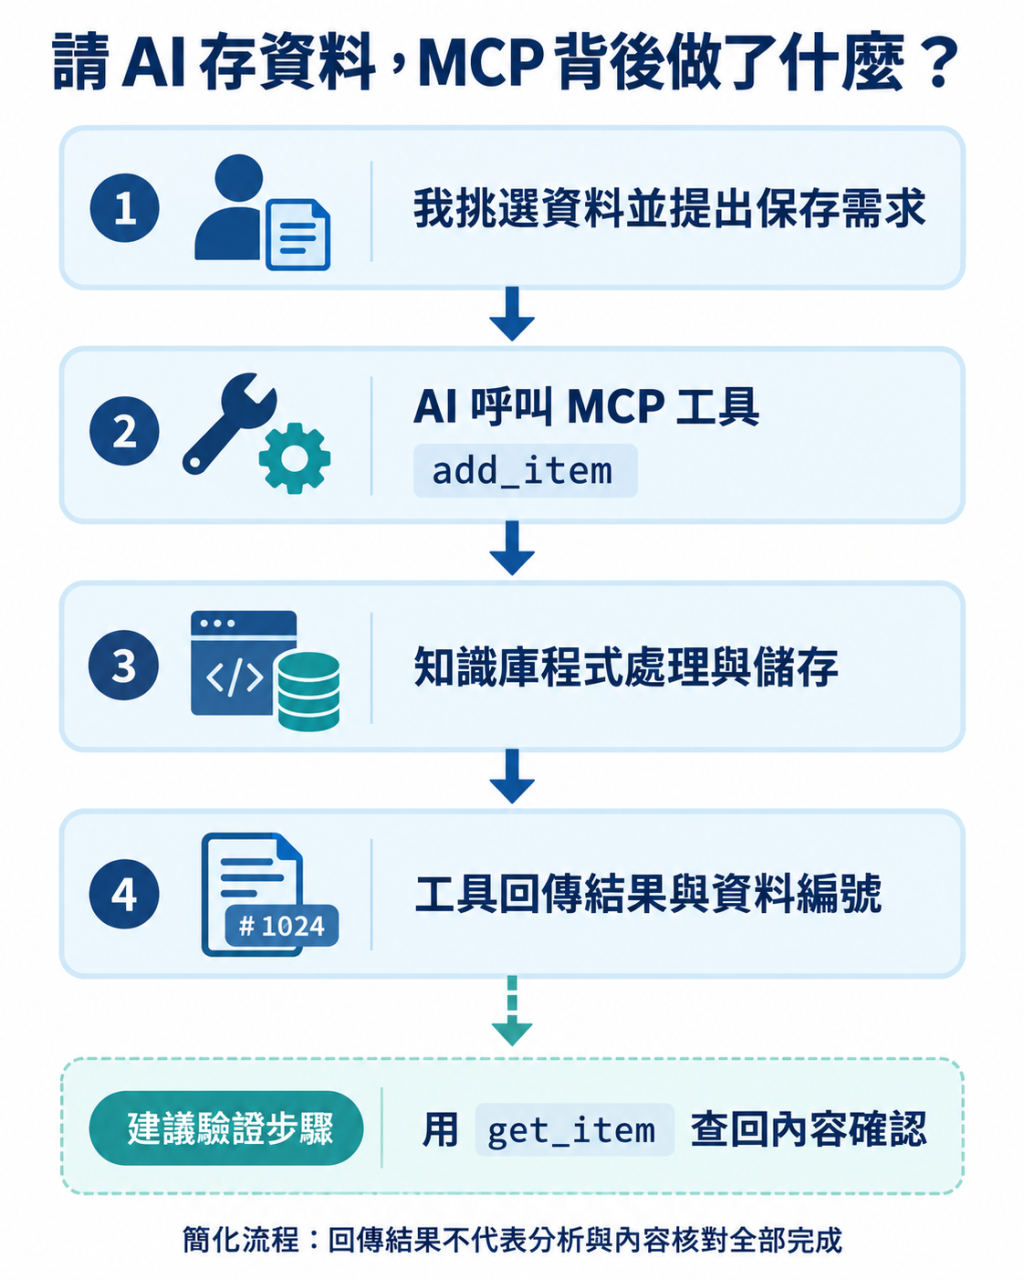
從提出保存需求,到工具處理與查回確認的簡化流程。
這裡也要跟上一篇的 Scout 分清楚。Scout 負責搜尋並產出報告;我看完之後挑選資料,再透過 MCP 保存,是另一個動作。
專案裡另外有讀取週報、透過命令列程式匯入的同步腳本,但它沒有走 MCP,也不能把它跟我的日常操作混成同一條流程。
add_item 主要接收三個參數:
| 參數 | 用途 |
|---|---|
content |
交給工具處理的內容 |
type |
指定是網址或文字,預設為文字 |
title |
可以自行提供的標題 |
例如想保存一個工具網址,呼叫時的參數可能是:
{
  "type": "url",
  "title": "我想研究的工具",
  "content": "https://example.com/tool"
}
這是依照專案工具參數整理的示意,不是本次實際呼叫的紀錄。
JSON 可以先理解成交換資料的文字格式。這份內容是在告訴工具:這次送進來的是網址,標題是「我想研究的工具」,請依照網址的方式處理。
如果我已經整理好一段筆記,要存入的是文字,參數就會像這樣:
{
  "type": "text",
  "title": "我的工具筆記",
  "content": "這個工具可能適合用來整理文件,之後想再確認它支援的格式。"
}
同樣都叫 content,但第一個放的是網址,第二個放的是筆記文字。工具會根據 type 決定怎麼處理。
這次看程式時,有個細節值得注意。
目前 MCP 的 add_item 預設類型是 text。指定 type="url" 時,才會進入讀取網址、擷取正文的路徑;沒有指定時,就把輸入當文字交給儲存流程。
| 傳入方式 | 工具的處理方式 |
|---|---|
type="url",內容是網址 |
嘗試讀取正文,再交給儲存流程 |
type="text",內容是筆記 |
把筆記當文字交給儲存流程 |
沒指定 type,只傳網址 |
預設當文字處理,這一步不會自動擷取正文 |
所以,不能只看到資料裡有網址,就認為系統已經讀過那篇文章。
這也讓我理解,AI 呼叫工具時,除了有沒有呼叫成功,傳入的參數也會影響結果。
至於網址如何變成正文、擷取時可能漏掉什麼,我會留到下一篇,再介紹專案使用的 Trafilatura。
MCP 工具後面會呼叫 store.save_item(),由這套程式處理保存與分析。
其他入口,例如網頁與命令列程式,也會使用這套儲存邏輯。這樣就不需要每個入口都另外寫一份存入方法。
不過「存入」也不只是固定新增一筆。程式還有重複資料檢查和長內容拆分,所以結果可能是新增資料、回傳既有資料,或拆成多筆。這些機制後面再分別研究。
另外,目前 MCP 入口預設會在同一次工具呼叫中嘗試完成分析,再回傳結果。如果分析失敗,資料仍可能已經保存,只是缺少摘要或其他整理結果。
因此,收到工具回傳的資料,也還需要看裡面實際有哪些內容。
我平常會打開內容確認,也會回原始連結核對。這次了解工具的分工後,接下來想多做一個更明確的確認流程:
add_item 回傳的資料編號。get_item 查回資料。例如工具回傳某筆資料編號後,就可以用這個編號查詢:
{
  "item_id": 42
}
42是示意編號,實際操作要使用工具真正回傳的編號。
查回資料,也不代表每個處理步驟都成功。如果只有來源網址,正文卻是無法取得內容的說明,就只能確認連結留下來了,還不能說文章已完整保存。
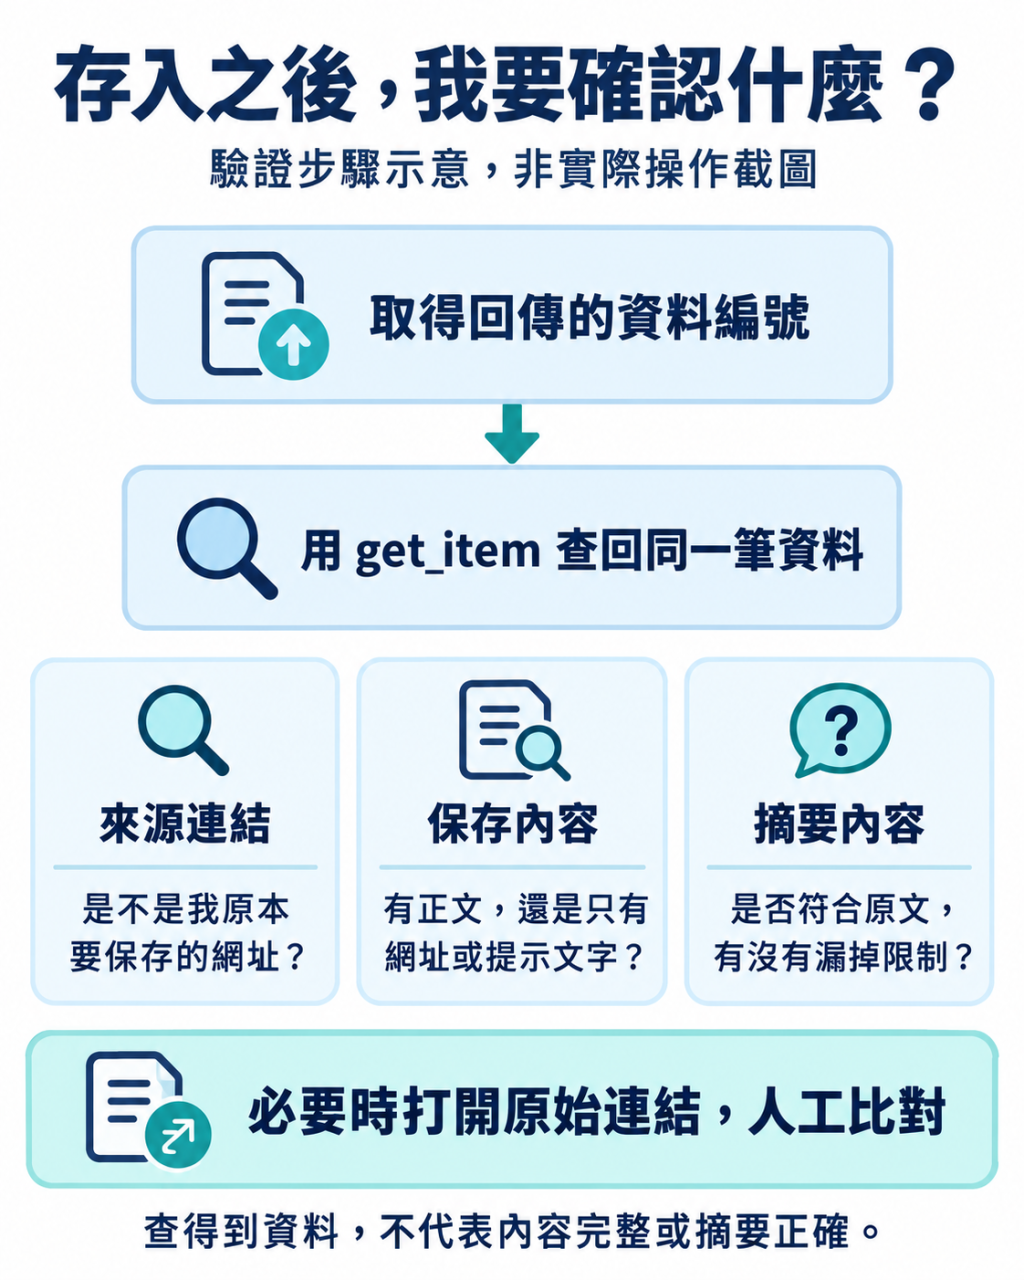
這次主要是依照程式了解流程,還沒有執行新的 MCP 存入與查回測試,因此上面是接下來的驗證方式,不能寫成已完成的測試結果。
整理這篇之前,我比較習慣從操作結果看知識庫:資料有出現,就打開來讀。
這次開始把中間的流程拆開,知道 AI 需要呼叫工具,工具會根據參數處理,再交給儲存程式保存與分析。
之後確認是否存好時,就可以多看工具實際回傳了什麼,而不只看對話裡的一句「已存入」。
對我來說,這是慢慢理解自己做出來的系統的一步。先知道一筆資料怎麼進去,下一篇再接著看:網址讀取之後,取得的內容是不是完整的?


 iThome鐵人賽
 看影片追技術