
Sorted Set 就是 Set 再加一個分數,Redis 會按照分數自己排好。
ZADD key score member ...(加進去,回傳新增幾個;member 已經在裡面就只改分數)
ZINCRBY key increment member(加分,回傳加完之後的分數)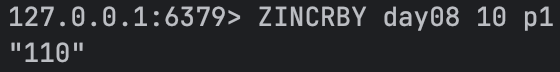
ZSCORE key member(查某個 member 幾分)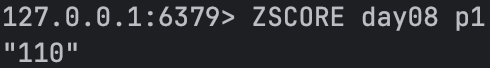
ZCARD key(有幾個)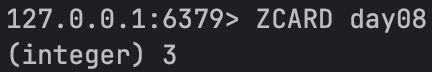
ZRANK key member(排第幾,從 0 開始算,分數小的在前面)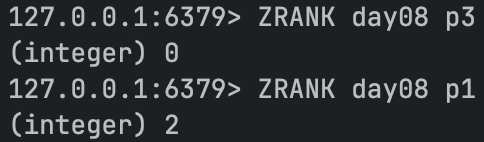
ZRANGE key start stop(照分數由小到大取一段,0 -1 是全部)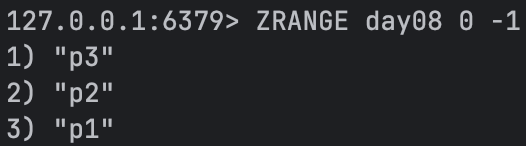
ZRANGE key start stop REV WITHSCORES(加 REV 變由大到小,加 WITHSCORES 把分數也帶出來)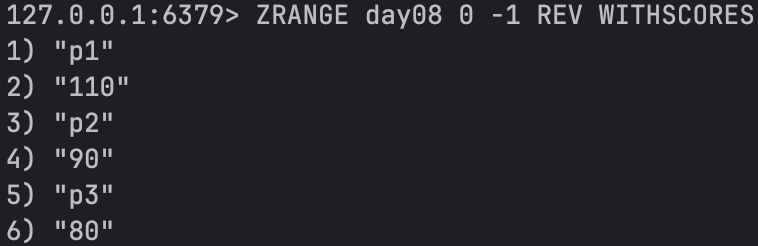
ZRANGE key min max BYSCORE(改成照分數範圍撈)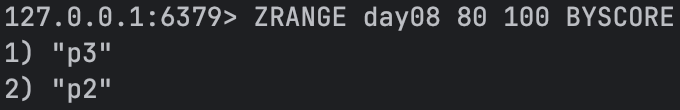
ZREM key member ...(刪掉,回傳刪掉幾個)
ZREVRANGE、ZRANGEBYSCORE 也還能用,但 Redis 6.2 之後官方建議統一寫成 ZRANGE 加參數。
每賣出一件就加一分,要前 10 名就直接取:
ZINCRBY rank:sales 1 p1
ZRANGE rank:sales 0 9 REV WITHSCORES
排序是 Redis 自己維護的,不是查的時候才排。不用每次 ORDER BY 掃一次表,也不用另外開排程重算。
Java 是用 ZSetOperations:
private final ZSetOperations<String, String> zset;

public RankController(StringRedisTemplate redis) {
    this.zset = redis.opsForZSet();
}

/** 賣出幾件就加幾分,不用先查再寫 */
@PostMapping("/sold")
public Map<String, Object> sold(@RequestParam String productId, @RequestParam double qty) {
    return Map.of("productId", productId, "sales", zset.incrementScore("rank:sales", productId, qty));
}

/** 前 N 名:排序是 Redis 自己維護的,直接取就好 */
@GetMapping("/top")
public List<Map<String, Object>> top(@RequestParam(defaultValue = "10") long n) {
    Set<TypedTuple<String>> rows = zset.reverseRangeWithScores("rank:sales", 0, n - 1); // 取第 0 ~ n-1 名
    List<Map<String, Object>> top = new ArrayList<>();
    for (TypedTuple<String> row : rows) {
        top.add(Map.of("rank", top.size() + 1, "productId", row.getValue(), "sales", row.getScore()));
    }
    return top;
}
賣出四筆,再看前三名:
curl -X POST "http://localhost:8080/rank/sold?productId=p1&qty=3"
curl -X POST "http://localhost:8080/rank/sold?productId=p2&qty=7"
curl -X POST "http://localhost:8080/rank/sold?productId=p3&qty=5"
curl -X POST "http://localhost:8080/rank/sold?productId=p1&qty=2"

curl "http://localhost:8080/rank/top?n=3"

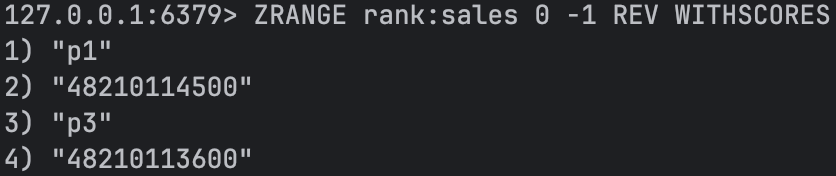
上面那個結果有個問題:p1 和 p3 都賣 5 件,p3 排在 p1 前面純粹因為字母排比較後面。分數一樣的時候 Redis 是按 member 的字典序排。
想要「同樣賣 5 件,先賣到的排前面」,就把兩個值壓成一個分數:
分數 = 銷量 × 10^10 - 那一件賣掉的時間戳
10^10 就是 100 億。每多賣一件,分數就多 100 億;而時間戳現在大概 17 億,最多也就 10 位數,扣掉的永遠不到 100 億。所以銷量差一件,時間再早也追不回來,時間戳只有在銷量一樣的時候才會起作用,時間早的扣得少、分數高,就排前面。
ZREM rank:sales p2               # 這段只看 p1、p3,先把 p2 拿掉
ZADD rank:sales 48210114500 p1   # 5 件,14:05 賣到第 5 件
ZADD rank:sales 48210113600 p3   # 5 件,14:20 才賣到
但 score 是 double,整數超過 2^53(大概 9 千兆)就會失準。實測存 9007199254740993 進去,讀回來變成 9007199254740992。上面那個公式銷量大概可以撐到 90 萬件,再大就要換個算法。
常見使用情境:下單後 15 分鐘內未付款,訂單自動取消釋出庫存。
Day 6 的 List Queue 只能先進先出,做不到「時間到了才准拿」。把到期時間放進分數就可以:
ZADD order:delay <現在的時間戳 + 900> order:2   # 15 分鐘後關單
ZRANGE order:delay 0 <現在的時間戳> BYSCORE    # 撈出該關的
ZREM order:delay order:2
還沒到期的分數比現在大,怎麼撈都撈不出來,就一直躺在那裡。
/** 掃到期的:撈出 score 小於現在的,關完再 ZREM 拿掉 */
@GetMapping("/due")
public Map<String, Object> due() {
    long now = Instant.now().getEpochSecond();
    Set<String> due = zset.rangeByScore("order:delay", 0, now);
    due.forEach(orderId -> zset.remove("order:delay", orderId));
    return Map.of("closed", due, "left", zset.size("order:delay"));
}
下兩筆單,一筆已經過期、一筆還有 15 分鐘,掃一次只會關到第一筆:
curl -X POST "http://localhost:8080/delay/place?orderId=order:1&seconds=-60"
curl -X POST "http://localhost:8080/delay/place?orderId=order:2&seconds=900"

curl http://localhost:8080/delay/due

「撈出來」跟「ZREM 拿掉」是兩個指令,兩台機器同時掃會拿到同一筆訂單。要把它們合成一個原子操作得用 Lua,那是 Day 20 的事。
相關範例程式碼可以參考 https://github.com/gary880306/redis-30days/tree/dev
排行榜是「誰排前面」,但有些問題只是要「有幾個」——今天有幾個人簽到、這個頁面今天多少人看過。一千萬個使用者要是一人一個 key,記憶體先炸掉,繼續來看 Bitmap 和 HyperLogLog 怎麼做


 iThome鐵人賽
 看影片追技術