
前面幾天的型別都是「存什麼就有什麼」,要準確答案就得把資料整包留著。今天這兩個反過來,用很小的記憶體換一個夠用的答案。
Bitmap 不是新型別,底層就是 String,只是改成一個 bit 一個 bit 操作。一個 bit 只有 0 跟 1,剛好拿來記「有沒有」。
SETBIT key offset value(把第 offset 個 bit 設成 0 或 1,回傳這個 bit 原本的值)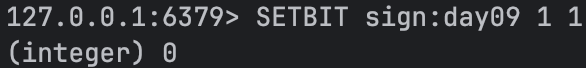
GETBIT key offset(看第 offset 個 bit 是 0 還是 1)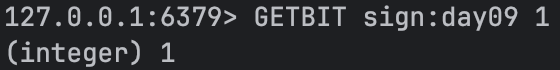
BITCOUNT key(這個 key 裡面有幾個 1)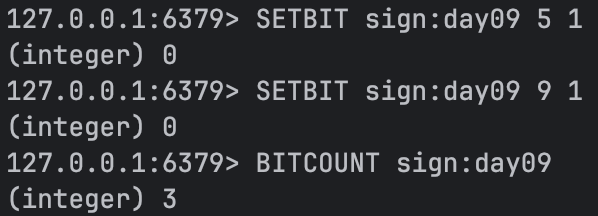
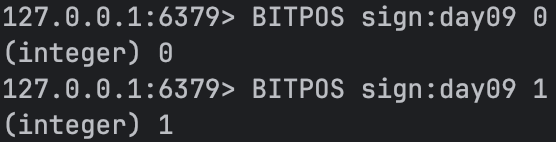
BITPOS key bit(第一個 0 或 1 出現在第幾位)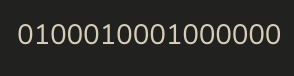
BITOP AND|OR|XOR|NOT dest key ...(把這幾個 bitmap 做位元運算,結果存進 dest,回傳 dest 的長度)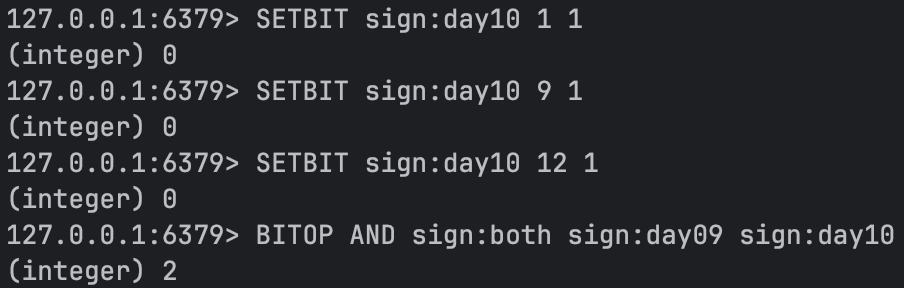
一個使用者一個 bit,userId 就是 offset:
SETBIT sign:day09 1 1
SETBIT sign:day09 5 1
SETBIT sign:day09 9 1

BITCOUNT sign:day09   # 3,day09 三個人簽到
GETBIT sign:day09 5   # 1,u5 簽了
GETBIT sign:day09 7   # 0,u7 還沒簽
同一個人重複簽,那個 bit 本來就是 1,再設一次還是 1。要問「今天幾個人簽到」也不用把名單撈出來,BITCOUNT 直接數。
Java 是用 ValueOperations 的 setBit / getBit:
/** 簽到:userId 就是第幾個 bit,setBit 回傳的是「原本」的值 */
@PostMapping("/{userId}")
public Map<String, Object> sign(@PathVariable long userId) {
    Boolean before = redis.opsForValue().setBit("sign:day09", userId, true);
    return Map.of("userId", userId, "firstToday", !Boolean.TRUE.equals(before), "total", count());
}

/** ValueOperations 只包了 setBit / getBit,BITCOUNT 要自己拿連線下 */
private Long count() {
    byte[] key = "sign:day09".getBytes(StandardCharsets.UTF_8);
    return redis.execute((RedisCallback<Long>) con -> con.stringCommands().bitCount(key));
}
上面 cli 已經把 u1、u5、u9 點亮了,先 DEL sign:day09 再打 curl,三個人簽到、其中一個再簽一次:
curl -X POST http://localhost:8080/sign/1
curl -X POST http://localhost:8080/sign/5
curl -X POST http://localhost:8080/sign/9

curl -X POST http://localhost:8080/sign/1   # 同一個人再簽一次
curl http://localhost:8080/sign/today


要算「連續兩天(day09 + day10)都簽到的人」就用 BITOP AND:
SETBIT sign:day10 1 1
SETBIT sign:day10 9 1
SETBIT sign:day10 12 1

BITOP AND sign:both sign:day09 sign:day10
BITCOUNT sign:both   # 2,只有 u1 和 u9 兩天都簽
兩個 bitmap 逐位 AND,兩邊都是 1 的才留下來。連續七天就給七個 key,一個指令算完。
把第 1000 萬號使用者點亮,看這個 key 多大:
DEL sign:day09
SETBIT sign:day09 9999999 1

BITCOUNT sign:day09       # 1,只有一個人簽到
MEMORY USAGE sign:day09   # 1310776
BITCOUNT 是 1,裡面明明只有一個人,這個 key 卻已經 1,310,776 bytes(約 1.25MB)。因為 offset 開到 1000 萬,Redis 就得先把 1000 萬個 bit 的位置配出來,除以 8 就是一百多萬個 byte。
位置既然配好了,剩下 999 萬 9999 個人全部簽完,再量一次還是 1,310,776。bitmap 的大小只跟「編號最大的那個人」有關,跟幾個人簽到無關。
同樣 1000 萬個人改用 Set 存,灌完資料再量一次(第一行只是拿來灌測試資料的,Lua 是之後會遇到的事):
EVAL "for i=1,10000000 do redis.call('SADD', KEYS[1], 'u'..i) end return redis.call('SCARD', KEYS[1])" 1 sign:set

MEMORY USAGE sign:set        # 601326704
MEMORY USAGE sign:day09   # 1310776
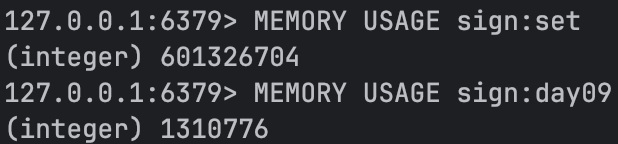
601,326,704 bytes,約 573MB。同一件事 bitmap 只要 1.25MB,差 459 倍。
但 offset 就是記憶體位置,userId 不連續的話會很浪費。 SETBIT sign:sparse 1000000001 1,只有一個人簽到,MEMORY USAGE 就是 134,217,784 bytes(128MB)。userId 是十位數流水號的話,得自己先映射成 0 開始的連號。
UV 是「今天有多少不重複的人看過」。用 Set 存得下但很貴,HyperLogLog 改成用固定大小估一個近似值:
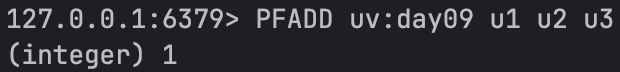
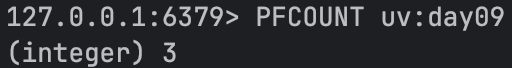
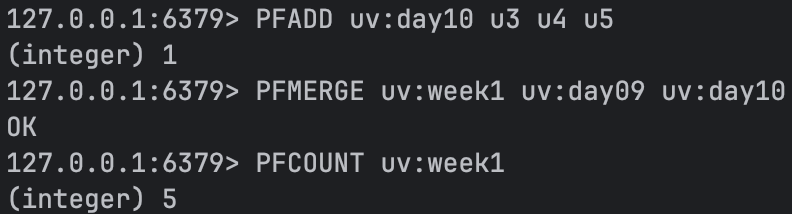
Java 有專門的 HyperLogLogOperations:
private final HyperLogLogOperations<String, String> hll;

public UvController(StringRedisTemplate redis) {
    this.hll = redis.opsForHyperLogLog();
}

/** 進來看一次就記一次,同一個人記幾次都只算一個 */
@PostMapping("/visit")
public Map<String, Object> visit(@RequestParam String user) {
    return Map.of("added", hll.add("uv:day09", user), "uv", hll.size("uv:day09"));
}
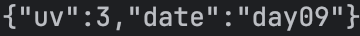
curl -X POST "http://localhost:8080/uv/visit?user=u1"   # u1 u2 u3 各打一次,u1 u2 再打一次
curl http://localhost:8080/uv
同樣 10 萬個人,一邊 PFADD、一邊 SADD。
先灌資料(這行在主機的終端機下,不是在 redis-cli 裡面):
for i in $(seq 1 100000); do echo "PFADD uv:day09 u$i"; echo "SADD uv:set u$i"; done | docker exec -i redis30days redis-cli --pipe
PFCOUNT uv:day09          # 100425
SCARD uv:set              # 100000

MEMORY USAGE uv:day09     # 14392
MEMORY USAGE uv:set       # 4772968
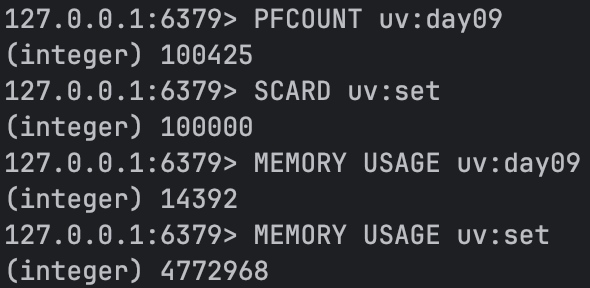
14,392 bytes 對 4,772,968 bytes,差 332 倍。代價是數出來是100,425,實際 100,000,誤差 0.43%。而且 HLL 大概塞到 2000 個人就定住了,再塞到 100 萬個量出來還是 14,392;Set 則是一路往上長。
報表上寫「今日 UV 10 萬」還是「100,425」沒有差別,這種場景就應該用 HLL。
但 HLL 只能回答「有幾個」,不能列出有誰,也沒有「某個人在不在裡面」的指令,Redis 根本沒有 PFEXISTS 這個命令。要名單、要精確,就只能回去用 Set。
相關範例程式碼可以參考 https://github.com/gary880306/redis-30days/tree/dev
Day 6 拿 List 當 Queue,結論是只適合「掉了也還好」的工作,沒有 ACK、沒有重試、沒有消費者群組。明天的 Stream 這三個都有,繼續來看真的能重試的 Queue


 iThome鐵人賽
 看影片追技術