
講完審核,工具終於走完「上傳 → 自動掃描 →人工審核」。最後留了一個問題:審核通過之後,
使用者要在哪裡看到它?
前面一直在處理後台:怎麼上傳、怎麼掃描、怎麼審核。但如果這真的是一個「內部工具市集」,最後還是要有一個地方,讓使用者可以找到已經通過審核的工具。所以今天把最後兩個
Phase 做完:Phase 7:Portal 與發布,以及 Phase 8:紀錄與稽核。
後台的東西都完成之後,才開始做前台 Portal。
最初最初可能就是一個 我要有前端
原本計畫大概是:
→ 建立 Portal 列表
→ 建立詳細資訊頁面
→ 實作搜尋
→ 實作狀態顯示
→ 控制哪些資料可以顯示
→ 控制誰可以發布、下架
→ 確認沒有通過審核的內容不能出現在 Portal
→ 確認 Portal 執行的版本就是審核通過的版本
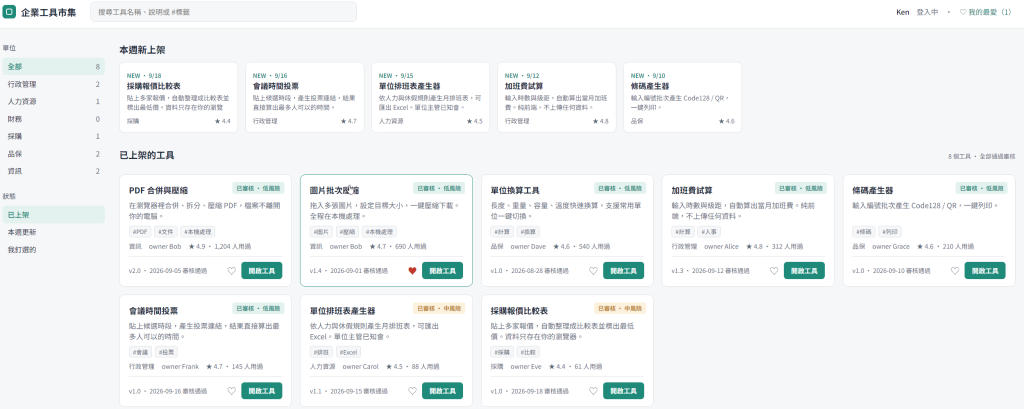
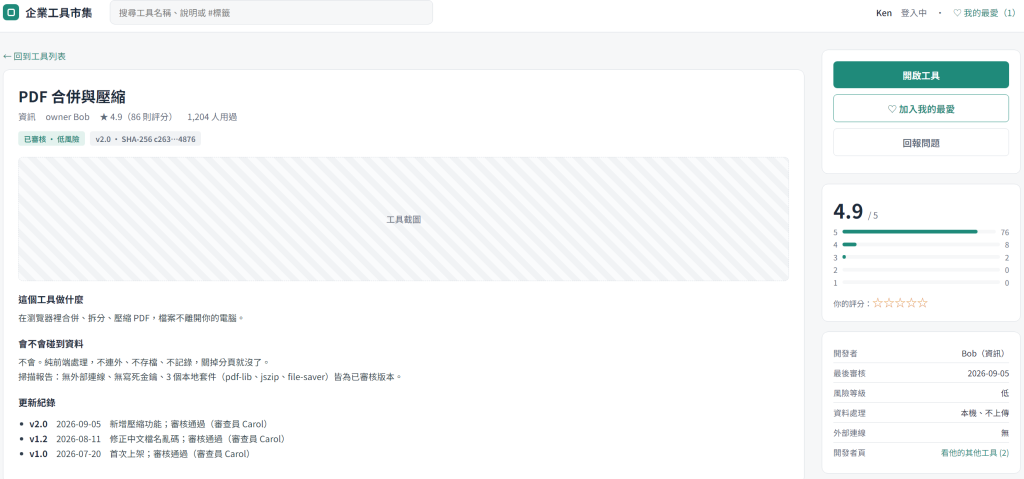
前台 Portal
看起來相對單純,不就是把工具名稱、說明、圖示整理成一個列表,讓使用者搜尋,點進去之後開始使用嗎?
但這裡有一件事情跟一般網站很不一樣:這個平台除了顯示自己寫的
Portal,還要讓使用者執行別人上傳進來的 HTML、CSS、JavaScript。
這兩件事情不能混在一起。
先從比較單純的地方開始。後台讓開發者填工具名稱、說明、標籤、版本資訊,Portal
再把這些資料顯示出來。如果只是想:「這些都是內部使用者自己填的,應該沒問題吧?」那很容易就會出事。
假設有人在工具名稱或說明裡放進特殊的 HTML / JavaScript 內容,而 Portal
又直接把這段資料當成 HTML 輸出,就可能形成 Stored XSS。Stored XSS
麻煩的地方就在於,惡意內容不是只影響上傳的人,而是被存進系統裡,之後每一個看到這筆資料的人都可能受到影響。
所以不能只想「輸入的時候我有檢查」。資料真正輸出到頁面時,還是要依它出現的位置做適當的
Encoding / Escaping,因為同樣一段資料,放在 HTML 內文、HTML Attribute 或
JavaScript Context,處理方式並不完全一樣。
這也是我在 Vibe Coding 時會特別提醒 AI 的地方:不要因為資料是從自己的
Database 拿出來,就把它當成可信任資料。 Database
裡面的東西,也可能只是之前某個使用者輸入進去的。
接下來才是 Phase 7
我覺得最重要的事情。一般網站是自己寫自己的頁面,但我現在設計的平台是讓使用者把
HTML、CSS、JavaScript 上傳進來,最後再讓其他人開啟。就算前面已經經過
Scanner,也經過人工審核,我還是不會因此假設「這段 JavaScript
從此就是可信任的」,因為掃描與審核降低的是風險,不代表它永遠不會出問題。
所以我會先問一個問題:如果其中一個工具真的出事,影響範圍能不能只停在這個工具?還是
A 工具出事之後,可以一路碰到 Portal,甚至影響其他工具?
這就是為什麼工具跟 Portal 之間要有一道牆。
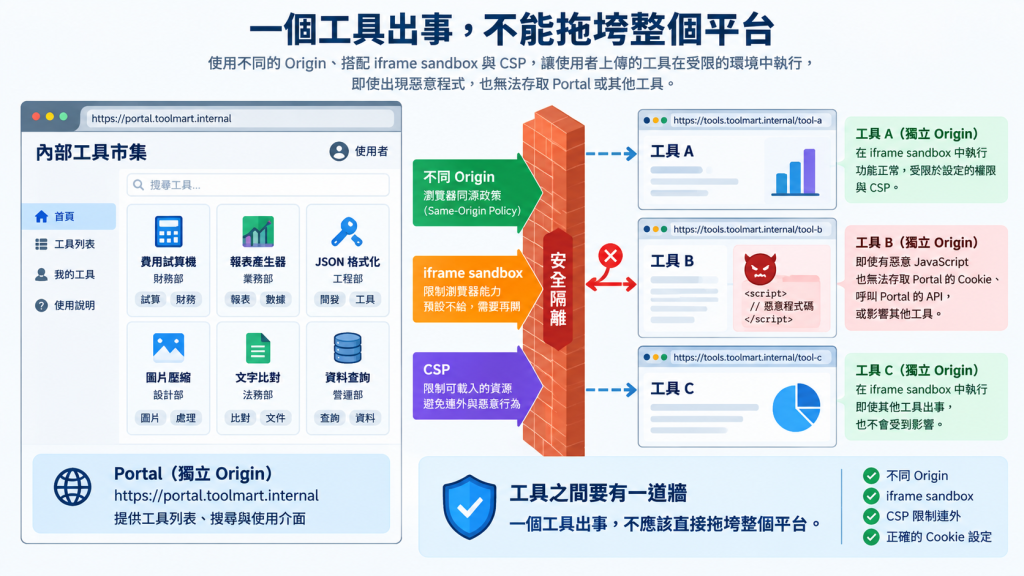
瀏覽器本身其實已經有一套很重要的安全機制:Same-Origin
Policy(同源政策)。Origin 主要看的是 Scheme + Host + Port,所以https://toolmart.internal/portal 跟https://toolmart.internal/tools/abc 雖然路徑不同,但它們還是 Same
Origin。換一個資料夾,不等於建立一道安全邊界。
如果 Portal 與使用者上傳的工具跑在同一個
Origin,瀏覽器會把它們視為同一個安全來源。這會讓工具裡的 JavaScript
有機會存取同 Origin 的資料、呼叫相關 API;如果
Session、權限或其他設定又沒有正確限制,原本只是一個工具的問題,就可能擴大成整個平台的問題。
所以我的設計方向會是:Portal 與使用者上傳的工具,使用不同 Origin。
例如概念上把 Portal 放在https://portal.toolmart.internal,工具則放在另外的
Origin,至少先讓瀏覽器知道「這兩個不是同一個安全來源」。
但這裡也不能只換個子網域就宣布大功告成。Cookie 的Domain、Path、HttpOnly、Secure、SameSite
等設定還是要一起考慮,避免原本想隔離,最後卻自己把 Session Cookie
的範圍放太大。
另一層可以利用 <iframe sandbox>。Portal
不一定要讓工具像普通網頁一樣什麼都能做,而是先把能力限制住,再依需求開放必要的權限。
概念跟前面講過的 Default Deny
很像:不是全部開放,再想辦法一個一個封,而是預設不給,需要什麼再開什麼。
iframe sandbox 可以限制很多瀏覽器能力,再透過不同的 allow-*
設定依需求開放。至於哪些工具需要哪些能力,就回到前面一直講的事情:依需求決定,而不是為了方便一次全部打開。
不然最後很容易又看到 AI
很貼心地說:「為了確保所有功能正常運作,我幫你把限制全部開啟。」然後
sandbox 就只剩名字叫 sandbox。
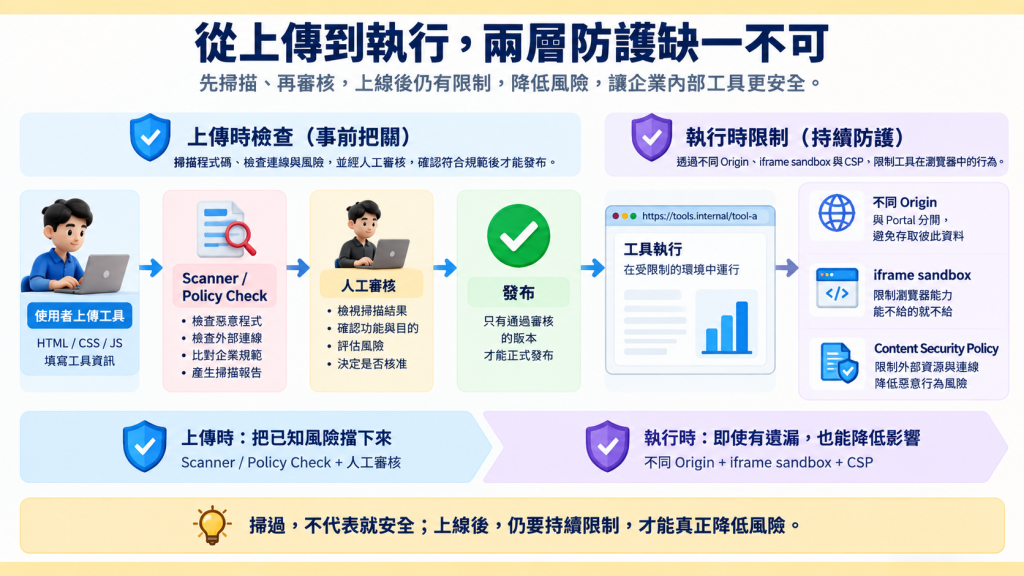
Day 18 已經做了 Policy Check,例如找出<script src>、<iframe src>、fetch()、XMLHttpRequest、WebSocket、sendBeacon(),看看程式碼中可以辨識的外部連線,再依企業規則判斷哪些可以、哪些不可以。
但那是在上傳時檢查。工具真正跑起來之後,我還希望再多一層 Content
Security Policy(CSP),例如限制 Script
可以從哪裡載入、能不能連外、哪些資源來源可以被使用。
所以這兩個不是二選一:Scanner / Policy Check 是上傳時檢查,CSP
是瀏覽器執行時限制。 前面漏掉的東西,不代表後面就只能祈禱。
一句話:工具跟 Portal
之間要有一道牆,一個工具出事,不應該直接拖垮整個平台。
Day 14
的紅線裡,我就先寫了一條:沒有審核通過的內容,不能被正式發布。 到了
Phase 7,這條要真的變成系統規則。
但不一定代表「沒審過之前完全不能產生 URL」。系統內部可能早就有 Tool
ID、Version ID,也可能有自己的
Route。真正重要的是:沒有通過審核、沒有正式發布的版本,不能因為知道網址就直接存取。
所以草稿、掃描中、待審、退回的版本,即使有人猜到網址或自己組 API
Request,後端仍然要根據「發布狀態 + 使用者權限」決定能不能開。
同樣地,工具一旦下架,就不能只是「從 Portal
首頁把卡片隱藏」。如果原本的網址還是可以直接打開,那根本不叫下架。下架之後,Portal
搜尋不到,直接存取也應該被後端擋掉。
這跟前面講權限時是一樣的概念:看不到,不代表進不去。
還有一個很容易出現的做法:API
一次把已上架、待審、退回、內部備註、審核資訊全部送到
Browser,然後前端再用 JavaScript 或 CSS
決定哪些要顯示。畫面上看起來很乾淨,但按 F12:全部都在。
所以前端不應該負責「保密」。一般使用者只需要看到已發布工具,那 API
就只回他有權限看到的資料;管理者需要看到待審資訊,再由後端確認權限後回傳。
這其實又回到前面講過的:安全控制要做在後端,不是把東西送到前端再藏起來。
Day 19 講過:通過的是「這一版」,不是這個工具永久取得通行證。
所以 Portal 這邊也要接得起來。假設 Version A 經過 Scanner、人工審核後
Approved,最後發布的就應該是 Version A。不能核准完 Version
A,後面偷偷把內容換成 Version B,Portal 還繼續顯示「已核准」。
系統實作上,可以利用前面建立的 Version ID 與
Hash,確認目前準備發布或提供使用的
Artifact,就是當初被掃描、被核准的那一份。如果對不上:不發布。
而不是「應該差不多啦」。
做到這裡,我會故意測幾件事情:
這個 Phase 我主要關心的是:Stored
XSS、工具隔離、資料曝光、存取控制,以及發布版本是否真的跟核准版本一致。
做到 Phase 8,功能其實差不多都完成了。最後要做的,是把前面每個 Phase
已經產生的紀錄收攏起來,形成完整的 Audit Trail。
原本計畫大概是:
→ 記錄登入與登出
→ 記錄上傳與修改
→ 記錄送審
→ 記錄退回與通過
→ 記錄發布與下架
→ 記錄重要權限異動
→ 記錄重要流程狀態變更
→ 確認 Log 不會記錄密碼、Token、API Key 等敏感資料
其實前面不是完全沒有
Log,登入有紀錄、上傳有紀錄、審核有紀錄、版本也有紀錄。Phase 8
比較像是:把散落在各個功能裡的紀錄,整理成一套真的可以追事情的 Audit
Trail。
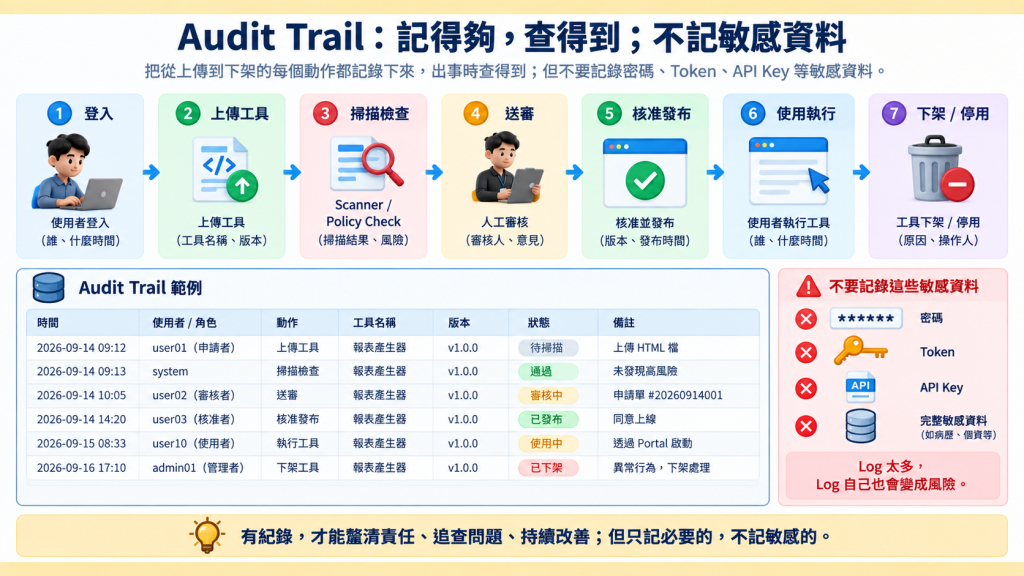
假設今天出了一件事情,我去查 Log,只看到 Approved.,這筆 Log
幾乎沒有什麼用。
我真正想知道的是:誰?什麼時候?做了什麼?對哪一個 Tool / Version
做?原本是什麼狀態?最後變成什麼狀態?必要時,從哪一個來源 IP 操作?
而且最好還能跟前面的 Tool ID、Version ID、Review ID
或其他事件識別資訊對得起來。
這樣真的發生事情時,我才能把 登入 → 上傳 → 掃描 → 送審 → 核准 → 發布 →
下架 一路串回去。不然 Log
很多,卻彼此完全對不起來,最後還是只能人工猜。
再來是一個很直覺,但常常最後才想到的問題:如果使用者可以修改自己的操作紀錄,那這份
Log 還有什麼意義? 做完事情,再把紀錄刪掉就好了。
所以重要的 Audit Trail
不能讓一般使用者任意修改或刪除。如果企業本來就有集中式 Log、SIEM 或
SOC,也可以把重要的安全事件與稽核紀錄送出去;至少不要讓所有關鍵紀錄只存在一個應用程式自己就能任意修改或刪除的位置。
另外還有一個很不起眼,但真的出事時很重要的東西:時間。 如果 A
系統顯示 10:05、B 系統顯示 10:12、Firewall
又顯示另外一個時間,事件要串起來會非常痛苦,所以系統時間也要有一致的時間同步來源。
這些平常看起來都很無聊,真的在查事件時,就知道差多少。
講到
Log,很容易又走到另一個極端:既然怕查不到,那全部記起來不就好了?
然後密碼也記、Token 也記、API Key 也記、完整 Request Body
也記、敏感資料也記,最後原本想做稽核,卻自己做出一個超大型資料集中區。
所以 Log
不是越多越好。例如驗證失敗,我需要知道「誰在什麼時間發生驗證失敗」,不代表我需要把「他剛剛輸入的密碼是多少」也留下來。同樣地,我可能需要記錄某個
API Credential 被建立、更新或撤銷,但不代表要把 Credential 本身寫進
Log。
所以我的原則很簡單:Log 太少,出事查不到;Log 太多,Log
自己變成風險。
我要留下的是足夠還原事件的資訊,不是把所有資料複製一份塞進 Log。
做到這裡,我原本規劃的八個 Phase 終於全部走完:
Phase 1:專案骨架與環境
Phase 2:登入與身分驗證
Phase 3:角色與權限
Phase 4:檔案上傳與儲存
Phase 5:資安掃描
Phase 6:送審與人工審核
Phase 7:Portal 與發布
Phase 8:紀錄與稽核
原本一句「做一個企業內部工具市集。」真的拆開之後,裡面其實有一大堆事情。而且這些
Phase
並不是什麼標準答案,也不是每一個系統都一定要切成八段,這只是我針對這個需求拆出來的一種方式。
但拆到這裡之後,又出現一個我覺得更實際的問題。之前有主管問過我:
「AI 寫完一個系統,上萬行程式碼,你怎麼知道它寫得有沒有問題?」
這個問題其實正好打中 Vibe Coding 很麻煩的一個地方。AI
寫程式真的很快,一個 Phase
下去,可能新增、修改、刪除幾百甚至幾千行,但我不可能每一次都重新把整個專案從第一行看到最後一行。
那我要怎麼知道:「AI 這一次到底改了什麼?」
又怎麼知道:「它有沒有順手幫我多做了什麼?」
甚至:「這一次改壞了,我回不回得去?」


 iThome鐵人賽
 看影片追技術