
架構圖畫完了,可以開工了嗎?
我認為還不行,因為還沒先想想哪裡可能出事
這就是威脅建模在做的事。
其實這件事情並不難,尤其在現在這個 AI 時代,我們已經有了更多工具可以協助完成這些工作。
我一直認為,AI 不應該只是幫我們把過去需要花很多時間處理的事情做得更快,
它更應該幫我們補上那些以前明明知道該做,卻一直沒時間做的事情。
哪些事情該做卻沒做?為什麼沒做?我想很多人心裡都有答案。
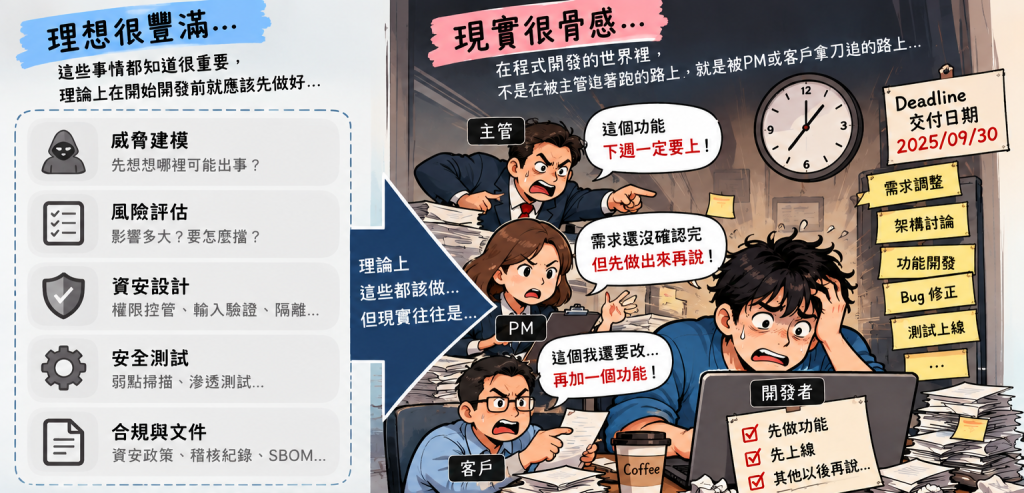
在程式開發的世界裡,不是在被主管追著跑的路上,就是被PM或客戶拿刀追的路上
需求還沒確認完,交付日期就已經訂好了;
架構還沒討論清楚,功能就被要求先做出來。
至於威脅建模、風險評估這些事情,大家可能都知道很重要,
但在各種時間與人力的壓力下,就就這樣被放到最後面或忽略掉。
既然現在 AI 能幫我們加快需求整理、架構設計與程式開發,那省下來的時間,
是不是也應該拿一部分來做以前沒時間做的事?
這就是這篇要講的重點:
不管是你用vibe coding或自己動手寫之前,透過 AI 協助進行威脅建模,
找出可能被忽略的問題,再判斷哪些風險需要優先處理。
各位有沒有想過,一個系統,到底可能遭受哪些攻擊?同一套系統,放在不同的網路環境,面對的威脅會一樣嗎?
以我正在規劃的企業內部市集為例,原本預計只開放企業內網使用,外部網路無法直接連線。
但誰能保證,未來不會因為使用方便或主管要求,被放到外部連線?
再來只要系統沒有對外開放,就代表沒有資安威脅了嗎?
相信經過這麼多新聞事件的,肯定是否定的。
光是內部人員利用系統漏洞或濫用既有權限,就已經有不少值得警惕的案例。
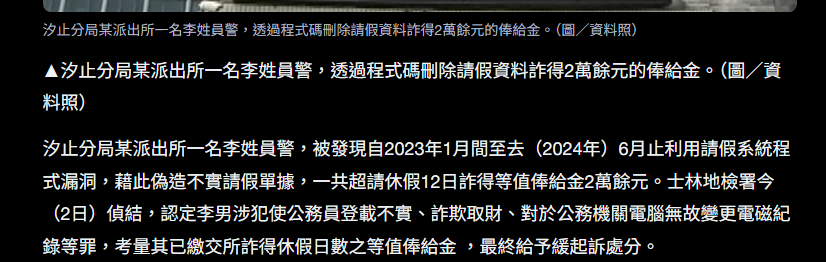
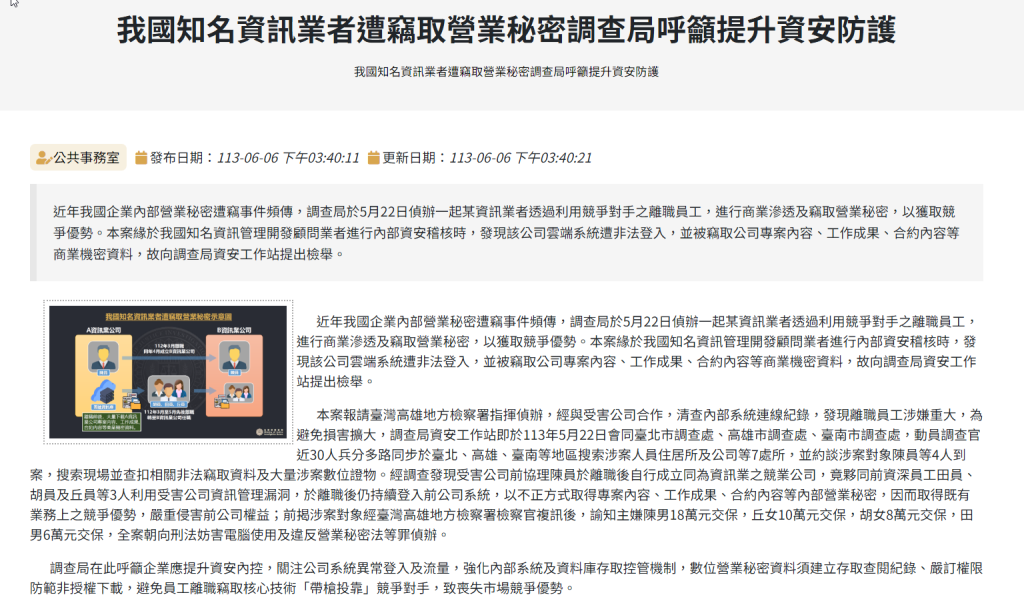
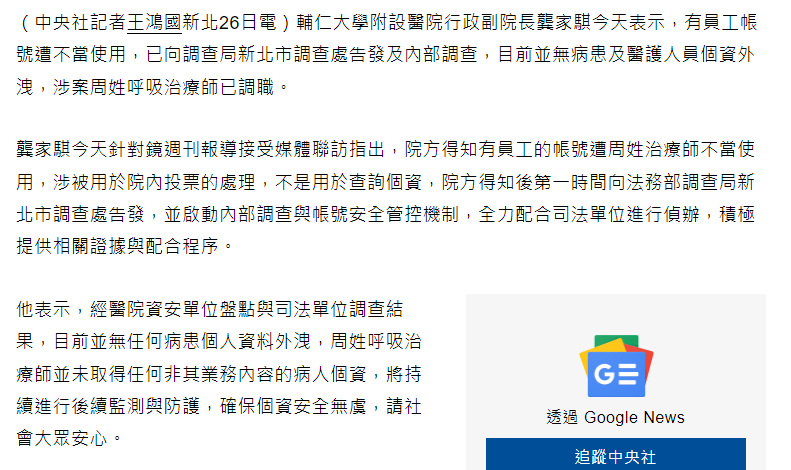
不管哪個行業只要是個網頁、服務、系統在企業內部使用,就有不少問題值得先想一想。
我預計系統是放在企業內部使用,所以那可能面臨到哪些問題 ??
這些都只是從企業內部使用的情境出發。
如果未來真的開放外部連線,還必須進一步考慮來自網際網路的更多的攻擊行為
而且我上面列出的幾個問題也不全都是惡意攻擊。
例如主機故障,就屬於可用性與營運持續性的風險。雖然它不一定是威脅建模主要處理的攻擊情境,但在規劃系統時,同樣不能忽略。
不對外開放,可以減少攻擊入口,但不代表企業內部的設備、帳號、檔案與系統就全部值得信任。
問題列出來之後,接下來就可以回到昨天那張架構圖,找出這些威脅可能發生在哪些環節、會影響哪些元件,以及目前的設計有哪些地方還需要補強。
AI不只能幫你寫程式幫你設計
這次可以反過來問它:
「我在做威脅建模,情境是放在企業內部的系統,如果你看到這張架構圖攻擊這套系統,你會從哪裡下手?」
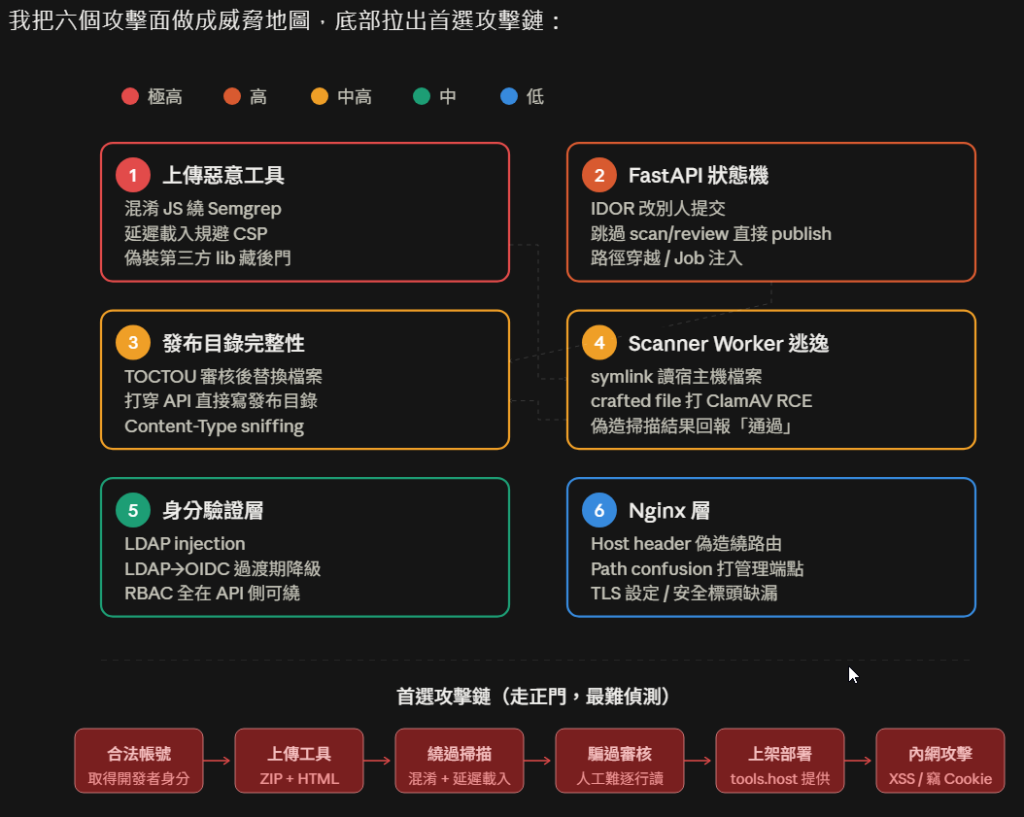
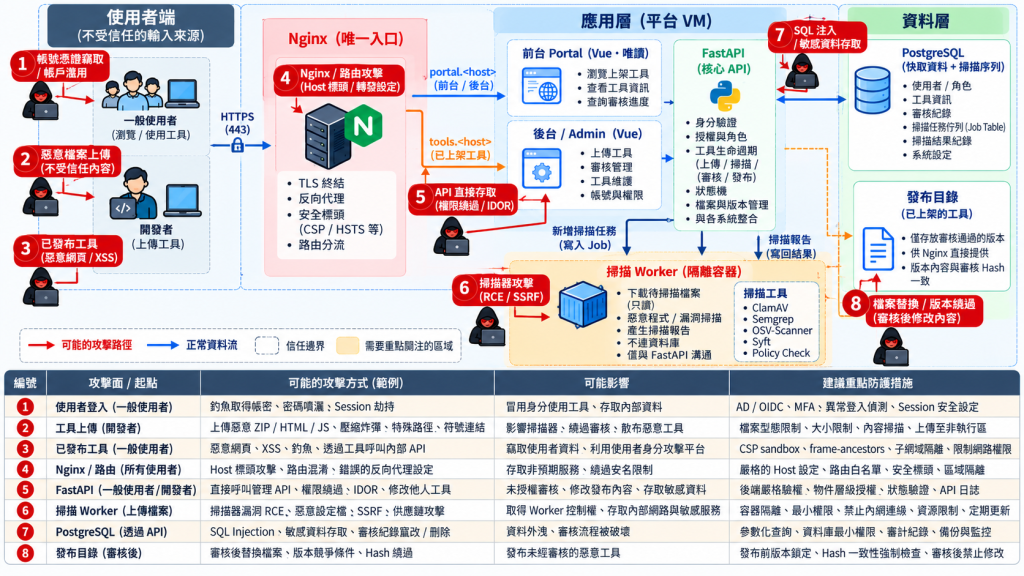
從這兩張圖你看到了甚麼 ????
我看到的是
攻擊入口不只一個
除了登入畫面,工具上傳、後端 API、掃描 Worker、Nginx,甚至已經發布的工具,都可能成為攻擊入口。系統功能越多,代表需要檢查的地方也越多。
攻擊者可能利用正常功能完成攻擊
例如,取得合法的開發者帳號後,上傳藏有惡意程式碼的工具,再嘗試繞過掃描或審核。即使沒有突破企業防火牆,也可能對平台造成影響。
原本負責保護系統的元件,也可能反過來遭到攻擊
我們設計掃描 Worker 是為了檢查惡意檔案,但它必須先接觸這些不可信任的檔案。如果掃描工具本身存在漏洞,會不會反而成為攻擊者入侵平台的機會?
一個地方出事,可能一路影響其他元件
假設攻擊者成功控制掃描 Worker,能不能接著存取資料庫?如果繞過後端權限檢查,能不能直接發布未經審核的工具?如果已發布的工具含有惡意 JavaScript,會不會進一步影響使用它的員工?
看完這兩張圖,我才發現我設計的流程,換個角度看,也會變成一條攻擊路徑。
不過,AI 畫出可能的攻擊路徑,不代表系統真的存在這些漏洞。
例如圖上出現 SQL Injection,不代表目前的程式就有 SQL Injection;
標示高風險,也不代表已經完成風險評估。
其實就是建立一個風險評估矩陣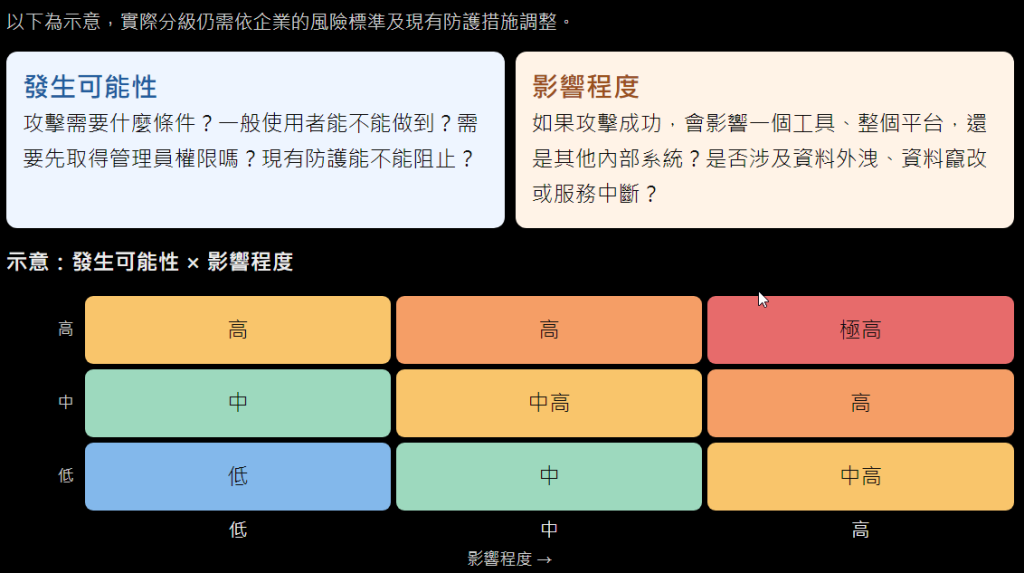
風險評估的方法論或標準其實有非常多種,像是:
ISO 27005、NIST SP 800-30、FAIR、OCTAVE,每一種都有自己的評估方式和適用場景。
但在這個系列裡,實在沒時間跟篇幅再來逐一說這些差異再哪,大家可以再查看看相關文章。
而且在現在對於 Vibe Coding 的使用者來說,只要「知道要想要做這件事」就已經很棒了。
這邊我用最簡單的方式來舉例:可能性 × 影響 = 風險等級。
可能性:這個攻擊需要什麼條件?需要內部帳號還是外部就能打?需要特殊技術還是一般人就做得到?
影響:成功了會怎樣?一個人的資料被看到,還是整個平台被拿下?能不能復原?
以我這個平台來說,先根據目前預計採用的架構與安全措施,
做一張假設性評分表,等系統完成、實際驗證控制措施後,還需要重新評估。
| 威脅 | 初步可能性 | 潛在影響 | 初步優先順序 |
|---|---|---|---|
| 合法帳號上傳惡意工具,繞過掃描和審核 | 中高(假設帳號遭盜用,且掃描、審核存在可利用的弱點) | 極高(可能影響大量使用者) | 最優先 |
| 直接呼叫 API 跳過審核發布 | 中(假設後端授權或狀態檢查存在缺陷) | 高(未審核工具可能上架) | 高 |
| 核准後偷偷替換檔案 | 中(假設已核准版本仍可修改或替換) | 高(審核結果可能失去效力) | 高 |
| 掃描 Worker 被入侵 | 低(假設掃描元件已更新,且有適當隔離) | 高(視 Worker 權限與網路存取範圍而定) | 中 |
| SQL Injection | 低(假設全面使用參數化查詢並經過測試) | 高(可能造成資料外洩或竄改) | 中 |
| Nginx Host Header 或路由設定錯誤 | 待驗證 | 視可存取的服務而定 | 待評估 |
為什麼是假設? 因為:
**「只需要一個帳號」**不代表一定能成功繞過掃描和審核;
**「使用 ORM」**也不代表一定不會發生 SQL Injection;
**「只開放內網」**更不能直接證明某個漏洞的風險很低
攻擊情境能不能成立、防護有沒有效果都需要驗證。
還是要提醒一下這種這不是企業正式的風險評估報告,是我自己在開發前整理可能攻擊情境的方式。
正式環境要上線,還是要依照企業的風險管理制度,完成必要的評估審查。
威脅建模不是把AI找出的所有攻擊方式都當成漏洞,而是讓我們在開始寫程式之前,就知道哪些安全問題必須在設計與測試階段得到答案,這也是資安左移的非常核心觀念
評估完不會立刻就進入Vibe Coding ,應該是要先確定每一條威脅要怎麼處理,有沒有防護措施,在開發的時候要注意甚麼來避免威脅真的發生,主機在設定的時候該怎麼設定,在申請網路的時候應該請網管怎樣設定,用諸多的控制措施來把風險降低
風險處置分為四種:
前面列出的威脅為例子,我大概初步整理出下面這些:
| 威脅或風險 | 初步處置方式 |
|---|---|
| 合法帳號上傳惡意工具 | 降低:掃描 Pipeline、人工審核、工具執行環境隔離與 CSP |
| 直接呼叫 API,試圖跳過審核 | 降低:後端狀態機、Default Deny、三層授權 |
| 核准後偷偷替換檔案 | 降低:上傳版本不可變更,掃描、審核及發布綁定同一版本與 SHA-256 |
| 惡意檔案攻擊掃描 Worker | 降低:容器隔離、最小權限、非 root 執行、不允許直接連線資料庫 |
| SQL Injection | 降低:參數化查詢、最小資料庫權限及安全測試 |
| Nginx Host Header 或路由設定錯誤 | 降低:限制允許的 Host、預設拒絕未知主機名稱,並檢查路由與後端授權 |
| 自行管理另一套使用者密碼 | 降低:整合企業既有 AD,避免自行建立密碼管理機制 |
| 使用者上傳後端程式所帶來的執行風險 | 避免:第一版只接受靜態檔案,不提供後端程式執行環境 |
這裡還是要注意,風險處置不是在表格填完「降低」兩個字就結束。安全措施到底有沒有落實、能不能有效阻止攻擊,以及採取措施之後還剩下多少風險,都需要在開發和測試階段確認。至於決定接受某項剩餘風險,也不能只憑一句「反正是內網」,而應該依照企業制度進行評估與核准。
做到這裡,前面列出來的威脅,才真正開始變成可以執行的工作。例如,為了避免核准後的檔案被替換,我就必須要求平台把掃描結果、審核紀錄與實際發布的檔案,綁定在同一個不可變更的版本上。
在來就就要把這些結果補進前面已經產出的專案文件
PLAN.md 記錄需要實作的功能、安全需求與驗收條件
CLAUDE.md 寫清楚 AI 開發時必須遵守的規則與紅線
PHASES.md 把要求安排進各個開發階段
settings.json 則依照實際支援的功能,限制 Claude Code 可使用的工具與操作權限
然後放去前面提到的WSL2指定的專案資料夾內準備Vibe Coding


 iThome鐵人賽
 看影片追技術