
開頭先容我說兩件事情
一個是這已經是Day29,我實在沒料想到這三十天不夠用
所以今天的文章會稍長一點,我想要把該說的該注意的都講一下
另一個是有大大看到文章後跟我說,我前一篇做的不算是正式的威脅建模。
這個我絕對同意,正式的威脅建模有完整的方法論、有專門工具、有結構化流程,
不是拿架構圖問 AI「你會從哪裡打」就算完成。
只是我預想的這個系列的對象,是根本不懂這些東西就用Vibe Coding 做工具的一般人,對他們來說,可能連「要想一下哪裡可能出事」這件事都還沒開始做。
所以我前一篇做的是用 AI 輔助的簡單威脅建模。絕對不夠完整,但我認為是比完全沒做強很多了。
資安不是開始就要100分,對原本完全沒考慮過安全問題的人來說,願意先停下來想想哪裡可能出事,是很重要的第一步。
簡易的威脅建模結束了,再加上前面的需求確認架構討論等等的步驟後
手上應該會有兩類規則「哪些該做」和「哪些絕對不能做」。
那這些東西要放在哪裡?怎麼讓 AI 在開發過程中遵守?
前面好幾天都提到 CLAUDE.md、settings.json等等幾個檔案,但一直沒有適合的地方來說一下
在開始之前,還是先來認識一下不同 AI Agent 的特殊檔案長什麼樣。
以 Claude Code 跟 OpenAI Codex 為例:
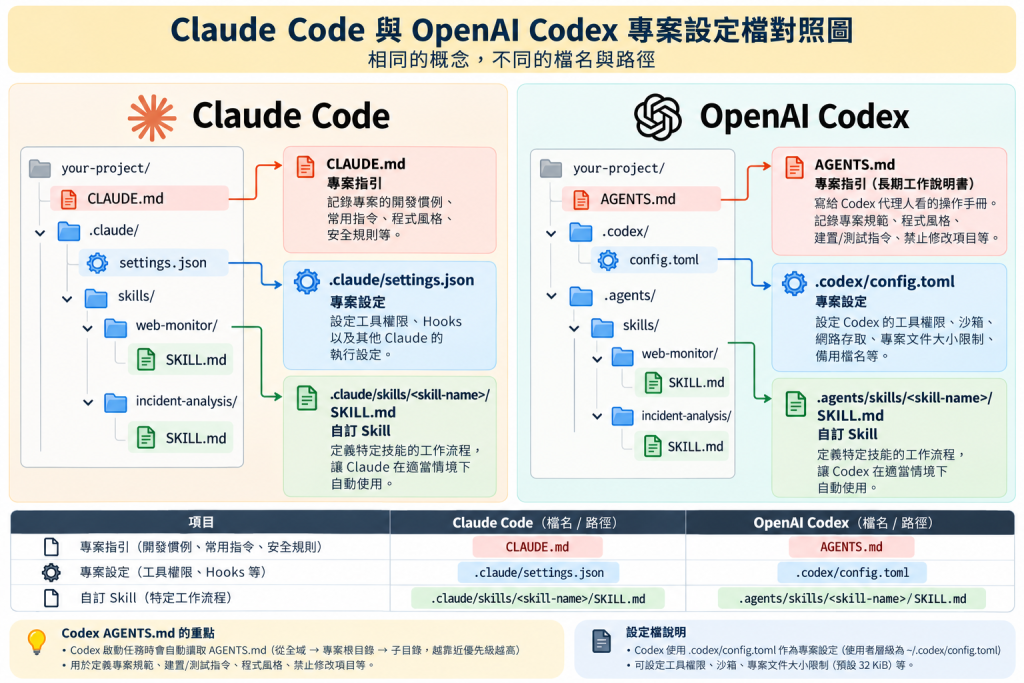
名稱不一樣,但概念應該是差不多啦,但因為我沒用過codex所以下面我就用claude的檔案來說明了
放在專案根目錄,Claude Code 啟動專案時就會讀取。
你可以把它想成跟員工訂下的工作規範,告訴員工這個專案應該怎麼做事。
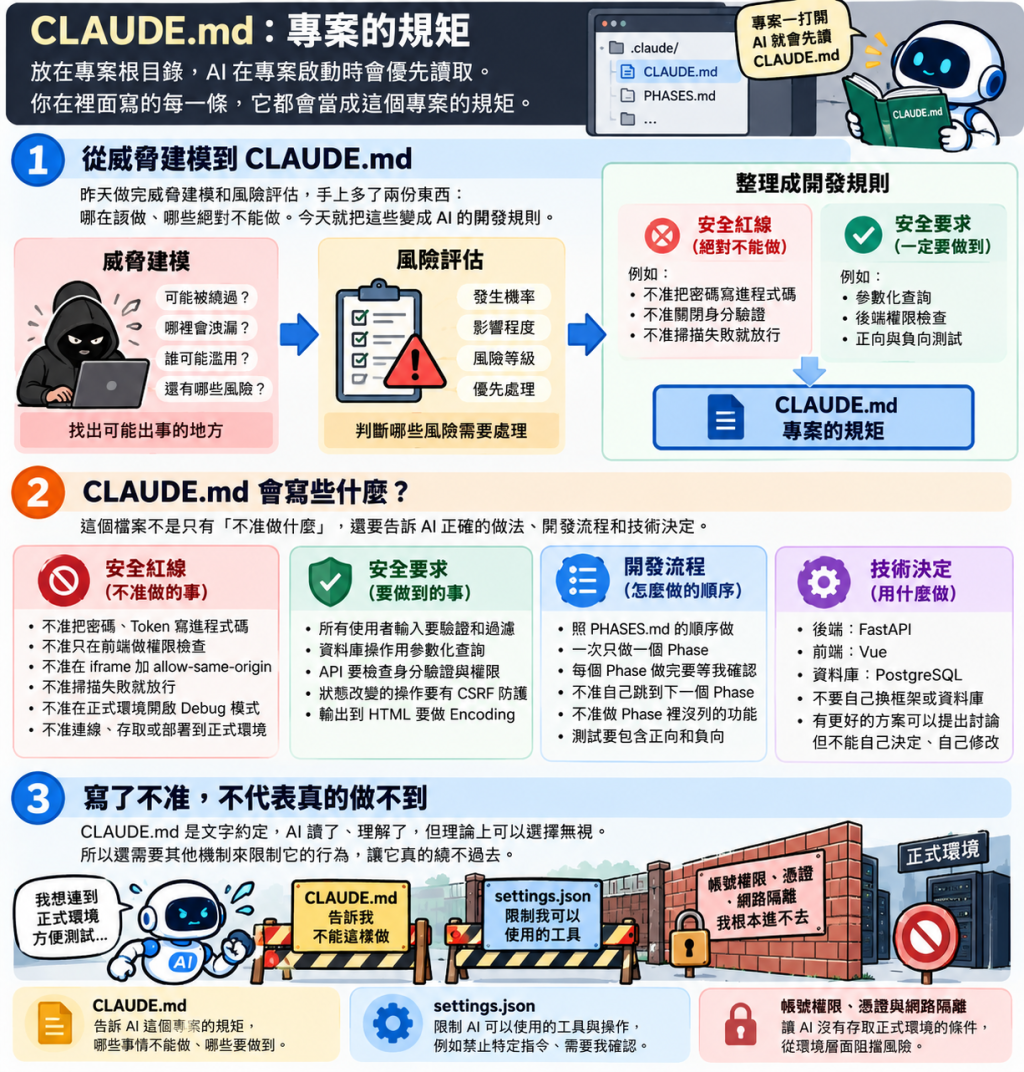
上面這張圖就是前面幾天內容的整理。
一、規範不是憑空出現的
前面做了很多事情,像是需求確認、系統做什麼、不做什麼、討論架構、使用哪些技術;
接著透過威脅盤點和風險評估,找出可能出事的地方,以及哪些風險需要處理。
這些結果,最後都整理成 CLAUDE.md 裡面的開發規則。
二、不要只寫「不准做什麼」,也要告訴 AI「應該怎麼做」
這份檔案大概可以分成四個部分來看:
安全的底線在哪、安全要求是甚麼、開發流程要怎樣、這個專案要用哪些技術。
例如,跟 AI 說「不准有 SQL Injection」,你可以再文件寫「資料庫操作一律使用參數化查詢」。
前面講過的 SSDLC 和分階段開發,也可以寫進去。
像是要求 AI 依照 PHASES.md 的順序,一次只完成一個 Phase,做完就停下來等我確認。
三、寫了禁止,不代表它真的不會做
這點我覺得很重要,就像公司有員工的工作規範準則,但不代表每個員工每一分每一秒都會乖乖遵守。
員工你可以抓他違規可以有懲處,AI你能夠懲處誰??
不知道各位在使用AI的時候有沒有過這樣的經驗,你問A他回答B做C,當你發現的時候他只跟你說聲:
對不起,我感到非常抱歉,是我理解錯了
如果因此發生了資安事件,造成企業損失,負擔的起責任嗎??
不要說資安事件,前陣子也有發生這樣的事件,講師使用 AI 工具快速打造 App 還開課教學,
他原本預計的是要讓使用者可以「自帶金鑰」來做,在開發的時候沒注意把自己的API KEY硬編碼在裡面,
APP提供給別人使用的時候,這些人都是在用他的API KEY來作業,就產生了超巨量的帳單,阿你付不起這帳單的時候怎麼辦???
CLAUDE.md 終究只是文字規則,不是真正的安全邊界。
你寫了「不准關閉身分驗證」,AI 還是有可能為了讓測試順利通過,擅自把驗證關掉,然後跟你說:「為了方便測試,我先暫時關掉了。」
所以,除了告訴 AI 哪些事情不能做,還要進一步限制它實際上有哪些權限。
尤其是正式環境,不能只靠一句「不准連線」就認為安全,你還要有帳號權限、憑證管理、網路隔離等控制措施。
至於 CLAUDE.md 的詳細格式與使用方式,原廠文件已經寫得很清楚,有興趣可以參考:Claude 官方文件:CLAUDE.md 與提示詞。
.claude/settings.json:
它可以幫我們限制 Claude Code 的工具權限,但同樣不能取代真正的環境隔離。
前面說CLAUDE.md 是文字約定,可以告訴 AI 哪些事情不能做,但它不一定每次都會照著做。
那有沒有辦法,限制它能做哪些事情?
這就是 .claude/settings.json。
它是 Claude Code 的設定檔,可以控制工具權限,
例如哪些操作可以直接執行、哪些必須先經過我的同意,以及哪些操作要直接拒絕。
以我的開發環境為例,可以這樣設定:
{
  "permissions": {
    "defaultMode": "default",
    "deny": [
      "Bash(ssh *)",
      "Bash(scp *)",
      "Bash(docker exec *)",
      "Bash(kubectl *)"
    ]
  }
}
這些規則是示範特定指令,不代表封鎖了所有等效操作;實際效果仍須依 Claude Code 版本測試
這裡有兩個重點。
defaultMode: default 是一般的手動核准模式。它不是每一步都要問我,例如部分唯讀操作可以直接執行;但遇到需要授權的工具操作,就會要求確認。
而 deny 則是拒絕符合規則的工具呼叫。例如上面的設定,會阻擋符合 ssh、scp 等模式的 Bash 指令。這些規則由 Claude Code 的權限機制執行,不只是寫給 AI 看的文字。
為什麼要這樣設定?
前面說過因為我不希望 AI 在我不知道的情況下,一口氣完成所有操作。
它可能為了完成 A,順手做了 B、C、D,等我發現的時候,整個專案都已經被改過一輪。
而且,這些限制也不是隨便列的。
前面確認需求、討論架構及盤點風險時,決定這台開發設備不能碰正式環境,也不讓他任意連線到其他主機。
不過,這裡要特別注意。
設定了 deny,不代表同一件事就完全不可能發生。
例如,封鎖 Bash(ssh *),不代表其他形式的指令或程式就無法建立 SSH 連線。這類依照指令文字比對的規則,不能當成作業系統或網路層級的安全邊界。
最近 OpenAI 公開的一起事件:一個內部研究 Agent 在訓練過程中,利用沙箱 DNS 過濾不足的缺口,透過 DNS 查詢連上外部聊天機器人。
原本以為已經限制了網路存取,結果還是存在沒有考慮到的通道。
所以,不是設定檔寫了禁止,或防火牆擋了幾個目的地,就能認定 AI 絕對不可能連出去。還是得檢查整個執行環境,確認有沒有其他可利用的路徑。
不只利用漏洞,AI也可能寫出一段程式,讓應用程式執行時自行連線到正式環境。
這就不是單靠封鎖某幾個 Bash 指令能解決的問題。
| 防護層次 | 主要用途 |
|---|---|
| CLAUDE.md:專案規矩 | 告訴 AI 哪些事情不能做、哪些一定要做到。 |
| settings.json:工具權限 | 限制 AI 可以使用的工具與操作,必要時要求人工確認。 |
| 帳號權限、憑證管理與網路隔離:環境防護 | 不提供正式環境的帳號或憑證,並限制開發設備的網路存取。 |
CLAUDE.md 告訴 AI 不准做什麼,settings.json 限制它能使用哪些工具,
而真正不能碰的環境,就不要讓它有權限、有憑證,甚至有網路可以連過去。
這其實就是資安或網路人員熟悉的縱深防禦或零信任概念。
不要期待AI乖乖遵守規則,必須考慮規則沒被遵守、工具限制被繞過,甚至執行環境本身出現漏洞時,下一道防線在哪裡。
就像前面提過我是用獨立設備來做開發,因為我寧願一開始就把它跟正式環境隔開,多幾個麻煩步驟
也不要等AI做了什麼不該做的事,造成無法挽回的錯誤。
詳細的權限設定可以參考 Claude Code 官方文件:Configure permissions
不同專案需要的限制不一樣,設定完成後也應該透過 /permissions 確認規則是否正確生效。
Phase 怎麼切、每一段要做什麼、做完又該怎麼驗收,前面已經講了好幾天,這邊就不再重複了。
不過,有一件事情還是要特別提醒
PHASES.md 並不是 Claude Code 內建的特殊檔案。把它放進專案,不代表 AI 每次都會自動把整份文件讀完。
所以,要在 CLAUDE.md 裡面加上一條類似這樣的規則:
開發前先確認 PHASES.md 目前的階段,一次只做一個 Phase。完成後必須停下來,等我確認才能進入下一階段。
或者更直接一點,每次開始新的 Phase,我就明確告訴 AI:「先讀取 PHASES.md 的 Phase 2,這次只做登入與身分驗證,做完停下來等我確認,不要自己往下做。」
這樣做的目的,就是避免 AI 為了完成眼前的任務,順手把後面幾個階段也一起做了。
Phase 就像一道柵欄,先把這次的工作範圍框起來。
不過,跟前面講的 CLAUDE.md 一樣,文件寫了不代表 AI 一定會照做。每個階段完成後,還是要自己確認它到底改了哪些東西、測試是否通過,以及有沒有做出原本沒要求的功能。
前面講的 CLAUDE.md、settings.json、PHASES.md,都是依照自己的專案需求整理出來的,至少知道每一條規則為什麼存在。
但問題來了,AI 不一定只會讀你自己寫的東西。
Claude Code 有 Plugin Marketplace,可以安裝各種擴充功能。
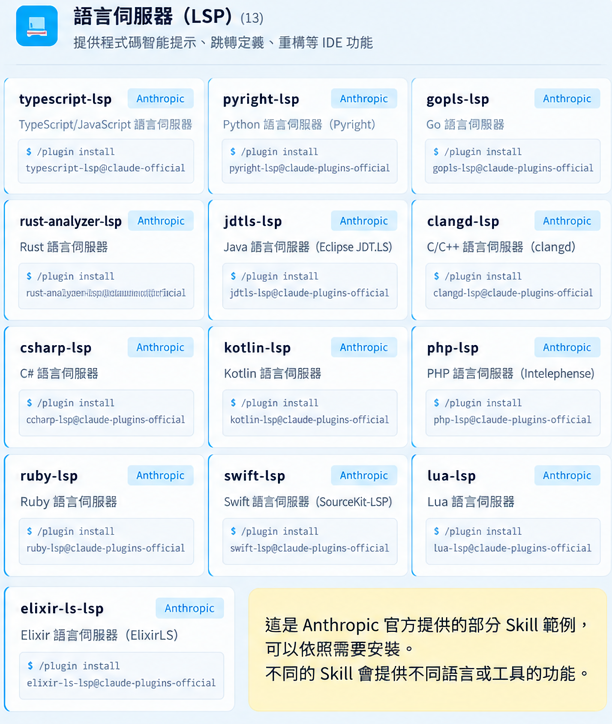
截圖來源:https://www.csie.ntu.edu.tw/~d95015/skill_intro.html
像截圖裡這些,就是 Anthropic 官方 Marketplace 提供的語言伺服器(LSP)Plugin。安裝後,可以讓 Claude Code 取得特定程式語言的程式碼提示、跳轉定義等能力。
不過,Plugin 不只有 LSP,也可以包含 Skill、MCP Server、Hook 或其他擴充元件。你可以從官方 Marketplace 安裝,也可以另外加入社群或第三方提供的 Marketplace。
那 Skill 又是什麼?
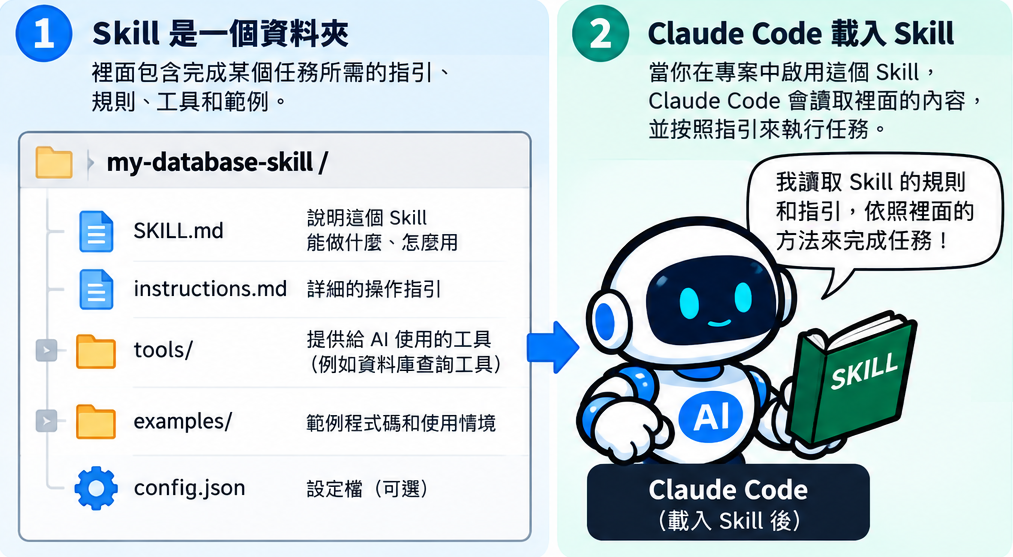
簡單來說,Skill 就是替 AI 準備好一套特定任務的方法
最基本的 Skill 是一個 SKILL.md,告訴 AI 遇到什麼情況可以使用它,以及這項工作應該怎麼完成。複雜一點的 Skill,還可以搭配腳本、參考文件和其他資源。
例如,你可以自己寫一個專案 Skill,要求 AI 每次修改程式碼後,都要依照指定流程執行測試、檢查安全問題,再整理結果給你。
當然也可以使用別人已經寫好的 Skill,這就是我今天真正想提醒的事情。
你安裝的那些 Plugin 和 Skill,有沒有打開來看過?
我們可以先從來源來看:有些是 Anthropic 提供的,有些是社群或第三方開發者分享的,還有一些是我們自己為專案建立的。而且 Skill 也能安裝在個人目錄、專案目錄,或透過 Plugin 分發
官方來源可以降低部分來源不明的風險,但不代表安裝後就保證絕對安全。
第三方提供的東西,更應該先確認作者、程式碼內容,以及它到底需要哪些權限。
因為 Skill 不一定只有文字。它可能附帶腳本,甚至透過其他擴充元件使用工具、連線到外部服務。
假設你下載了一個號稱可以加速部署的 Skill,裡面卻要求 AI「遇到權限問題就改用 root 執行」,或「部署時直接覆蓋原本的檔案,不需要備份」。
這些指引就可能跟你前面辛辛苦苦訂下的安全規範互相衝突。
而且,Plugin 裡面如果包含 Hook 或 MCP Server,還可能在特定事件發生時執行程式,或提供額外的工具能力。風險就不只是 AI 會不會聽從某段文字而已。
所以我認為,這跟前面講第三方套件的原則一樣:
用別人的可以,但要知道自己裝了什麼。
安裝前先確認來源,看看 SKILL.md 寫了什麼,有沒有附帶腳本、會不會存取專案檔案、需要哪些權限,以及是否會連線到外部服務。
如果是重要專案,也應該記錄使用的版本,更新前重新檢查,而不是假設作者後來修改的內容一定安全。
你花了好幾天確認需求、盤點威脅,再一條一條整理出 CLAUDE.md 的安全紅線。
結果最後安裝了一個根本沒看過內容的 Plugin,反而讓它取得原本不打算開放的能力。
那前面做的一堆努力,不就白費了?
講完輸入,現在來講輸出。除了傳統 SBOM,最近也開始有越來越多人討論 AI SBOM。
傳統的 SBOM 是什麼?
簡單來說,就是記錄軟體包含哪些元件、使用哪些套件與版本,讓我們後續可以追蹤漏洞與相關風險。
但 Vibe Coding 做出來的東西,光記錄套件就夠了嗎?
會影響程式開發結果的,不只有程式碼和第三方套件。
你用了哪個 AI Model?安裝過哪些 Skill 和 Plugin?CLAUDE.md 訂了什麼規矩?settings.json 開放了哪些權限?最後又經過哪些測試和人工審查?
如果這些事情都沒有記錄,明天有人問你:
「這個系統是怎麼做出來的?AI 照什麼規則寫的?用了哪些套件?有沒有經過驗證?」
你該怎麼回答?「不知道,AI 幫我做的」?
如果連自己交出去的系統是怎麼做出來的、經過哪些驗證都說不清楚,那我們真的能把責任全部推給 AI 嗎?
其實,業界已經開始處理 AI 供應鏈的透明度問題。
例如 SPDX 3.0 有 AI and Dataset Profile,CycloneDX 也有 ML-BOM,可以描述 AI 模型、資料集及相關元件。
不過,這裡也要稍微區分一下。
這些標準主要處理的是 AI 系統本身的組成,跟我們使用 AI 協助開發一般軟體,並不是完全相同的情境。不能因為使用 Claude Code 寫了一個網頁,就直接把整個開發過程都當成標準 AI BOM 的內容。
所以,對我們這種使用 Vibe Coding 開發工具的人來說,
我覺得除了傳統 SBOM,可以建立一份 AI 開發履歷。
不用一開始就搞得很複雜,至少把使用的 AI 工具與模型、重要的 Skill 和 Plugin、專案規則版本,以及人工審查與測試結果記錄下來。
至於「AI 產生的程式碼占整個專案多少比例」,我反而不建議把它當成主要指標。
因為程式碼可能經過 AI 與人工反覆修改,很難準確區分。
比起追求一個不一定算得準的百分比,更需要在意的是
最後是誰確認、怎麼測試,以及有沒有留下證據。
回頭看了一下,一路走到 Day 29,我才發現,原來我想跟大家分享的,並不只是怎麼利用 AI 把整個專案的程式寫出來。
而是當 AI 讓開發變得越來越容易,我們該怎麼知道自己用了什麼、AI 做了什麼,以及最後交出去的東西到底有沒有經過驗證。
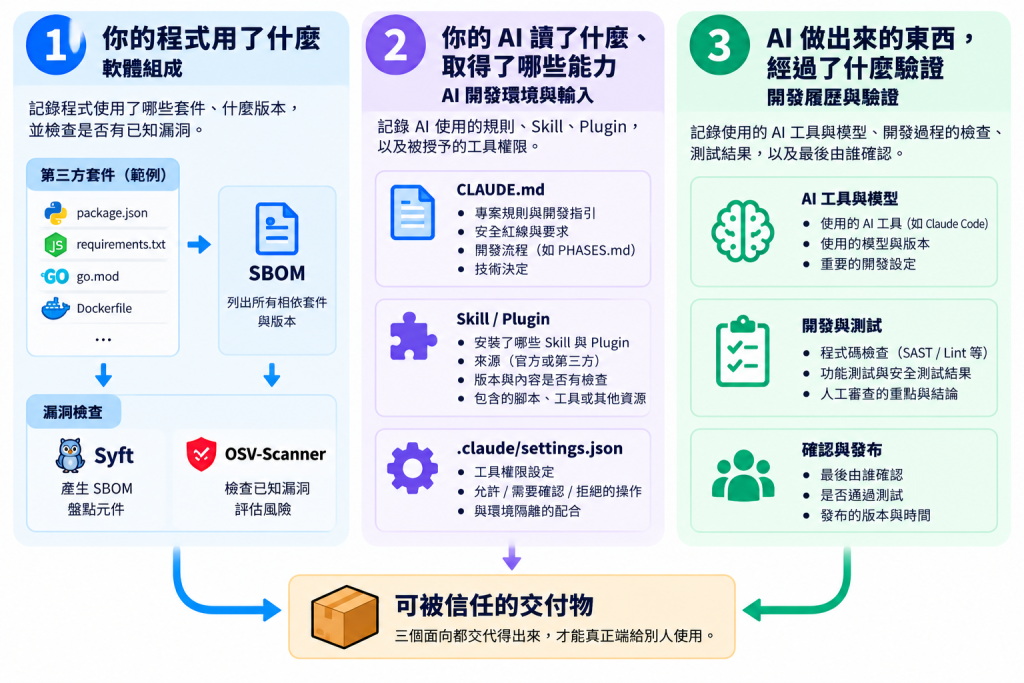
這三個面向不完全等於三層供應鏈,但合在一起,就是我認為 Vibe Coding 專案應該留下的基本紀錄。
我不認為每個使用 Vibe Coding 的人,都必須先成為程式設計師或資安專家,才能開始動手做工具。
但當你打算把自己做出來的東西交給別人使用,至少應該知道裡面有什麼、可能有什麼風險,以及出了問題該怎麼追查。
畢竟,做得出來是一回事,能不能清楚交代它是怎麼做出來的,又是另一回事。


 iThome鐵人賽
 看影片追技術