
昨天講到掃描:掃什麼、用什麼工具、結果怎麼分成 Pass / Review / Block。
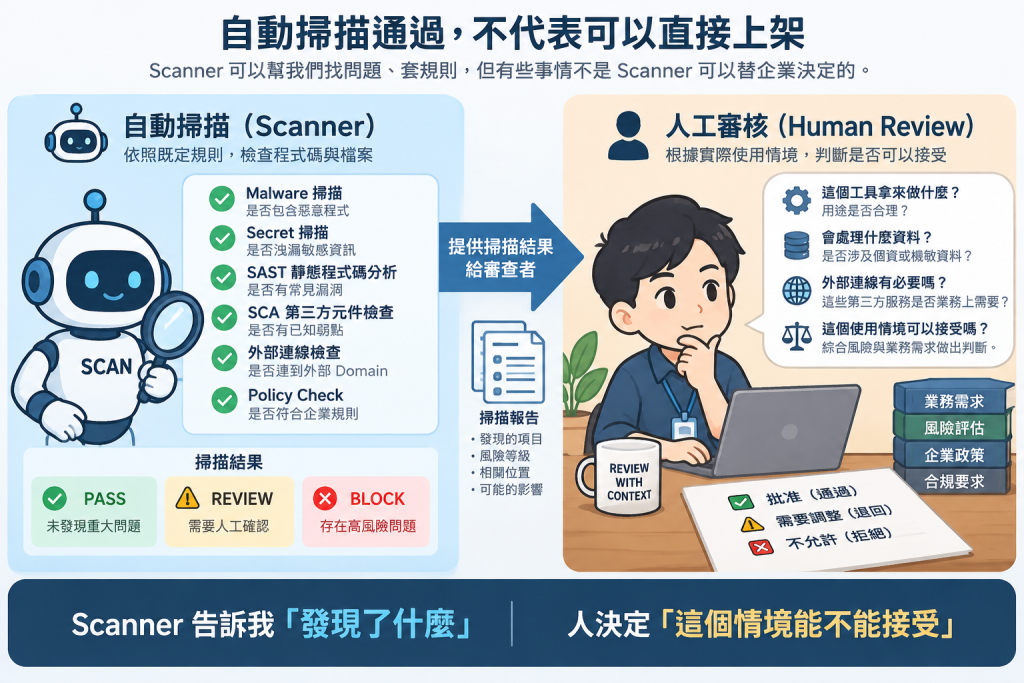
但自動掃描通過,不代表所有東西都可以直接上架。
因為 Scanner 可以幫我們找問題、套規則,但有些事情不是 Scanner 可以替企業決定的。
所以今天進入 Phase 6:送審與人工審核。
原本開發計畫只有寫審核但展開後裡面大概是這些:
→ 建立送審功能
→ 定義審核狀態
→ 建立審核畫面
→ 控制誰具有審核權限
→ 實作通過
→ 實作退回
→ 實作退回後修改
→ 實作重新送審
→ 防止申請人自己審核自己的案件
→ 防止使用者直接修改狀態跳過審核
→ 建立多階層審核流程
乍看之下好像就是做幾顆「送審」、「核准」、「退回」按鈕。
但真的開始拆,就會發現這一段真正麻煩的不是按鈕怎麼做,而是:
誰可以決定?什麼情況可以決定?決定之後可以往哪裡走?
Scanner 能判斷的是「有沒有命中規則」。
它看得出這個 HTML 從外部 CDN 載入東西、程式裡用了 innerHTML、有哪些外部連線,也可以依照我們昨天定義的 Policy 判斷哪些項目需要 Block、哪些需要 Review。
但它一定不知道: 「這個工具到底是拿來幹嘛的?」
同樣是一個外部 API,可能是業務上必要的服務,也可能根本不應該連;同樣使用 localStorage,裡面可能只放介面設定,也可能有人拿來存不該放在瀏覽器裡的資料。
例如 Scanner 的結果是 Review:使用了一個第三方 CDN,也有一段 innerHTML。
這兩件事情本身不代表一定有漏洞,但如果這只是一個算加班費的小工具,跟一個會處理個人資料的表單,我要確認的事情顯然不會一樣。
所以 Scanner 可以告訴我:
「我發現了什麼。」
但有些事情還是需要人根據實際用途回答:
「在這個使用情境下,這件事情可不可以接受?」
而且還有責任的問題。前面講過,真的出事時,我們必須能回頭知道:「當初是依據什麼資訊、由誰做出放行決定?」
Scanner 可以提供判斷依據,但最後的決策與責任,不能全部丟給 Scanner。
講到人工審核,很容易讓人想到另一個極端:
「所以 Scanner 掃完,最後還是要找一個人把所有程式碼重新看一次?」
如果是這樣,那前面做那麼多自動化也沒什麼意義。
我的想法不是讓人工重新做一次 Scanner 做過的事情,而是讓 Scanner 先把能自動處理的東西整理好。
Malware、Secret、SAST、SCA、SBOM、外部連線、Policy Check,這些先跑完,再把真正需要人判斷的 Review Finding 整理出來。
審查員看到的不應該只是一包 ZIP,而是一份已經整理好的資料,例如:
甚至 Scanner 如果發現 innerHTML,可以直接告訴審查者:
哪個檔案、哪個位置、發現什麼、為什麼值得注意。
審查的人真正要做的,是針對這些資訊判斷:
「這個情境可不可以接受?」
我要減少的是人工找資料、整理資料的時間,而不是把真正需要負責的判斷一起拿掉。
再來是我覺得很容易被忽略的地方。
審核流程不是做三顆: 送審|核准|退回 就結束了。
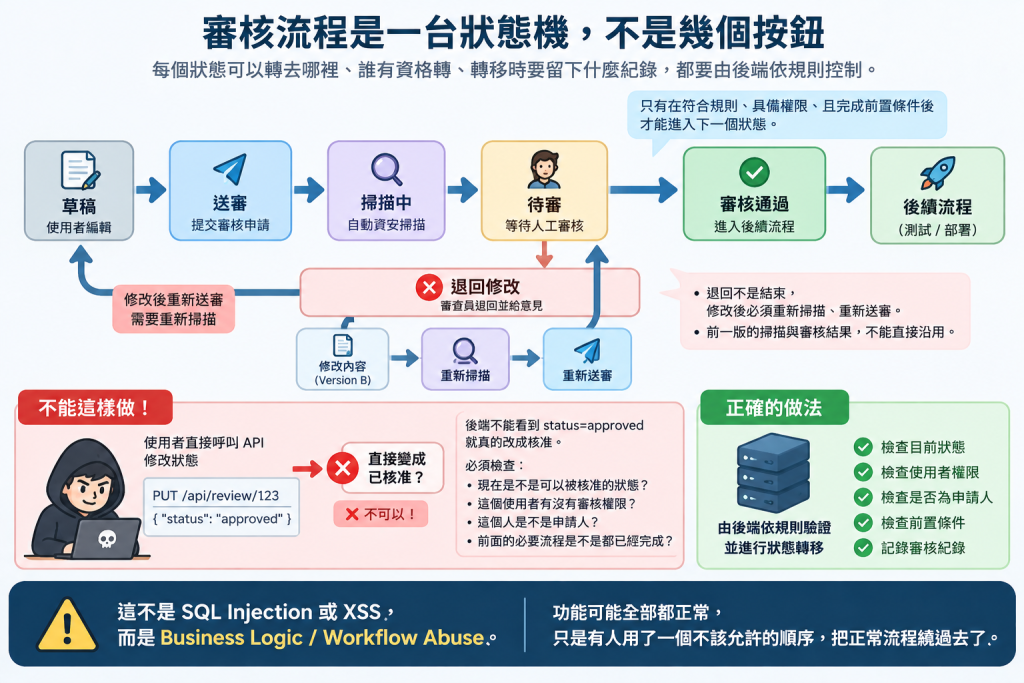
它其實比較像一台 State Machine(狀態機)。
概念上可能是:草稿 → 送審 → 掃描中 → 待審 → 通過/退回 → 後續流程
如果被退回,修改之後又會重新進入:退回 → 修改 → 重新掃描 → 重新送審 → 待審
每個狀態可以轉去哪裡、誰有資格讓它轉、轉移的時候要留下什麼紀錄,都要先定義清楚。
而且這些規則一定要由後端控制。
假設前端送出:
status=approved
後端不能看到 approved 就真的把資料庫改成核准。
它應該先確認:
現在是不是可以被核准的狀態?
這個使用者有沒有審核權限?
這個人是不是這件案子的申請人?
前面的必要流程是不是都已經完成?
全部符合,才允許狀態轉移。
不然使用者只要自己呼叫 API,把 status 改成 approved,整套審核流程就只剩畫面上的幾顆按鈕。
這種問題跟 SQL Injection、XSS 不太一樣。
功能可能全部都正常,只是有人用了一個原本不應該允許的順序,把正常流程繞過去了。
這就是 Business Logic / Workflow Abuse 這類問題。
前面 Day 10 已經談過風險分級,所以到了這裡,我不會讓所有工具全部走完全相同的審核流程。
不然一個完全不碰資料的小計算機,跟一個會處理機敏資料的工具走一樣的流程,最後大家只會覺得這個平台很麻煩。
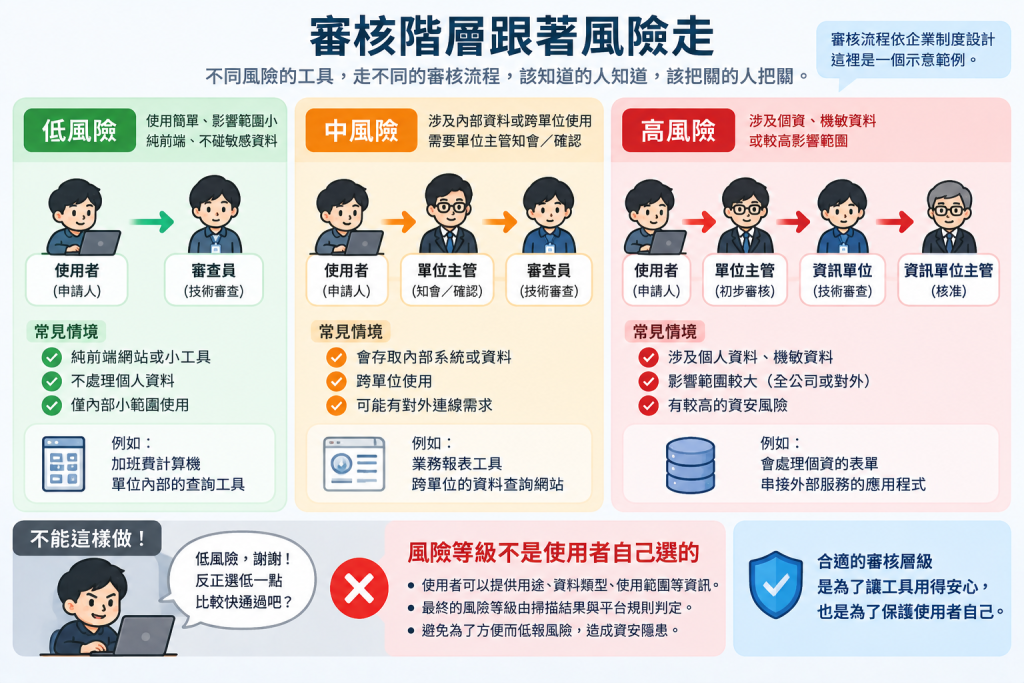
所以我的想法是讓審核階層跟著風險走。
低風險:使用者 → 審查員
例如純前端、不碰敏感資料、使用範圍很小的工具,由審查員確認後進入下一階段。
中風險:使用者 → 單位主管知會/確認 → 審查員
如果開始碰內部資料、跨單位使用,除了技術審查之外,原單位主管也應該知道這個工具的存在與用途。
高風險:使用者 → 單位主管 → 資訊單位審核 → 資訊單位主管核准
如果涉及個資、機敏資料或較高影響範圍,就增加必要的審核層級。
實際要分幾級、每一級由誰審,當然還是要依企業自己的治理制度決定。
但有一個原則應該要先定下來:
使用者可以提供風險判斷需要的資料,但不能自己決定最後的風險等級。
使用者可以告訴平台:「我的工具會不會處理資料、使用範圍多大、會不會連外、給哪些人使用。」
再搭配前面的掃描結果與平台規則決定最後走哪一條審核流程。
不然如果風險等級直接讓使用者自己選,我猜最後大家都會很有默契:
「 低風險,謝謝 」
接下來還有一個很重要的問題: 誰可以審?
最基本的規則就是: 申請人不能審自己的案子。
不然整套流程會變成: 我做的 → 我送的 → 我審的 → 我核准的。
看起來每一關都有走,實際上還是同一個人在做決定。
這就是 Separation of Duties(職責分離) 的概念,也是 ISO 27001 控制措施中會關注的方向。目的不是為了多設一關,而是避免同一個人同時具有申請與核准的權力。
所以不能只做: 「有 Reviewer Role → 顯示核准按鈕」
後端在真正執行核准時,還要再確認: Reviewer ≠ Submitter
這種規則我會直接寫進專案需求與開發規則裡,而不是期待 AI 每次都會主動想到。
因為 AI 很可能把「Reviewer 可以核准案件」這個功能做得完全正確,但如果需求沒有講清楚,它未必會替我補上一條:
「Reviewer 不能核准自己送的案件。」
這也是我一直強調需求跟規則要先寫清楚的原因。
接下來是版本問題。
假設審查員今天看到的是 Version A,Scanner 掃的也是 Version A,最後審查員核准 Version A。
那最後進入後續流程的,就應該是 Version A。
不能核准完之後,申請人偷偷把 JavaScript 換掉,畫面還繼續顯示:
「已核准。」
所以只要內容修改,就應該產生新的版本。
例如: Version A → 掃描 → 審核 → 通過
後來修改內容: Version B → 重新掃描 → 重新審核
Version A 的掃描與核准結果,不能直接套到 Version B。
系統實作上,可以利用版本 ID 搭配 SHA-256 Hash,把掃描結果與核准紀錄綁定到實際檔案內容。後續真正使用這個版本時,也能確認目前的 Artifact 跟當初被掃描、被核准的是同一份內容。
這裡真正重要的其實只有一句: 通過的是「這一版」,不是這個工具從此取得永久通行證。
既然開始有人做決定,就一定會產生紀錄。
例如:
誰送審的?
什麼時候送審?
送的是哪一版?
當時 Scanner 的結果是什麼?
有哪些 Review Finding?
誰審核?
什麼時間審核?
最後是通過還是退回?
審查員留下什麼意見?
這些東西都應該被保留下來。
而且原始的審核紀錄不能被直接覆寫。
假設審查員昨天寫:
「確認用途後,同意使用。」
今天發現自己寫錯了,不應該直接把昨天那筆紀錄 UPDATE 成另外一句,讓原本發生過的事情消失。
比較合理的方式是再新增一筆更正或補充紀錄,讓前後變化都留得下來。
因為真的發生問題時,我想知道的不是: 「系統現在顯示什麼?」
而是: 「當時到底發生了什麼?」
這些紀錄之後也會成為整個平台 Audit Trail 的一部分。
跟前面一樣,功能做完之後,我不會只測正常流程:
送審 → 審核 → 通過
這條一定可以跑。
我反而會開始故意做一些不應該成功的事情:
status 變成 Approved?因為這一階段真正要測的,已經不只是: 「按鈕按下去有沒有反應?」
而是: 「不該走的路,到底走不走得通?」
這裡主要想避免的就是 Broken Access Control、Workflow Bypass、Business Logic Abuse,以及審核狀態與實際版本對不起來等問題。
Phase 5 的 Scanner 回答的是: 「這個檔案有沒有命中我們設定的規則?」
Phase 6 的人工審核回答的則是: 「根據這些資訊與實際使用情境,我們要不要允許它繼續往下走?」
所以人工審核不是把 Scanner 做過的事情重新做一次。
Scanner 負責把 Malware、Secret、SAST、SCA、外部連線、Policy Check 等資訊整理出來;人負責處理那些需要情境、權限、用途與風險判斷的事情。
而審核流程本身,也不是幾顆「送審、核准、退回」按鈕。
它背後其實還有:
狀態、風險分級、審核階層、職責分離、版本綁定、Audit Trail。
這些規則都不能只期待 AI 自己補齊,是要在需求與規則裡先定義清楚,再讓 AI 幫我把它實作出來。
做到這裡,這個工具已經走完:
上傳 → 自動掃描 → 人工審核
但「審核通過」仍然不代表可以直接丟進正式環境。
因為到目前為止,我們花了很多時間回答:
「它能不能被允許?」
還有另一個問題沒有真正回答:
「通過之後,使用者要在哪裡看到它?它跑起來之後,會不會影響到平台本身?」


 iThome鐵人賽
 看影片追技術