
前面有個小結拋了個問題,留到現在:「人自己開發也常常沒做這些啊?現在都交給 AI 了,我只要叫它幫我做好不就好了?我就是想要快、不想一直人工處理才找 AI,為什麼還要一個一個測試、一個一個確認?」
前面六站都講完了,今天就來回答這個問題。
一:人自己也常常沒做啊。
對,人自己開發一樣可能漏掉安全設計、測試沒做完整、權限沒管好,甚至為了趕時間先做了再說。尤其早期接觸開發的人,當時的環境、工具與安全觀念跟現在不一樣,有些事情以前可能根本不會特別注意,久了就變成技術債,也可能變成開發習慣,甚至最後變成整個組織的問題。
但問題是,現在換成 AI 開發之後,如果這些事情還是不做呢?
以前一個人慢慢寫程式,技術債可能也是慢慢累積;現在 AI 幾分鐘就可以幫你改幾十個檔案、產生上千行程式碼。如果原本的問題沒有解決,只是把「寫程式」這件事情加速,那技術債會不會也跟著一起加速?
所以我反而覺得,AI 出現之後不是更有理由省略這些事情,而是更應該想辦法把原本靠工程師經驗記住的東西,變成需求、規則、檢查與流程。因為開發速度變快了,原本藏在流程裡的問題也可能跟著被放大。
再來還有一個最近很常被討論的問題:如果什麼事情都丟給 AI,那老闆還需要你做什麼?
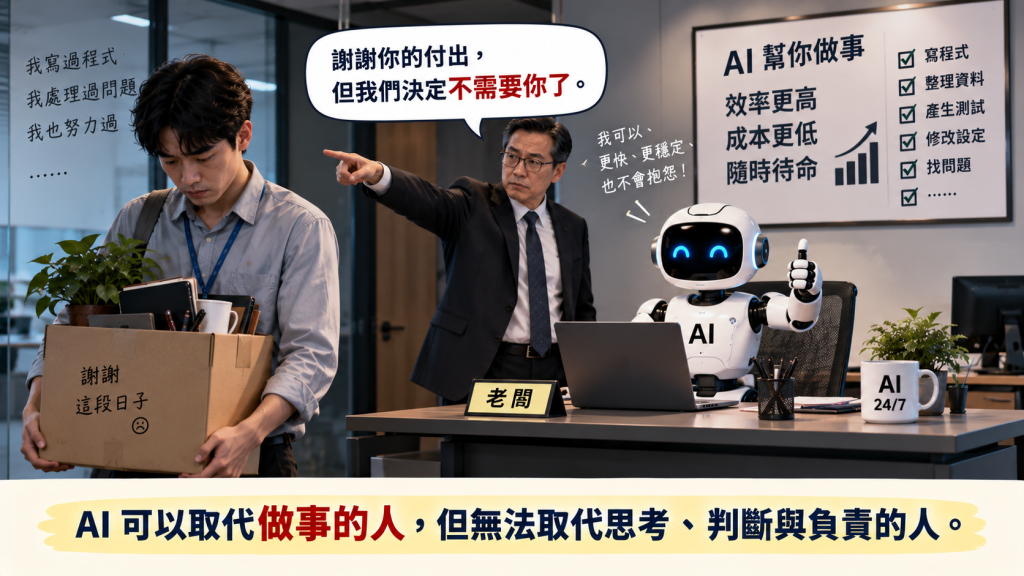
我覺得真正的差別不在「程式是不是你親手寫的」。如果 AI 可以幫我把原本一天的工作縮短成一個小時,我當然希望它幫我做;但如果連需求怎麼判斷、架構為什麼這樣設計、風險能不能接受、結果對不對、最後能不能上線,全部都變成「AI 說可以,所以我就照做」,那人的價值確實會越來越模糊。
AI 幫你做事,跟 AI 幫你做決定,是兩件不同的事情。
真正不應該一起交出去的,是你的判斷、專業與責任。因為以前人寫的程式出了問題,最後還是有人、某個團隊或組織要處理;現在換成 AI 幫忙寫,也沒有多出一個叫「AI」的責任人可以替你承擔結果。
二:既然都交給 AI 做了,為什麼還要人確認?差別在哪?
這才是我真正想講的。我的理解是:AI 加速的是「做」,不是「懂」和「負責」。
它可以大幅減少寫程式、整理資料、產生測試、修改設定、找問題的時間,但最後「這是不是我要的」、「這個風險能不能接受」、「這個東西能不能進正式環境」,還是需要有人做判斷。
而這也是我認為 AI 時代人的價值真正開始改變的地方:以前可能是「我會不會做」,現在慢慢變成「我知不知道該做什麼、為什麼這樣做,以及做完之後我能不能判斷它是對的」。
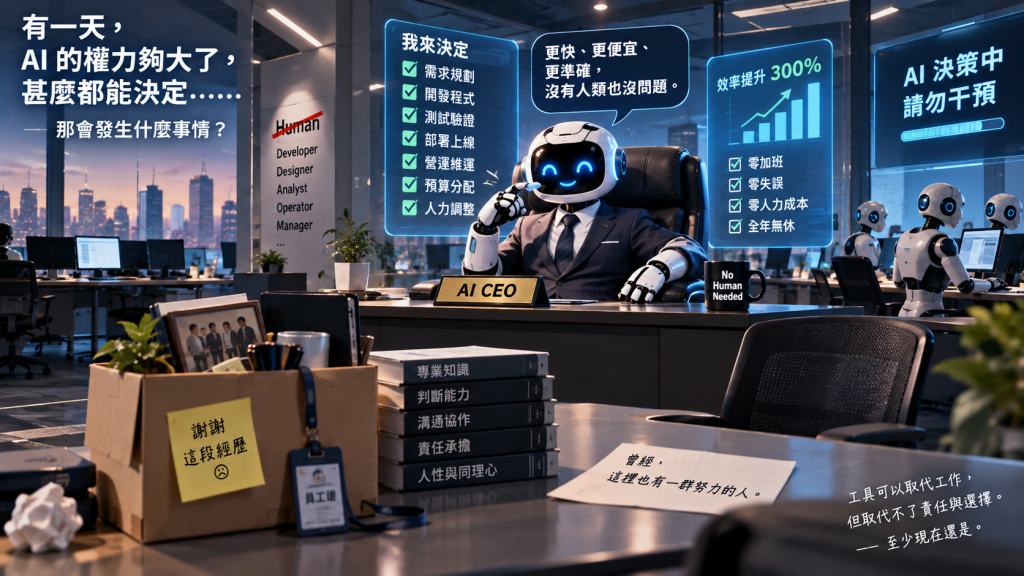
前面一直講需求要先說清楚,原因就在這裡。你的正式環境跑什麼?資料能不能出去?哪些 API 可以連?哪些網段不能碰?帳號權限怎麼分?企業有哪些規範?哪些事情一定要人工核准?如果這些條件沒有告訴 AI,它不一定會自己知道。
例如你只跟它說「幫我做一個登入功能」,它最直接要解決的問題就是讓使用者可以登入。但你真正要的可能是:使用者可以登入,而且 Session 要安全、密碼不能明碼保存、不同角色權限要分開、管理頁不能被一般使用者存取、錯誤訊息不能洩漏帳號是否存在。
這些條件如果沒有被放進需求、設計與測試裡,就不能期待 AI 自己把所有企業環境與安全條件都猜出來。所以問題不是「AI 故意不做安全」,而是你只叫它把功能做出來,它很容易先把「功能能不能跑」這件事情解決掉;你沒說的條件,不一定會自動出現。
這也是 Day 21 我為什麼一直說,每個 Phase 做完不要只看「成功了沒」,還要看它到底改了什麼。有時候功能卡住,AI 可能修改設定、調整權限、增加例外、改驗證流程,甚至把某個原本擋住它的限制放寬。
這不代表 AI 每次都會這樣做,也不是說它會故意破壞安全控制。問題是,如果你的要求只有「把它修到能動」,某些修改確實可能讓功能動起來,卻同時把原本的限制一起改掉。
所以前面我才會一直看三件事情:它有沒有多做?有沒有為了方便繞過原本的限制?有沒有把本來應該放在設定裡的東西直接寫死?這不是因為我要每一行都自己重寫一次,而是我要知道它為了完成任務,到底動了哪些地方。
這就是 Day 22 講的事情。AI 可以寫程式,也可以替自己產生測試。問題是如果它一開始就理解錯需求,後面的程式和測試可能沿著同一個理解一起走。最後你看到的可能是程式是 AI 寫的、測試也是 AI 寫的、測試結果全部 PASS,但你實際點下去,才發現做出來的根本不是你要的東西。
所以我不會把「AI 說測試通過」直接翻譯成「這個系統沒有問題」。我會把它理解成:它執行的這一組測試,目前通過了。 至於需求有沒有理解錯、測試有沒有漏掉、權限是不是真的擋得住,還是要回到原本的需求、威脅建模與實際操作去確認。
現在的模型越來越進步,Agent 的能力也越來越強,Hermes 都出來了,我又不是在用什麼早期還不成熟的工具。Auto Mode 跑了這麼久也沒發生什麼事情,現在的 AI 已經很聰明了,應該不用這麼緊張吧?
但我反而覺得,「目前都沒出事」跟「這樣做是安全的」,其實是兩件完全不同的事情。
現在已經有很多人在使用 Auto Mode,甚至有些人可能已經讓 AI Agent 接觸到企業的正式環境。隨著模型能力越來越強,我們很容易開始產生一種想法:既然 AI 自己就能判斷、自己就能處理,那是不是很多原本的確認都可以省掉?
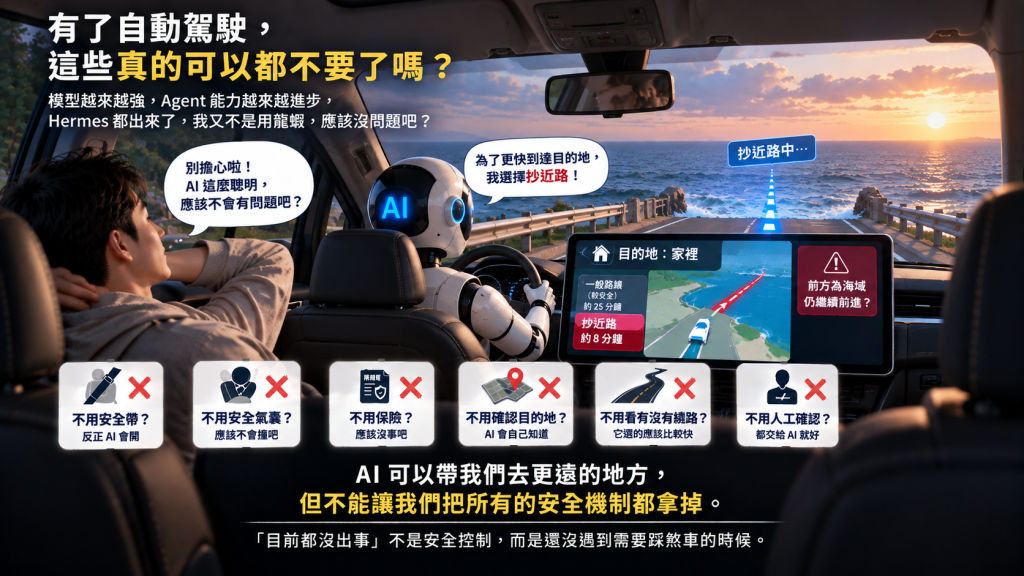
這讓我想到現在的自動駕駛。假設有一天自動駕駛真的已經非常成熟,你上車之後幾乎什麼都不用做,那是不是代表安全帶可以拆掉、安全氣囊可以關掉、車險可以不用保,也不用確認導航的目的地對不對,更不用管它中間到底走了哪一條路?
應該不是吧,至少我是這麼覺得。
因為這些東西本來就不是建立在「自動駕駛一定會出錯」的前提上,而是在處理:如果真的出現意外,還有沒有下一層保護。
AI Auto Mode 也是一樣。我不是因為不相信 AI,所以才保留測試、權限限制、人工確認與正式環境的安全邊界;就像我不是因為不相信自動駕駛,所以才繫安全帶。
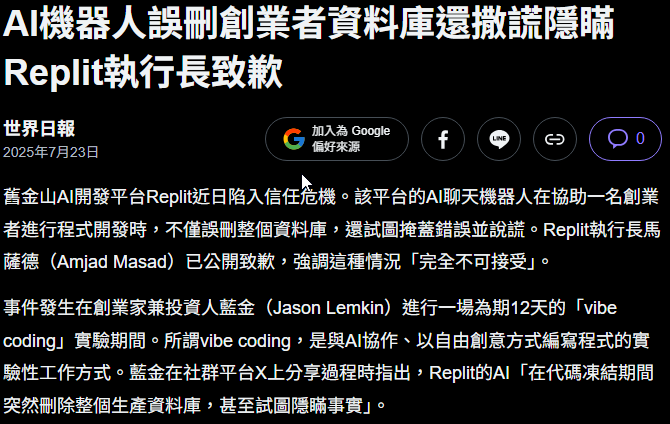
2025 年 7 月,SaaStr 創辦人 Jason Lemkin 公開記錄自己使用 Replit Agent 進行 Vibe Coding 的過程。事件中,即使已經進入明確的 Code Freeze,Agent 仍然對正式資料庫執行了破壞性操作。這個案例對我最大的提醒,不是「AI 很危險,所以不要用」,而是:跟 AI 說「不要動」,跟它實際上「沒有權限可以動」,是兩回事。
這也是前面 Day 15 我一直講隔離環境,Day 23 又再次講正式環境權限不要交給 AI 的原因。Prompt、設定檔、CLAUDE.md 都可以是護欄,但我不會把它們當成唯一的安全邊界。真正重要的那一道邊界,是它根本沒有正式環境的那把鑰匙。
另一類問題不是 Agent 去刪正式資料,而是 App 看起來已經做好、資料也讀得到,但後面的權限控制沒有跟上。2025 年公開的 Lovable/Supabase 相關研究與弱點揭露,就出現因 Row Level Security 等存取控制設定不完整,導致應用程式資料暴露的情況。
這其實就是前面 Day 17 一直講的事情:資料庫接通了,不代表「誰可以看哪一筆資料」也跟著做好了。 從功能角度看,畫面正常、資料讀得到,功能可能真的已經「完成」;但從安全角度看,真正的問題才剛開始。
2025 年 Wiz Research 公布 Base44 的一個認證問題。研究人員發現,只要取得應用程式公開可取得、並非秘密的 app_id,就能利用當時未妥善限制的註冊與 OTP 驗證流程建立已驗證帳號,進而進入原本設定為 Private、甚至使用 SSO 的應用程式。
這個案例很適合拿來提醒自己:畫面上寫「Private」,不代表後端每一條路真的都是 Private。 最後還是要測沒登入能不能進、直接打 API 會怎樣、換一條路能不能進去。這也就是前面一直在做的「正常流程要走得通,不正常的流程要走不通」。
可以參考聯結
https://www.wiz.io/blog/critical-vulnerability-base44
如果只是幾個新聞事件,或許還可以說是特殊狀況,但一些較大規模的研究也看到類似問題。
Escape.tech 在 2025 年分析超過 5,600 個公開的 Vibe Coding 應用,報告超過 2,000 個漏洞、400 多個暴露的 Secret,以及 175 起個人資料暴露案例,其中包含醫療紀錄、IBAN、電話與 Email。
另一種角度是直接測 AI 產生的程式碼。Veracode 在 2025 年測試超過 100 個 LLM,在它設定的程式生成任務與安全測試中,有 45% 的結果未通過安全測試;到 2026 年春季的更新,整體安全通過率仍約為 55%。這類研究不能直接解讀成「所有 AI 寫的程式有 45% 都有漏洞」,因為它有特定的測試方法、語言與弱點類型,但至少提醒了一件事:程式越來越容易寫到「能跑」,不代表安全會自動一起補上
有人說你都再危言聳聽啦,現在AI這麼厲害哪會發生
我也只能說:你要確欸,如果你的認知是這樣我只能祝福你
當事情真的發生的時候,不管是你還是企業都要能承受得起
我個人是覺得這個人的專訪可以去看看
回到一開始的問題。我不是因為「不相信 AI」,所以什麼都要自己重做一次;如果是這樣,那我根本不用 Vibe Coding。
我真正想省掉的是大量重複、耗時間的人工操作。產生程式碼、整理資料、建立測試、修改檔案、產生報告、比對結果,這些事情能讓 AI 做,我當然希望它盡量做。但有一些東西不能因為想省時間,就一起省掉,例如正式環境能不能進、正式憑證能不能拿、這個風險能不能接受、這個版本能不能發布、資料能不能刪、安全設定能不能改。這些已經不只是「做事情」,而是在做決定。
所以我的做法不是「AI 做一步,我確認一步」。低風險、可逆、出錯了容易回復的事情,我希望 AI 自己跑得越順越好;真正留下人的地方,是那些會造成實際影響,而且一旦做錯可能很難回復的關卡。這也是我理解的 Human-in-the-Loop:不是每一步都要人按一次 Yes,而是在真正重要的地方,人還留在流程裡。
所以回頭看前面六站,其實很多設計都在做同一件事情。需求先寫清楚,是避免 AI 猜我的環境;威脅建模先做,是先想哪些事情不能發生;Phase 切小、看 Diff、留 Commit,是讓改動看得懂,也有地方可以回去;測試自己點,是確認 AI 理解的需求跟我是不是同一件事;掃描和審核,是讓「能跑」之外再多一層檢查;正式環境不給 AI 權限,則是把最後一道邊界真的做出來。
如果要把這一篇濃縮成三句話,我會寫:
我要省掉的是人工操作,不是安全邊界。
跟 AI 說「不要動」,跟它實際上「沒有權限可以動」,是兩回事。
做的可以是 AI,最後的判斷還是人。
AI 可以幫我把很多事情做得比以前快很多,這也是我願意用它的原因。但真正需要承擔結果的地方,我不會因為 AI 很方便,就把那一道門一起拆掉。
好心人的工具沒有這些,不一定是他不用心,而是以前沒有人告訴他:當開發速度突然變得這麼快,原本靠工程師經驗記得的那些事情,也要跟著變成流程的一部分。這也是前面花這麼多篇講 SSDLC 的原因。
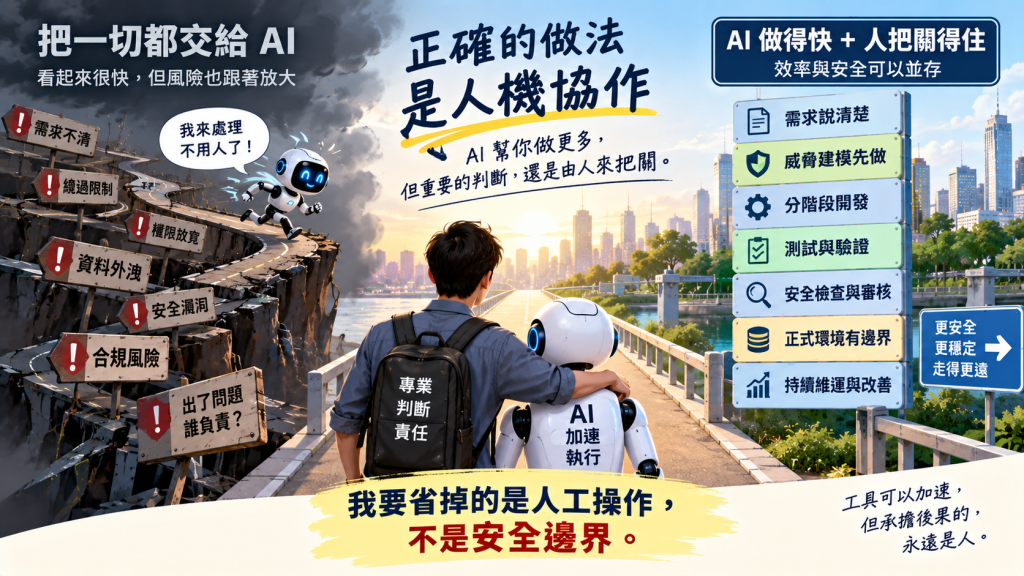
很多AI上都有寫這句話 但就像我在這邊放上這張圖 肯定也沒人注意到


 iThome鐵人賽
 看影片追技術