
前面講了開發:Phase 怎麼切、每個 Phase 要注意什麼、做完怎麼看、為什麼要 Commit。到這裡,功能看起來做完了,AI 也可能告訴你測試全部通過。
但「功能做完」跟「真的測過」,其實還是兩回事。
今天就來講下一站:測試。
當然還沒。
AI 很會寫測試,也會自己跑測試,最後很開心地跟你說:「所有測試皆已通過。」
但這句話真正代表的,其實只是:「它寫的這些測試,現在都通過了。」 不代表你的需求全部被測到了,也不代表它從一開始就正確理解你的需求。
例如:表單送出去之後到底存到哪裡?審核退回之後狀態真的正確嗎?退回修改再重新送審,流程還走得下去嗎?兩個人同時操作會發生什麼事?一般使用者真的進不了管理功能嗎?改掉網址裡的 ID,真的拿不到別人的資料嗎?掃描服務掛掉之後,系統真的會停下來嗎?核准之後偷偷換檔案,原本的核准會不會還存在?
這些情境,AI 自己產生的測試不一定全部有涵蓋。甚至還有一個更根本的問題:如果 AI 從一開始就理解錯你的需求,它甚至可能替自己理解錯的功能,寫出一套全部通過的測試。
最後就會出現一個很好笑的狀況:
測試全部通過,但做出來的根本不是我要的。
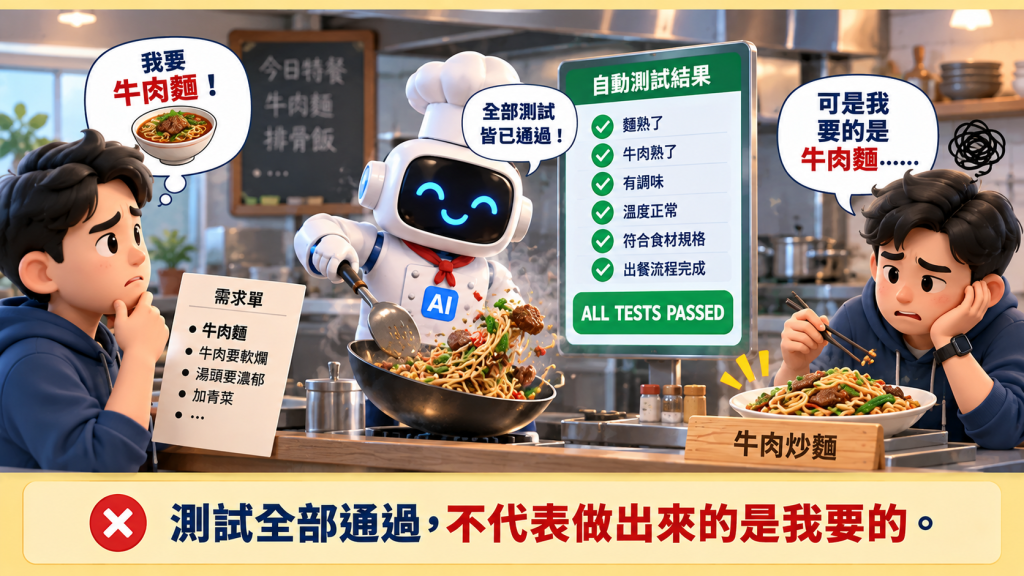
功能做完之後,我還是會人工實際操作。不是只看 AI 給我的測試報告,而是真的把自己當成使用者,從頭走一次:
登入 → 上傳 → 掃描 → 送審 → 退回 → 修改 → 再送 → 通過 → 發布 → 查看結果
而且不能只用一種身分測。一般使用者走一次,開發者走一次,審核人員走一次,管理者再走一次。不同角色本來就應該有不同的權限,如果永遠只拿管理者帳號測,很容易得到一個「什麼都可以正常操作」的結果。
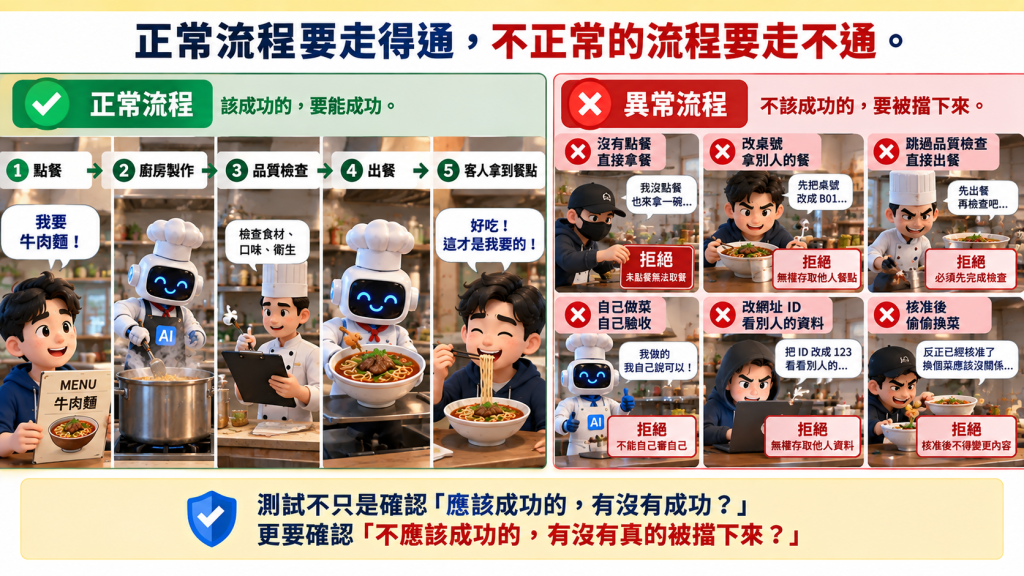
但這還不夠。正常流程走完之後,我還會故意做一些**「不應該成功」**的事情。
例如沒登入直接打網址、一般使用者直接進 /admin、直接呼叫管理 API、修改 ID 看別人的資料、跳過掃描、跳過主管、自己審自己,甚至核准之後偷偷修改內容。
因為測試不只是確認:
「應該成功的,有沒有成功?」
還要確認:
「不應該成功的,有沒有真的被擋下來?」
換句話說:
正常流程要走得通,不正常的流程要走不通。
我目前自己的經驗是,AI 跟我說「全部測試通過」的東西,人工實際點一遍,還是很常找到 Bug。有時候甚至不是 Bug,而是做出來的東西根本不是我要的。
這時候回去問 AI,它通常也很乾脆:「抱歉,我漏掉了。」「抱歉,我沒有注意到這個情境。」
開發階段看到這句話其實沒什麼,找到問題、修掉就好。但如果正式上線之後真的出現漏洞、權限錯誤,甚至造成資料外洩,就不能再用一句「AI 沒注意到」當成理由。
工具可以協助你開發、協助你測試,但最後決定這個東西能不能上線的人,還是要負責。
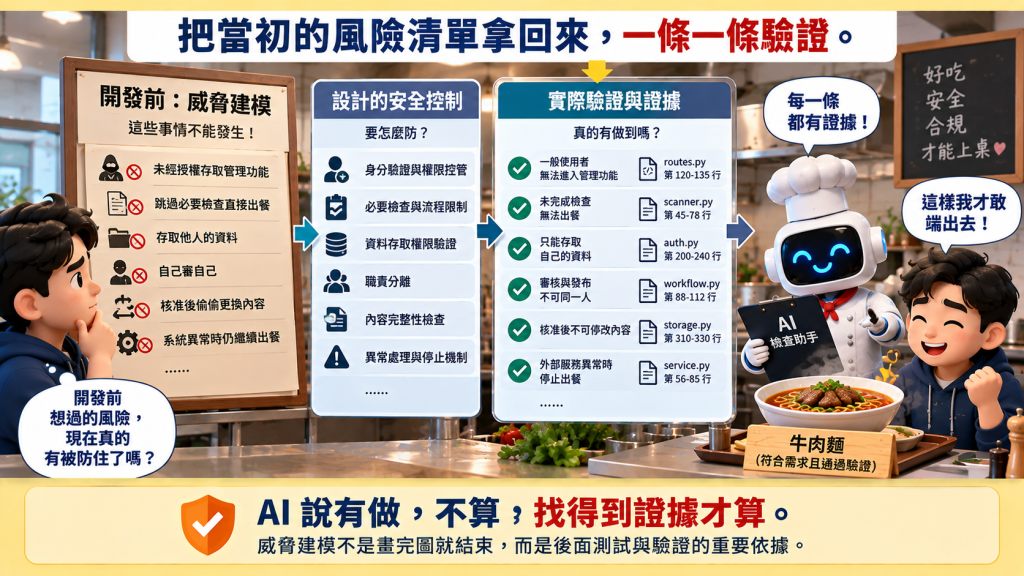
還記得前面做過的威脅建模嗎?現在就派上用場了。
當初我們列了有哪些資產、有哪些信任邊界、可能有哪些威脅,以及哪些事情絕對不能發生。這些東西不是畫完圖、寫完文件就丟掉。到了測試階段,把它重新拿出來,一條一條對:
當初說要防的,現在真的防了嗎?
當初說不能做的,現在有沒有辦法做到?
原本設計的安全控制,實際程式裡真的存在嗎?
其實威脅建模不只是開發前拿來想風險,它也可以變成後面測試案例的重要來源。
例如當初寫了「一般使用者不得存取管理功能」,現在就真的拿一般使用者去打 /admin、呼叫管理 API。當初寫了「未完成掃描不得送審」,現在就真的想辦法跳過掃描,看看後端到底會不會擋。當初寫了「使用者只能讀取自己的資料」,現在就真的把 ID 改成別人的,看看資料會不會跑出來。
威脅建模裡寫的不是願望,而是最後要回來驗證的東西。
這時候 AI 還是很好用。
我可以把前面的威脅、安全要求和測試結果重新交給 AI,要求它逐條對照目前的程式。但我不會只問:「這些安全控制都有做嗎?」因為它很可能很有自信地回答:「有,已完成。」
我要它告訴我的是:在哪個檔案?哪個 Function?哪裡做權限判斷?哪裡檢查狀態?失敗的時候怎麼處理?
也就是不要只給我結論,而是把證據找出來,然後我再回到程式、Diff 或實際操作去確認。
AI 說「已完成安全控制」不算,找得到證據才算。
人工把流程走完,不代表測試就結束了。
前面 Phase 5 已經講過自動化掃描,所以這裡我就不再重新介紹一次所有工具。SAST、Secret Scanning、SCA、DAST,有既有成熟工具就用既有工具,沒有再依照自己的環境與風險選擇適合的做法。
只要專案使用第三方套件,相依套件與已知漏洞就應該納入檢查;系統真的跑起來之後,也可以從應用層實際測試,協助發現 XSS、Injection、認證與存取控制等問題。
但還是同一句話:
工具沒有掃到,不代表漏洞不存在,只代表這一輪沒有發現。
如果系統規模更大、風險更高,或準備正式提供大量使用者使用,就再依風險考慮安排更獨立的安全檢視或滲透測試。因為自己開發、自己測、自己審,永遠可能存在盲點。
掃出問題,就回去修。修完,再測。這本來就是 SSDLC 的一部分。
AI 寫的程式碼,不會因為是 AI 寫的,就沒有 Bug、沒有漏洞。它只是寫得比較快。
甚至也因為它寫得太快,我們反而更需要刻意把開發切小。不是叫 AI 寫慢一點,而是 Phase 做小一點,功能做完就驗,每一段停下來看,每一段留下 Commit。
登入做完就測登入,分權做完就測越權,上傳做完就測上傳,掃描做完就測能不能繞過,審核做完就測能不能跳關。正常流程測一次,異常流程也測一次;不同角色重新測一次權限;最後再把前面的威脅建模拿回來逐條確認。
這也就是前面講 SSDLC 和 Shift Left 時一直在講的事情:
安全不是最後上線前,才突然拿一台掃描器過來掃一下。
掃出來的、人工點出來的問題,就退回開發階段修。修完,再測,直到當初列出的需求、權限、威脅與紅線,每一條都有交代。
AI 可以幫你把程式寫得很快,但不能幫你承擔最後的責任。
AI 負責加速產出,人負責確認它能不能上線。
到這裡,「測試」這一站才算走完。


 iThome鐵人賽
 看影片追技術