
今天我們要談談這些LLM系統裡最麻煩的問題之一Hallucination(幻覺),這個問題導致了模型用非常肯定的語氣,講出完全錯誤的內容,甚至你一直糾正他後他還會反覆出錯,但這件事情最麻煩的地方不是模型會犯錯,真正麻煩的是,模型講錯話的語氣,跟講對話的語氣,幾乎一模一樣。
如果你問模型一些年月日等基本資訊,在輸出上就很有可能發生錯誤;像是數學這類需要精確計算的問題,在早期版本的模型中也經常出現各種錯誤。
而到了現在模型雖然在這些問題上已經改善很多,但並沒有代表這些問題被徹底解決,而目前的模型除了模型本身能力的提升之外,也會透過前幾天提到的 RAG,讓模型在需要精確資訊時可以取得外部資料,進一步降低憑空生成錯誤內容的機率。
讓我們先看看前面幾天講的東西,模型的訓練目標從 Pretraining 開始就是預測下一個最可能的 token,這個目標本質上追求的是流暢、合理,不是正確。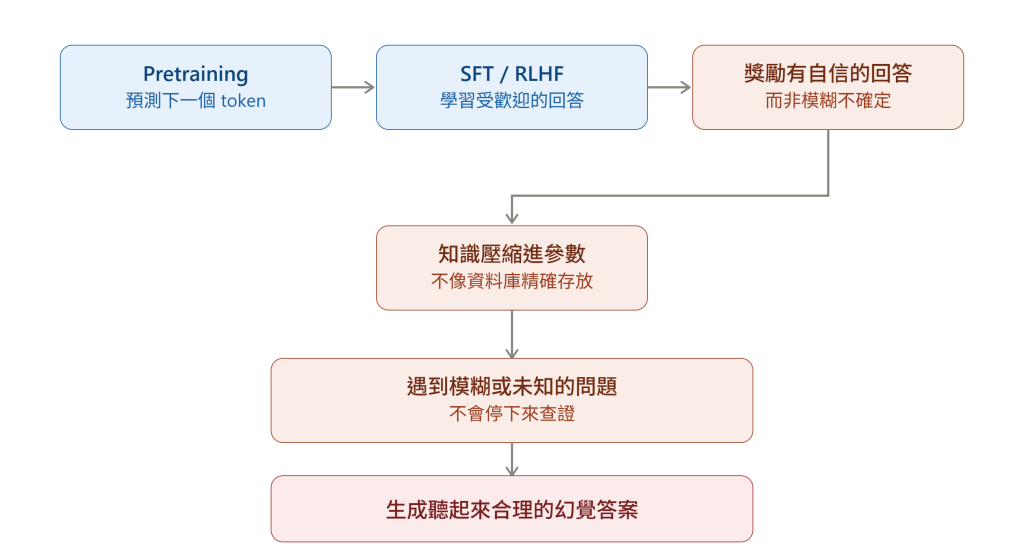
到了 SFT、RLHF 階段,模型學到的是怎樣的回答比較受歡迎,而人類標註者或 Reward Model 在打分的時候,往往會更喜歡被講得有條理、有自信的答案吸引,而不是選擇模糊不定的回覆。這也是為什麼你很少看到模型主動說這個我不確定,建議你查證,反而更常看到它一本正經地掰出一個聽起來很合理的答案。
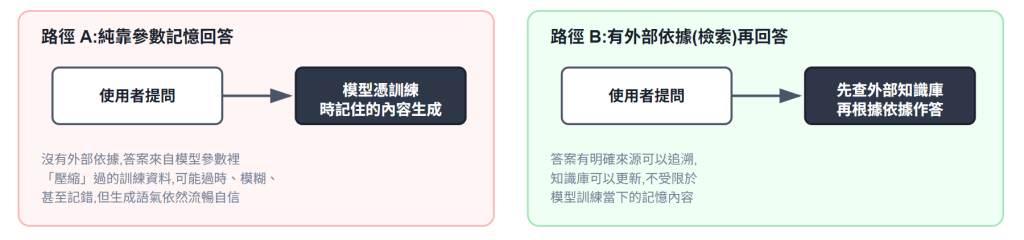
這就是因為模型從一開始就不是被訓練成只講真話,而是被訓練成講出讓人覺得滿意的話,這兩者在大部分情況下重疊但不完全重疊。再加上一個更根本的限制模型能知道的事情,終究只有訓練當下看過的資料,而且這些資料被壓縮進參數裡,不是像資料庫一樣精確存放。
當你問到訓練資料裡沒有,或是模型記得模糊的內容時,模型不會停下來說我查一下,它只會根據學到的語言模式,順著往下生成一個聽起來很合理的答案,這就是幻覺最典型的來源。
這也是為什麼我們在 Day 3 說明RAG的時候說道一句,知識不該靠模型記住,而是應該在需要的時候查出來,當答案有明確的外部依據可以追溯,模型就能夠根據查到的內容回答,而不是憑印象亂猜,這樣至少答案有機會被驗證、被追溯來源。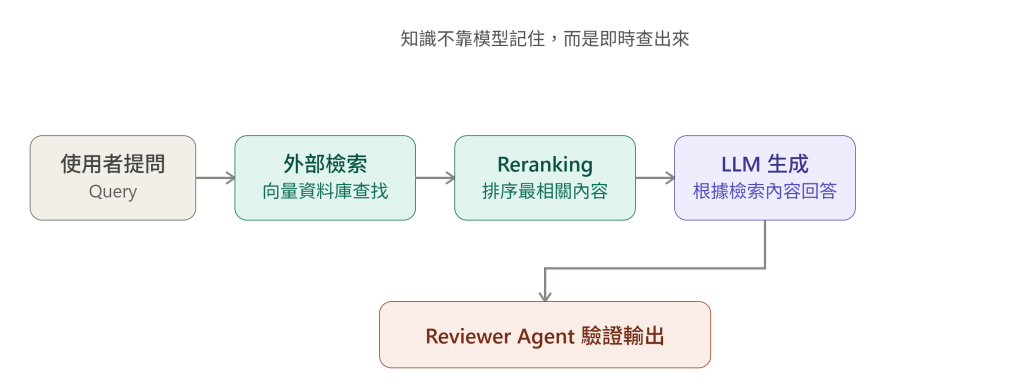
不過這幻覺的問題在目前是無法根本上解決的,因為就算檢索回來的內容是正確的,模型還是有可能誤讀、誤用,或者在整合多段檢索結果時邏輯出錯,這也是為什麼 RAG Pipeline 裡的 Reranking,以及後面 Reviewer Agent 的驗證層,都不是多餘的設計。
講到這裡想跟你介紹一個這幾天剛好很紅的新東西,叫 Jev,是 TypeSafe AI 在 2026 年 9 月中發布的模型,官方把它歸類成System One Model,它跟我們前面談的 LLM 邏輯完全不同 Jev 不生成自然語言文字**,而是接收一個狀態或問題,直接回傳型別化的答案,例如分類、分數、選項,搭配對應的機率。**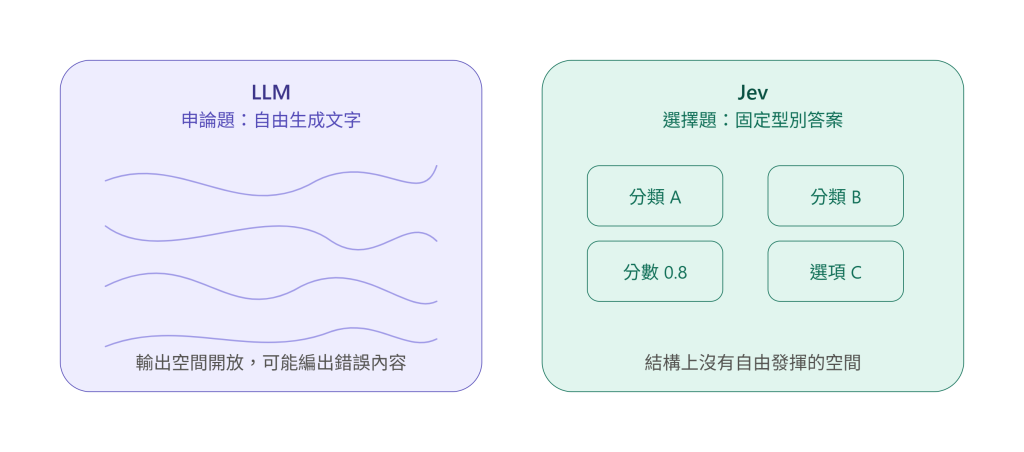
因為輸出空間從一開始就被限制在固定的類型裡,所以自然地在結構上就沒有自由發揮亂編內容的空間,這也讓這種模型的幻覺率明顯偏低。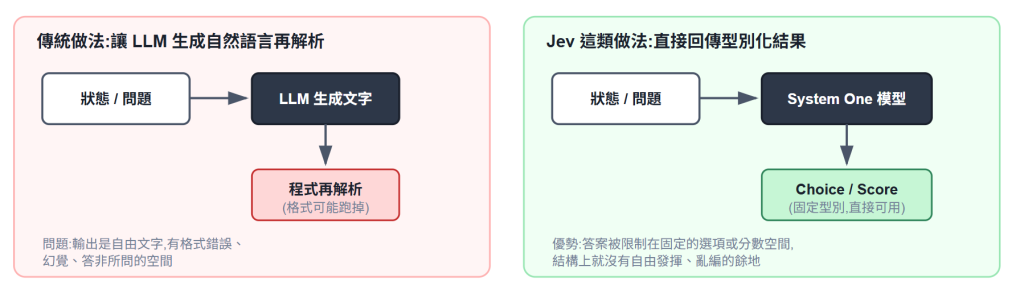
但這裡要澄清一個容易被過度解讀的地方
Jev的低幻覺是因為它做的是選擇題,不是申論題。拿它跟一般LLM比誰比較不會幻覺其實不太公平,畢竟本來就是兩種完全不同的任務型態。
不過這種做法對我們要做的 Multi-Agent 系統來說,因為 Orchestrator 要做的事情,很多時候正是這個任務該分派給哪個 Agent、這一步該不該觸發 RAG 檢索這種選擇題式的判斷,而不是自由創作。同時Reviewer Agent 要做的這個輸出符不符合規則,本質上也是一個分類判斷。
所以在這些場景中,說不定比丟給一個完整的大型 LLM 做,更適合交給 Jev 這類輕量、快、結構化的決策模型處理。這也是 LangChain 最近推出 Jev-as-a-Judge[1] 實驗,拿它當 Agent 評估器的原因。
Jev-as-a-Judge[1]:
https://www.langchain.com/blog/jev-agent-evals-langsmith
今天我們知道了幻覺的根本原因,是模型被訓練成講出讓人滿意的話,而不是只講真話,再加上參數記憶本身的侷限,最終就容易產生各種講得煞有其事,但其實完全不對的答案。
而經過這六天我們終於把接下來需要知道的基礎原理都講完了,**明天終於可以正式進入程式碼環節!**這一次我將會告訴你 RAG 該如何完整實作,會一路從 Chunking、Embedding、向量資料庫、混合檢索,到 Reranking,一步一步的教你怎麼撰寫。
那我們明天見!


 iThome鐵人賽
 看影片追技術