
前面已經掌握了後續實作所需的理論基礎,因此從接下來幾天開始我們不會再花太多篇幅停留在理論,而是直接進入實作,在動手寫程式的過程中,一步步理解這些知識該如何真正應用。
今天我們先從一個最簡單的 RAG 開始,實際走過一次完整流程,讓你看到前面學到的概念,至於 Chunking 策略、Embedding 模型的選擇、向量資料庫、混合檢索,以及 Reranking 等更進階的細節,接下來幾天會逐一拆解,分別實作與比較,讓你不只是知道這些技術是什麼,也能理解它們在 RAG 系統中扮演什麼角色,以及該如何做出合適的選擇。
這篇的完整程式碼也同步放在 GitHub repo:
https://github.com/AUSTIN2526/30-days-ironman-agent,可以直接下載下來執行。
讓我們保持一個良好的習慣,當你在寫程式之前先把整個系統的架構看清楚,你才會知道每一段程式碼在整條流程裡的位置,以方便Debug或是進行更好的流程設計。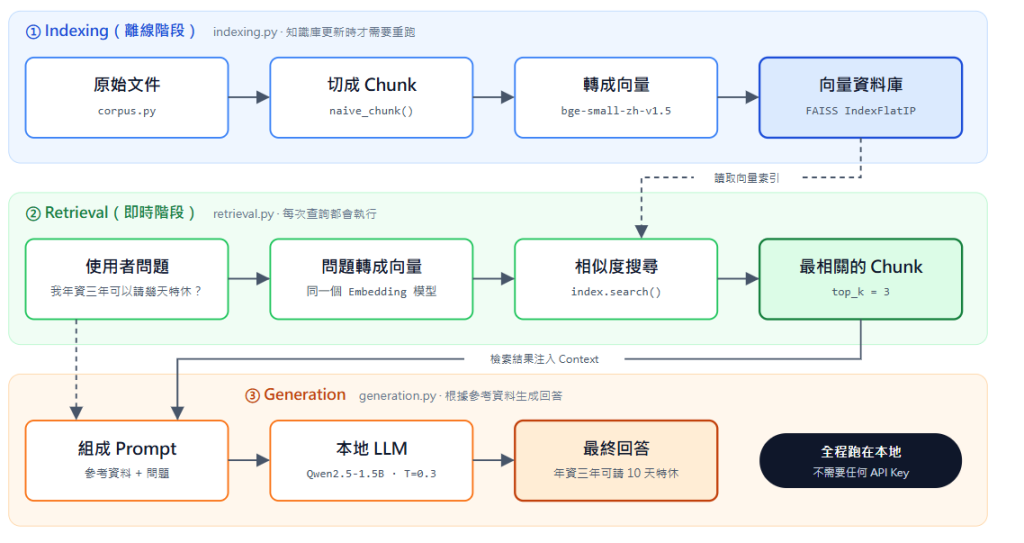
RAG 的流程其實只有三個階段:
Indexing(離線階段):把原始文件切成小塊(Chunk),轉成向量後存進向量資料庫。這一步通常是離線批次處理,只有知識庫更新時才需要重跑。Retrieval(即時階段):使用者的查詢進來時,先把查詢轉成向量,再到向量資料庫裡做相似度搜尋,找出最相關的幾個 Chunk。Generation(即時階段):把檢索到的內容連同使用者的問題組成 Prompt,交給 LLM 生成最終答案。如果覺得有點複雜,記住這句話就好:
Indexing 是「先把書整理好放上書架」,Retrieval 是「有人問問題時去書架找書」,Generation 是「翻開找到的那幾頁,照著內容回答」。
接著我們看看今天會用到的各個函式庫分別負責什麼,之後呼叫它們時,你才知道自己正在處理流程裡的哪一段。
pip install sentence-transformers faiss-cpu numpy torch transformers accelerate
| 函式庫 | 負責的階段 | 做什麼 |
|---|---|---|
sentence-transformers |
Indexing、Retrieval | 在本地把文字轉成向量(Embedding)。 |
faiss-cpu |
Indexing、Retrieval | Meta 開源的向量搜尋函式庫 |
torch |
Generation | 底層的張量運算引擎,實際執行模型的數學計算 |
transformers |
Generation | 下載並載入模型權重與 Tokenizer,提供 generate() 這類高階介面 |
accelerate |
Generation | 處理模型要放在哪個裝置上跑 |
所以我們可以將以上的流程圖變換成以下這樣子: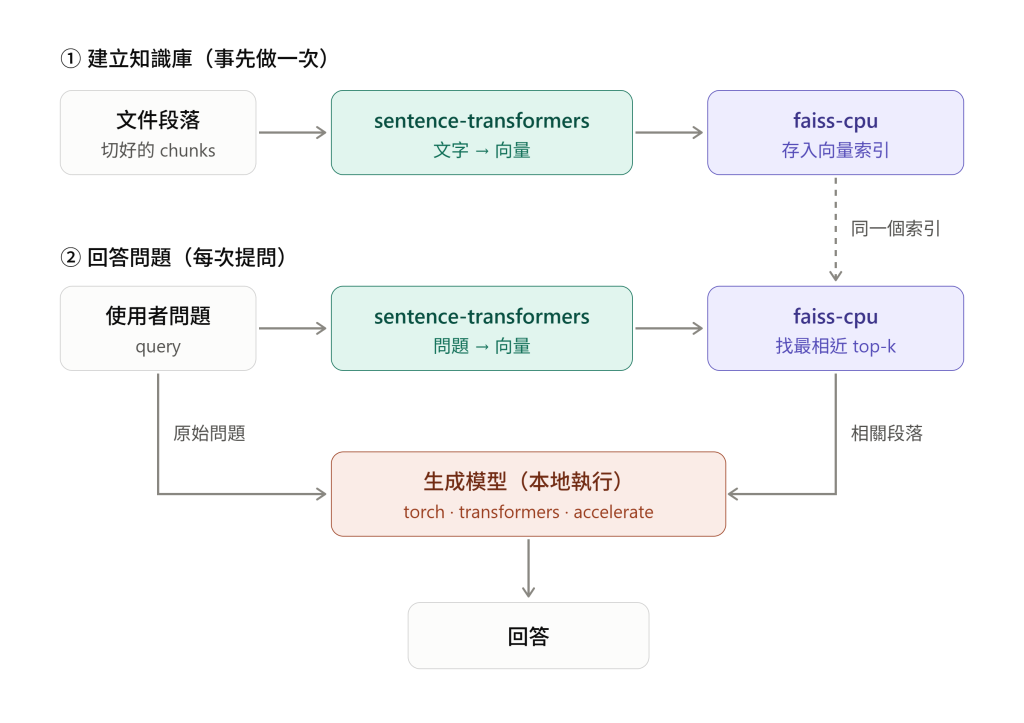
這次我們整個專案只有四個檔案:
day07-minimal-rag/
├── corpus.py       # 知識庫(今天先手寫)
├── indexing.py     # Step 1:切塊 → 轉向量 → 建索引
├── retrieval.py    # Step 2:問題轉向量 → 相似度搜尋
└── generation.py   # Step 3:組 Prompt → 本地模型生成答案
由於我們現在還沒有正式的文件,所以先手動建立一份簡單的知識庫當作測試資料:
# corpus.py
documents = [
    "公司的年假規則是:年資滿一年可請 7 天特休,滿三年可請 10 天,滿五年可請 14 天。",
    "報帳流程需要先在系統上填寫申請單,主管簽核後,財務部會在 5 個工作天內撥款。",
    "遠端工作申請需要提前三天跟主管報備,每個月最多可以申請 8 天遠端工作。",
    "公司的健康檢查福利,每年提供一次免費健檢,可以在特約醫院預約。",
    "離職申請需要提前一個月提出,並完成工作交接清單後,才能辦理離職手續。",
]
這裡的 documents 就是我們的知識庫,不過在實際的 RAG 系統裡,這些資料可能來自公司的 PDF、Word、Markdown、網頁,甚至是資料庫,但為了先把核心流程搞懂,今天先用最單純的 Python list 代替。
Indexing 的核心工作,是把文字轉成向量。為什麼要這樣做?因為電腦沒辦法直接看出「年資三年可以請幾天特休?」和「工作滿三年有 10 天假」這兩句話意思很接近,它們幾乎沒有共用的字。但經過 Embedding 之後,每段文字都會變成一串數字。
# indexing.py
import pickle

import faiss
import numpy as np
from sentence_transformers import SentenceTransformer

from corpus import documents

# 選用支援中文的 Embedding 模型,選型細節 Day 9 詳談
model = SentenceTransformer("BAAI/bge-small-zh-v1.5")
而在這裡載入的 BAAI/bge-small-zh-v1.5 是一個專門處理中文的 Embedding 模型,會把一段文字轉成 512 維的向量:
[0.012, -0.381, 0.742, ...] ← 共 512 個數字
這串數字代表文字的語意特徵。你可以把它想成語意空間裡的一個座標,也就是意思相近的文字,座標會靠得很近。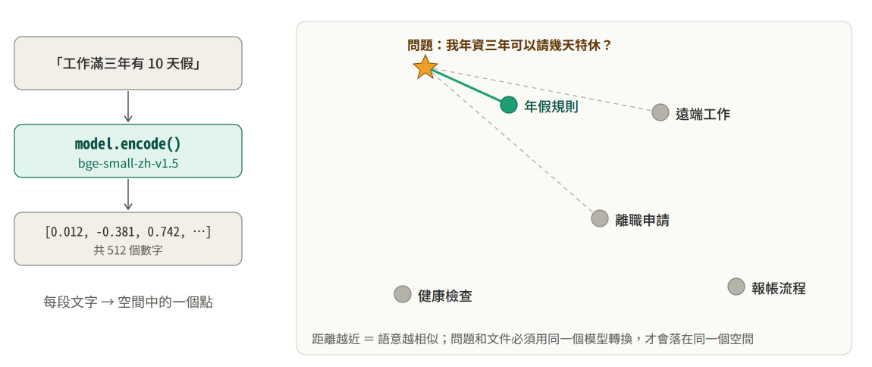
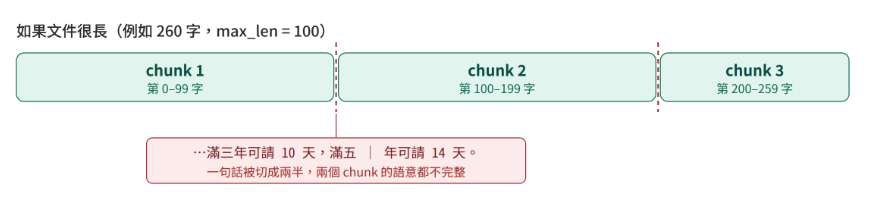
不過若一次輸入的文字太大,就會導致語義空間變得很混亂,所以在轉向量之前,我們要先把大份的文件切成小塊,也就是 Chunking。
def naive_chunk(text: str, max_len: int = 100) -> list[str]:
    """最簡單的固定長度切割,先求能動。"""
    return [text[i:i + max_len] for i in range(0, len(text), max_len)]
這裡用最簡單方式進行切割,每 100 個字切一刀,但實際的系統通常會依照文章的章節、段落等結構來切,就像我們翻說明書時,會先找到對應的章節,而不是隨便翻到某一頁的中間。
接下來就是把知識庫裡的每份文件都丟進 naive_chunk,切出來的結果全部收進同一個 chunks list中使後續可以轉換成向量文件與索引直。
def main():
    # 1. 把所有文件切成 chunk
    chunks = []
    for doc in documents:
        chunks.extend(naive_chunk(doc))
不過我們的 5 份文件最長也才 45 個字,全部小於 100,所以 naive_chunk 對每份文件都只會回傳一個 chunk,今天執行後只會看到 5 個 chunk。
接下來我們要用model.encode() 會把每個 chunk 轉成一個向量,該程式的回傳結果會是一個 (5, 512) 的矩陣,這裡要注意第一點,必須轉成 float32 是因為 FAISS 只吃這個型別。
    # 2. 把每個 chunk 轉成向量
    embeddings = model.encode(chunks, normalize_embeddings=True)
    embeddings = np.array(embeddings, dtype="float32")
另外還要注意一點normalize_embeddings=True 很重要,它會把每個向量的長度都調整成 1。內積的公式是 a · b = |a| × |b| × cos θ,當兩個向量長度都是 1,內積就只剩下 cos θ。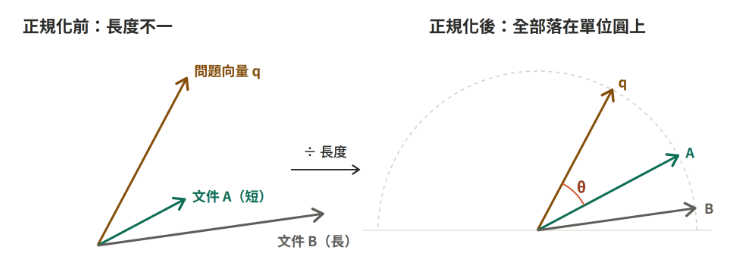
也就是說正規化之後,向量內積就等於 cosine similarity,分數完全由兩個向量的方向決定,不會被向量長度影響。
接下來我們需要建立 FAISS索引,你可以把它想成一個專門處理大量向量搜尋的工具。
    # 3. 建立 FAISS 索引(向量已正規化,所以用內積就等同 cosine similarity)
    dimension = embeddings.shape[1]    # 512
    index = faiss.IndexFlatIP(dimension)
    index.add(embeddings)
在這裡我們選擇使用IndexFlatIP的方式,該方式是 FAISS 裡最簡單的索引Flat 代表不做任何壓縮或分群,IP 代表用內積(Inner Product)計算相似度。搜尋時它會拿查詢向量跟索引裡的每一個向量都算一次內積,再排出分數最高的幾筆。
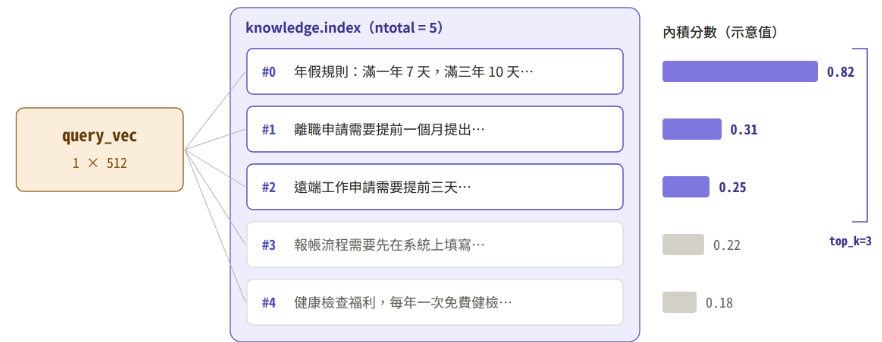
這種做法叫暴力搜尋(exact search),優點是結果一定最準,缺點是每次查詢都要把所有向量算過一遍。5 筆資料只要算 5 次,但 100 萬筆就要算 100 萬次,所以我們還是要視情況使用。
最後把結果存到本地硬碟,因為我們不希望使用者每問一次問題,就重跑一次 Indexing。 只需要知識庫要更新時再跑一次就好。
    # 存起來給檢索階段用
    faiss.write_index(index, "knowledge.index")
    with open("chunks.pkl", "wb") as f:
        pickle.dump(chunks, f)

    print(f"索引完成,共 {len(chunks)} 個 chunk,向量維度 {dimension}")


if __name__ == "__main__":
    main()
注意這裡存了兩個檔案,knowledge.index只存向量,這是因為 FAISS 搜尋完只會告訴你第幾號向量最相似,而chunks.pkl才是存原文的地方兩個檔案的順序是對應的,所以重建索引時一定要一起更新。
接著我們開始初始化Retrieval的系統,一開始就是先把 Step 1 存好的兩個檔案讀回來,並載入同一個 Embedding 模型。
為什麼一定要同一個?不同模型產生的向量空間完全不同,就像一張台北地圖和一張東京地圖,座標數字看起來一樣,指的卻根本不是同一個地方。只有在同一個空間裡,比較距離才有意義。
# retrieval.py
import pickle

import faiss
from sentence_transformers import SentenceTransformer

# 必須和 indexing.py 用同一個 Embedding 模型
model = SentenceTransformer("BAAI/bge-small-zh-v1.5")
index = faiss.read_index("knowledge.index")

with open("chunks.pkl", "rb") as f:
    chunks = pickle.load(f)
接下來就是要做出一個可以接收使用者丟進來的問題的函式,記得不是純文字,而是一樣要轉成向量並且一樣要正規化,這樣算出來的內積才會是 cosine similarity,跟文件向量的分數在同一個標準上。
def retrieve(query: str, top_k: int = 3) -> list[dict]:
    query_vec = model.encode([query], normalize_embeddings=True)
    query_vec = query_vec.astype("float32")
這裡特別注意 encode() 傳進去的是 [query](一個 list),所以得到的是形狀 (1, 512) 的矩陣,需要做的寫是因為這正是 FAISS 需要的格式。
接下來我們只需要僅僅一行就能計算相似度,這是也式整個 Retrieval 最核心的一行,可以說前面其實都是在整理格式而已,真正的核心只有這個。
scores, indices = index.search(query_vec, top_k)
當我們這樣寫,就能夠把問題向量丟進 FAISS,請它找出最相似的 top_k 筆資料scores會回傳每一筆的相似度分數,indices則是回傳每一筆在索引裡的編號。
不過由於 search() 可以一次查多個問題,兩個陣列的形狀都是 (查詢數量, top_k),但我們只有一個問題,所以需要使用scores[0]、indices[0] 取出唯一一個問題的結果。
    results = []
    for score, idx in zip(scores[0], indices[0]):
        if idx == -1:  # top_k 比索引裡的資料還多時,FAISS 會用 -1 補位
            continue
        results.append({
            "content": chunks[idx],
            "score": float(score),
        })

    return results
最後我們用 chunks[idx] 把編號換回原本的文字,這就是 Step 1 要另外存 chunks.pkl 的原因。其中注意idx == -1 的判斷是防呆,因為如果使用者輸入的 top_k 設得比索引裡的資料筆數還大,FAISS 會用 -1 補滿不足的位置,直接拿去取 chunks[-1] 會拿到最後一筆,造成錯誤的結果。
最後我們執行下面這段程式,會看到類似這樣的輸出:
if __name__ == "__main__":
    query = "我年資三年可以請幾天特休?"
    results = retrieve(query)

    for r in results:
        print(f"[score={r['score']:.3f}] {r['content']}")
可以看到當我們的分數越高,代表語意越接近,年假規則那筆明顯勝出。
[score=0.820] 公司的年假規則是:年資滿一年可請 7 天特休,滿三年可請 10 天...
[score=0.310] 離職申請需要提前一個月提出...
[score=0.250] 遠端工作申請需要提前三天跟主管報備...
但也請注意後面兩筆離職申請和遠端工作其實跟特休毫無關係,只是因為我們要求 top_k=3,FAISS 就一定會湊滿三筆給你。向量搜尋只負責「排名」,不負責判斷「到底相不相關」。
這些雜訊之後會一起被塞進 Prompt,後面幾天還需要去理解分數門檻和 Reranking到底在做些什麼。到這裡 Retrieval 就完成了。
到目前為止模型還沒回答任何問題,我們只是先幫它從知識庫裡找出可能有用的資料,真正負責回答的就是這一個階段。
在這裡我們使用 Qwen2.5-1.5B-Instruct來進行測試,原因就是它體積相對小、比較適合測試,在這裡我們需要載入模型本身與相對應的**Tokenizer**,因為我們需要把文字切成模型看得懂的 Token 編號,生成完再把編號轉回文字。
# generation.py
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

from retrieval import retrieve

# 選用中文能力不錯、體積夠小、本機也跑得動的指令模型
# 沒有 GPU 的話可以換成 Qwen/Qwen2.5-0.5B-Instruct,推論會更輕量
MODEL_NAME = "Qwen/Qwen2.5-1.5B-Instruct"

print("正在載入本地模型,第一次執行會下載權重,請稍候...")

tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)

use_cuda = torch.cuda.is_available()
device = "cuda" if use_cuda else "cpu"

model = AutoModelForCausalLM.from_pretrained(
    MODEL_NAME,
    torch_dtype=torch.float16 if use_cuda else torch.float32,
    device_map="auto" if use_cuda else None,
)

if not use_cuda:
    model = model.to(device)
後半段是跟硬體有關的設定有 GPU 就用 float16 省一半記憶體,並透過 accelerate 的 device_map="auto" 自動把模型放上 GPU;沒有 GPU 就用 float32 在 CPU 上跑,比較慢但一樣能動。
接下來我們要把 RAG 給串起來的,也就是它把 Retrieval 找到的資料,整理成這樣的文字:
def build_prompt(query: str, retrieved_chunks: list[dict]) -> str:
    context = "\n".join(
        f"- {c['content']}"
        for c in retrieved_chunks
    )

    user_prompt = f"""請根據以下參考資料回答問題,如果參考資料中沒有相關資訊,請明確說明查不到,不要自行猜測。

參考資料:
{context}

問題:{query}"""

    return user_prompt
請根據以下參考資料回答問題,如果參考資料中沒有相關資訊,請明確說明查不到,不要自行猜測。

參考資料:
- 公司的年假規則是:年資滿一年可請 7 天特休,滿三年可請 10 天...
- 離職申請需要提前一個月提出...
- 遠端工作申請需要提前三天跟主管報備...

問題:我年資三年可以請幾天特休?
而我們的 Prompt 開頭那句「如果參考資料中沒有相關資訊,請明確說明查不到」也不是隨便寫的,這是因為前面提過Retrieval 一定會湊滿 top_k 筆,就算知識庫裡根本沒有答案也一樣。這句指令就是給模型一條可以說不知道的退路,以降低模型的幻覺。
不過以上都只是文字而已,我們還需要設定不同文字所扮演的角色,像是system 設定模型的身分與規則,user 放使用者的輸入文字。
def call_local_llm(user_prompt: str, max_new_tokens: int = 256) -> str:
    messages = [
        {"role": "system", "content": "你是一個嚴謹的助理,只根據提供的參考資料回答問題,不會自行編造內容。"},
        {"role": "user", "content": user_prompt},
    ]

    inputs = tokenizer.apply_chat_template(
        messages,
        add_generation_prompt=True,
        return_tensors="pt",
        return_dict=True,          # 明確要求回傳 dict,新舊版行為一致
    ).to(device)

    with torch.no_grad():
        output_ids = model.generate(
            **inputs,              # 同時傳入 input_ids 和 attention_mask
            max_new_tokens=max_new_tokens,
            temperature=0.3,
            do_sample=True,
            top_p=0.9,
            pad_token_id=tokenizer.eos_token_id,
        )

    generated = output_ids[0][inputs["input_ids"].shape[-1]:]
    response = tokenizer.decode(generated, skip_special_tokens=True)
    return response.strip()
而整理成這個格式後,才能夠套上正確的token,提醒模型到底是誰在說話。
而以上的步驟是因為指令模型在訓練時看到的都是特定格式的對話,而且每家模型的格式都不一樣。apply_chat_template() 會自動把 system 和 user 訊息包成這個模型熟悉的樣子,再轉成 Token 編號。
    inputs = tokenizer.apply_chat_template(
        messages,
        add_generation_prompt=True,
        return_tensors="pt",
        return_dict=True,  # 同時拿到 input_ids 和 attention_mask
    ).to(device)
像是再QWEN的模型中模型的回覆會有<|im_start|>assistant,等於告訴模型接下來輪到你說話了。少了它,模型可能會接著寫使用者的問題,而不是開始回答,而經過上述的整理,這時我們的模型內容就會長得像這樣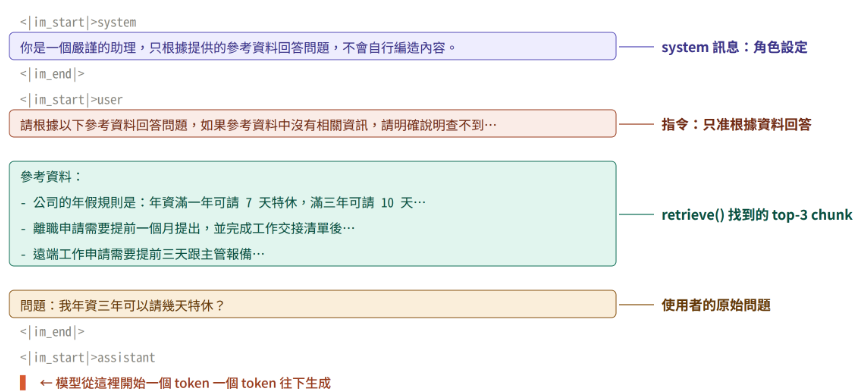
這裡也就是讓模型能生成一個 Token 是什麼的機率分布的地方,因此我們需要調整temperature、top_p...等參數。
    with torch.no_grad():
        output_ids = model.generate(
            **inputs,
            max_new_tokens=max_new_tokens,
            temperature=0.3,
            do_sample=True,
            top_p=0.9,
            pad_token_id=tokenizer.eos_token_id,
        )
而在這裡我們這裡刻意把 temperature 壓到 0.3,因為需要忠實根據參考資料回答的任務,不需要模型發揮創意,我們希望模型乖乖照著資料回答,而不是突然靈感大爆發,自己幫公司的年假制度加戲。
當然如果想要每次輸出完全一樣,可以改成
do_sample=False(貪婪解碼),這時temperature和top_p就不會生效。
而這時模型生成的地方只會是文字,因此我們可以使用Tokenizer將其轉回一開始的文字,不過記得generate() 回傳的結果包含原本的輸入,所以要用輸入長度當起點,把前面那段切掉,只留下模型新生成的部分。
    # 輸出包含原本的輸入,只取模型新生成的部分
    generated = output_ids[0][inputs["input_ids"].shape[-1]:]
    response = tokenizer.decode(
        generated,
        skip_special_tokens=True,
    )

    return response.strip()
接著用 tokenizer.decode() 把 Token 編號轉回文字,skip_special_tokens=True 會順便拿掉 <|im_end|> 這類特殊標記。
最後我們撰寫一個 answer() 函式,它僅僅只有只有三行,因為我們前面都把相關的程式碼建立完畢了。
def answer(query: str) -> str:
    retrieved = retrieve(query, top_k=3)      # Retrieval
    prompt = build_prompt(query, retrieved)   # 組 Prompt
    return call_local_llm(prompt)             # Generation


if __name__ == "__main__":
    query = "我年資三年可以請幾天特休?"

    print(f"問題:{query}\n")
    print(f"回答:{answer(query)}")
而最後我們可以實際跑看看完整的程式碼,先建立索引
python indexing.py
索引完成,共 5 個 chunk,向量維度 512
再問問題:
python generation.py
# 輸出:
問題:我年資三年可以請幾天特休?
回答:根據參考資料中的信息,年資滿三年的員工可以請到10天的特休。
這時你會看到系統先從知識庫檢索出相關內容,再把這些內容組進 Prompt,最後由本地模型生成答案整個過程不需要任何 API Key,資料也不會離開你的電腦。
今天我們用最簡單的方式把 Indexing → Retrieval → Generation 串成一個能動的最小系統,但過程中也埋下了幾個之後要解決的問題:
naive_chunk 會把句子從中間切斷IndexFlatIP 在資料量大時會變慢top_k 一定會湊滿筆數,把不相關的資料也塞進 Prompt(混合檢索與 Reranking)所以接下來幾天,我會把裡面的每一個環節換成更嚴謹的做法,那我們明天見!


 iThome鐵人賽
 看影片追技術