
留言解析完、身分掛好單,主線走到心臟:庫存。這個系統的功能清單可以慢慢長,但只有一條規則從第一天就是鐵律——不能超賣。賣掉不存在的貨,是要一個一個跟客人道歉退款的。這章講當年怎麼守這條不變量、它被什麼打破過(答案會出乎意料),以及重來會怎麼守。
最直覺的庫存設計,是存一個「剩餘庫存」欄位,賣一件減一、退一件加一。當年沒有這樣做,而是把帳本拆成一個上限、兩個消耗:
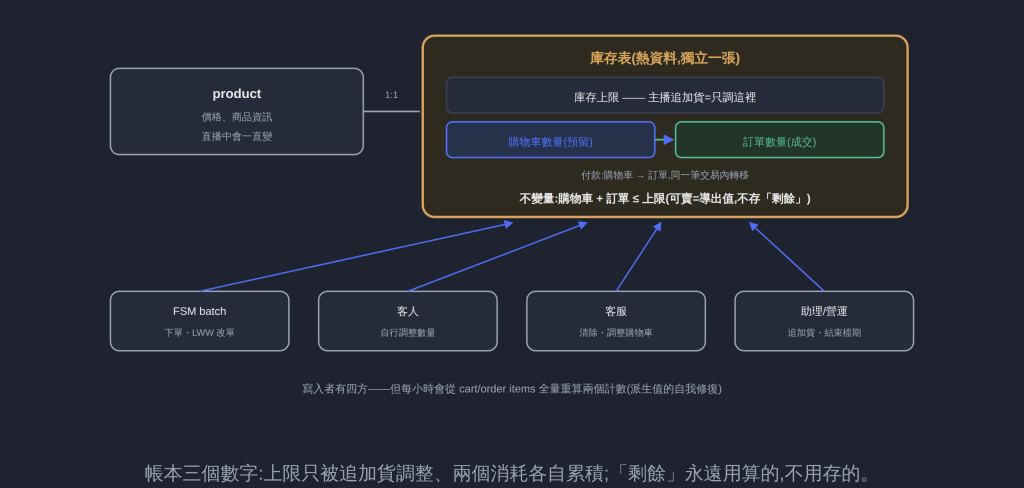
這個形狀有三個當年就做對的判斷:
併發扣庫存的標準選項有三條路:資料庫鎖、Redis 原子操作、單一寫入者排隊。當年的組合是第一條的重裝版:ORM + transaction、先查再扣、Serializable 隔離、噴錯就重試。Serializable 保證「先查再扣」的間隙不會被人插隊——擠進來的交易會直接失敗,重試,重試再失敗⋯⋯然後,那位顧客就被略過了。
先講公道話:這套當年沒有超賣過(超賣另有兇手,下一節)。單一 batch 消費者本來就把大部分的寫入天然序列化了,Serializable 是對付其餘寫入者(客人調數量、客服調整、助理追加貨)的保險帶,邏輯上無懈可擊。
問題出在失敗的分佈。重試耗盡的顧客不是隨機掉的:衝突集中在哪裡,犧牲就集中在哪裡——衝突永遠集中在最搶手的商品。也就是說:你賣得越好的商品,無聲消失的客人越多。 這個偏差安靜、不報錯、不進任何儀表板,是我現在回看最想修的一刀。
重來的修法出奇地便宜——把「先查再扣」壓成一句條件更新:
UPDATE inventory
   SET cart_qty = cart_qty + 2
 WHERE product_id = :pid
   AND stock_cap - cart_qty - order_qty >= 2;
-- 影響 0 列=沒搶到,直接回「完售」;
-- 查與扣之間沒有間隙,也就沒有 Serializable、沒有重試風暴
當年主力是 ORM,而 Django 寫得出一模一樣的東西——filter() 就是 WHERE,F() 讓運算下推到資料庫、不把值撈回 Python:
from django.db.models import F

updated = Inventory.objects.filter(
    product_id=pid,
    stock_cap__gte=F("cart_qty") + F("order_qty") + n,  # 不變量寫在 WHERE 裡
).update(cart_qty=F("cart_qty") + n)                    # 一句 UPDATE,原子完成

if updated == 0:
    ...  # 沒搶到:乾淨地回「完售」,沒有例外、沒有重試
檢查和扣減在同一個原子動作裡,不變量由 WHERE 子句守著:搶不到就是乾淨的 0 列,不用隔離級別撐腰、不用重試、也就沒有重試耗盡的偏差。單列的原子條件更新,是關聯式資料庫最被低估的併發原語——而且它跟 ORM 毫無衝突,差別只在你有沒有意識到 filter().update() 是一句話,而「先 get() 再改欄位再 save()」是兩句話,中間的空隙就是當年 Serializable 在補的洞。
故障會叫:告警響、圖表掉、所有人衝進來。偏差不會——Serializable 重試耗盡的顧客,一個一個安靜地消失,而且集中在你最熱賣的商品上,系統毫無感覺。這是我帶 SRE 之後回頭看最有感的一刀:平均成功率 99% 的系統,可能在最重要的那 1% 流量上是 90%——平均值會說謊,失敗的分佈才說真話。重來版用一句條件更新把這個偏差從根拔掉,但更通用的功課是:每次設計「失敗就略過」的路徑時,先問一句——被略過的,會不會恰好都是同一群人?
不過,這個系統真的超賣過一次——而兇手不是併發。明天講那次事故。
本文改寫自我的部落格系列《Re:從零開始做直播代購電商平台》,本篇完整版:https://blog.aidan.tw/blog/rezero-inventory/


 iThome鐵人賽
 看影片追技術