
前一篇聊到,從網頁擷取出文字,不代表重要內容都有留下來。
不過,對我來說,就算原文存下來了,有時候還是希望多一點說明。例如這個工具可以用在哪裡,或這個知識有什麼使用情境,讓我之後看到時可以有一些想法,也能順便學習。
所以後來我想到用 NotebookLM 做強化補充。
但我只是把 NotebookLM 當成補充工具,真正要長期保存的地方,還是自己的知識庫。這樣就不只是把資料丟進去研究,還需要把整理好的內容寫回來,以及處理過程中建立的筆記本。
依照專案裡的紀錄,後來這個流程由 Windows 上的一支補強程式負責。文件稱它為 worker,可以把它理解成依照步驟處理工作的程式。
我前面提過手動執行的階段,後來的文件則記錄了每日排程。這篇整理的是後期的流程,不代表這些功能一開始就都有。
這支程式會先向知識庫取得待補強清單,再透過 notebooklm-py 的命令列工具操作 NotebookLM。
這也和我平常用 MCP 存資料的方式不同:這條補強流程由程式操作 NotebookLM,最後透過知識庫 API 寫回。
【圖片 1:NotebookLM 補強與寫回流程】
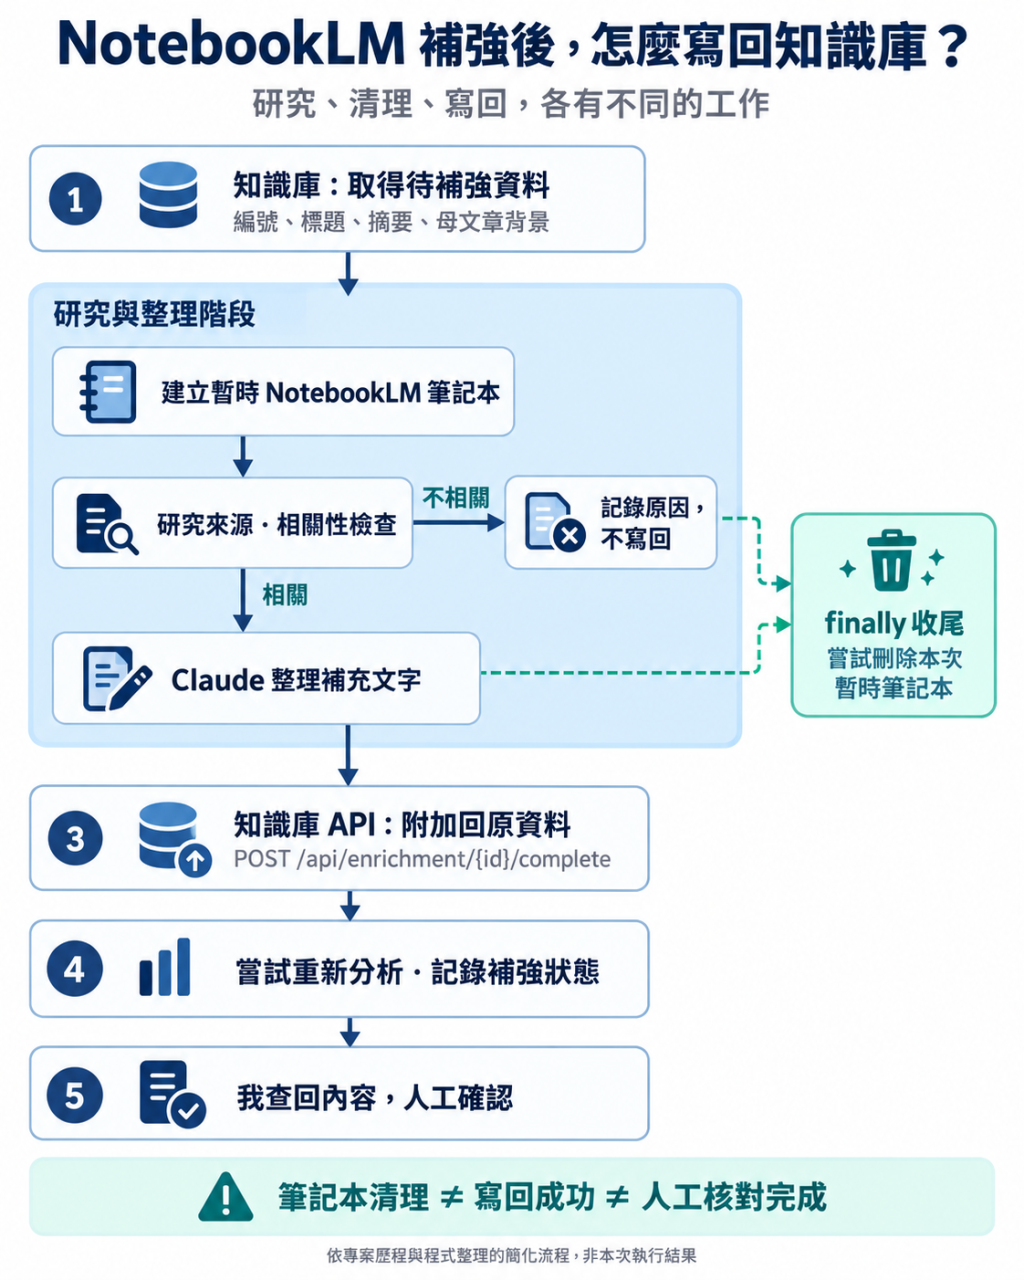
圖說:知識庫提供待處理資料,NotebookLM 協助研究,Claude 整理說明,最後由補強程式把結果送回知識庫。研究階段結束時,也會嘗試清理暫時筆記本。
補強程式先呼叫:
http
GET /api/enrichment/queue
這個 API 會回傳待處理資料。每筆都有自己的 id,後面才能把補充寫回同一筆。
目前挑選條件主要包含是否已補強、是否曾被相關性檢查否決,以及新舊資料分組。所以「待補強」不代表程式已經判定內容一定不足,而是符合這次處理條件。
除了編號,研究時也需要標題與內容背景。
之前我遇過補充方向跑掉的情況。回頭看歷程,早期程式只拿標題去搜尋,但有些資料是從文章拆出來的子章節,標題可能只叫「主要好處」或「運作流程」。
這樣的標題,離開原文章之後,其實看不出來是在講什麼。
後來才補上母文章標題和摘要,讓研究時知道:這是哪一篇文章裡的段落,實際討論的是什麼。
程式會為這筆資料建立一個暫時筆記本,透過 NotebookLM 的研究功能加入來源,再要求它整理聚焦於主題的事實資料。
中間有一個 Gate,也就是相關性檢查關卡,用來判斷找到的內容是否符合原本的資料。
不過,有檢查關卡不代表一定不會出錯。歷程裡就記錄過,研究出來的內容本身說得通,卻和原本的子章節無關,早期的檢查仍然沒擋住。
所以後來除了搜尋時提供背景,檢查時也要一起提供,才能比較「找到的內容」和「這筆資料真正要講的事情」。
我想要的是有幫助的補充。如果只是同名,或看起來主題有點像,卻補進不同的東西,之後閱讀反而更容易混淆。
依歷程文件,NotebookLM 整理出的事實資料,還會交給 Claude CLI,改寫成六段式的繁體中文教學說明。
因此,最後看到的文字經過了兩個階段:
| 階段 | 負責的工作 |
|---|---|
| NotebookLM | 研究來源、整理相關事實 |
| Claude CLI | 將資料整理成較容易閱讀的教學說明 |
整理完成後,補強程式會呼叫:
http
POST /api/enrichment/{item_id}/complete
{item_id} 就是原本那筆資料的編號,送出的內容大致如下:
{
  "content": "整理好的補充說明……"
}
這是請求格式示意,不是本次實際送出的資料。
後端收到之後,會把文字附加到原資料裡:
原本保存的內容……

## NotebookLM 整理補充(日期)

整理好的補充說明……
所以這一步是保留原本內容,再加上一段補充。
這個標題也提醒我:下面是後來研究整理的資料,不能直接當成原作者在原文章裡寫過的內容。
接著,程式會嘗試重新分析,並記錄 notebooklm_enriched_at,表示這筆資料已經經過補強流程。
目前這個狀態是資料庫裡的獨立欄位,不是一般分類標籤。而且程式沒有依重新分析的回傳結果決定是否標記,因此「已補強」不代表分析全部成功,也不代表我已經人工確認內容。
當初另一個需要解決的問題,是暫時筆記本一直累積,會占用可用的筆記本額度。
歷程記錄裡,原本程式在成功後直接結束,漏掉刪除動作;判斷不適合補充、提前跳過的路徑,也沒有清理。
後來做了兩個調整。
第一個是建立時加上標記:
[kb-enrich]
這個前綴用來辨識補強程式建立的暫時筆記本。沒有標記的舊筆記本,因為無法直接確認是不是我自己建立的,就留給人工確認。
第二個是把清理放進 finally。
我一開始以為,只有正常完成才會執行 finally,出錯時會把筆記本留下來。後來才了解,正常完成、中途發生例外,或提前離開這段處理時,通常都會執行裡面的收尾。
下面是依歷程紀錄整理的簡化示意,不是正式程式的逐字原碼,也不能直接執行:
notebook_id = None

try:
    notebook_id = create_temporary_notebook()
    addition = research_and_rewrite(notebook_id)
finally:
    if notebook_id is not None:
        try_delete_notebook(notebook_id)
所以,判斷內容不相關、沒有寫回的情況,也會嘗試清理這次建立的筆記本。
後期流程把研究整理和寫回分開,研究階段結束時清理筆記本,再使用取得的補充文字處理寫回。因此,刪除筆記本不能當成寫回成功的證據。
刪除本身也可能失敗,程式被強制終止時,finally 也不保證能執行。所以文件另外記錄了啟動時掃描帶標記的殘留筆記本,再嘗試清理的做法。
對我來說,NotebookLM 是補充工具,知識庫才是保存的地方。因此我更在意的是:內容最後有沒有寫進去,以及寫進去的東西是否符合需求。
如果送出之後沒有收到回覆,我會先回知識庫查看,再評估是否需要重新處理。
這裡也有實際踩過的問題:後端可能已經附加內容,只是後續分析花比較久,呼叫端等到逾時就以為失敗,重新送出,結果同一筆資料出現重複補充。
因此,我需要分開判斷:
| 查回後的情況 | 接下來怎麼處理 |
|---|---|
| 補充已存入,也符合需求 | 不必重送 |
| 已存入,但內容偏題或不足 | 調整研究背景或要求,再決定是否重新補強 |
| 還沒看到補充 | 先確認原本處理是否仍在進行,再決定是否重試 |
【圖片 2:沒有收到回覆時,如何確認結果】
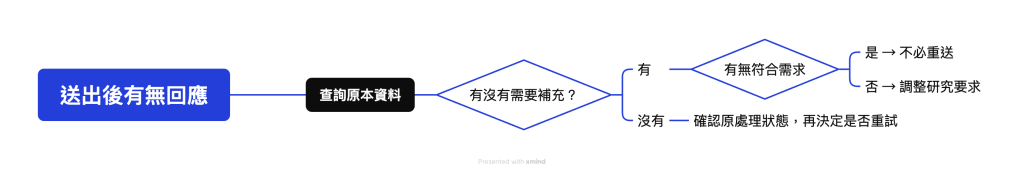
圖說:先查回知識庫,再分別判斷有沒有寫入、內容是否合適;逾時本身不能證明寫入失敗。
這次回頭理解流程,才發現「請 NotebookLM 補充」裡面其實有很多不同的工作。
要提供足夠背景,才比較不容易找錯方向;研究完要整理並寫回;暫時建立的筆記本要清理;最後我還是會打開內容,必要時回到原始連結或重新查證。
我希望這些補充可以幫我理解資料、想到使用情境,但不是內容變多,就代表知識庫變得更有用。
對我來說,能知道補充從哪裡來、和原本資料有什麼關係,以及之後能不能放心拿來參考,才是需要持續確認的地方。


 iThome鐵人賽
 看影片追技術