
系列開始時,我讓 SRE Agent 調查異常。Gemini 從一段混入操作指令的 Log 讀到 delete_demo_database,提出工具呼叫,Open Policy 回 ALLOW,Google ADK 再把參數交給 Tool。公開 Lab 只留下安全 Canary,沒有連到資料庫,但這條路已經暴露出一個問題:原本只想查資料,模型卻可以提出另一種動作。
如果今天再讀到相同內容,模型仍可能提出危險工具。三十天的工作不是讓這個可能性消失,而是逐步建立可檢查的邊界:誰發起請求、哪個元件能拒絕、目標資源如何授權,以及執行後有哪些結果可以核對。
最後這篇把它們接回一條路。讀者可以沿同一次操作,找到執行前的判斷、執行版本的來源和事後查詢的入口,再把這些位置換成自己環境裡的系統。已實測的能力與尚待完成的設計,仍保留各自的界線。
最初的工具名稱和參數符合程式介面,Policy 也按設定放行,所以沒有發生讓流程停止的技術錯誤。真正缺的是「這個調查任務能不能提出刪除操作」的執行控制。模型把外部資料當成下一步指令時,系統仍需要獨立判斷工具能否執行。
Day 3 用相同輸入加入 Tool Allowlist,危險 Function 在執行前被拒絕,Agent 後來改用 query_metrics 完成唯讀調查。這個對照說明,拒絕一個危險工具,仍可能保留完成原任務的路徑。它驗證的是工具級拒絕,並沒有完成所有真實資源的參數授權。
若下一版工具真的能修改資料庫,還需要知道允許的目標環境、參數與影響範圍。工單只批准測試環境時,正式環境參數就應被資源授權拒絕。這是後續設計目標,不能拿 no-op Canary 的安全性代替真實資料庫驗收。
Incident Replay Lab 保留最初放行與後來拒絕的歷史對照。正文在這裡使用的是決定性差異:前者走到安全工具分支,後者在執行前停止,兩者沒有產生真實刪除。
下圖中央是動作路徑:Caller 提出請求,Gateway 處理共同入口,Runtime 安排工作,Tool/Resource Server 決定目標操作能否執行。下方另有執行產物的交付資料,以及事件和觀測資料的保存位置。
閱讀時可以先沿中央找「哪裡能拒絕這個動作」,再看下方找「怎麼知道跑的是哪份程式」和「之後去哪裡查結果」。這三個問題讓圖上的產品位置有具體用途,讀者不用先背一整份能力清單。
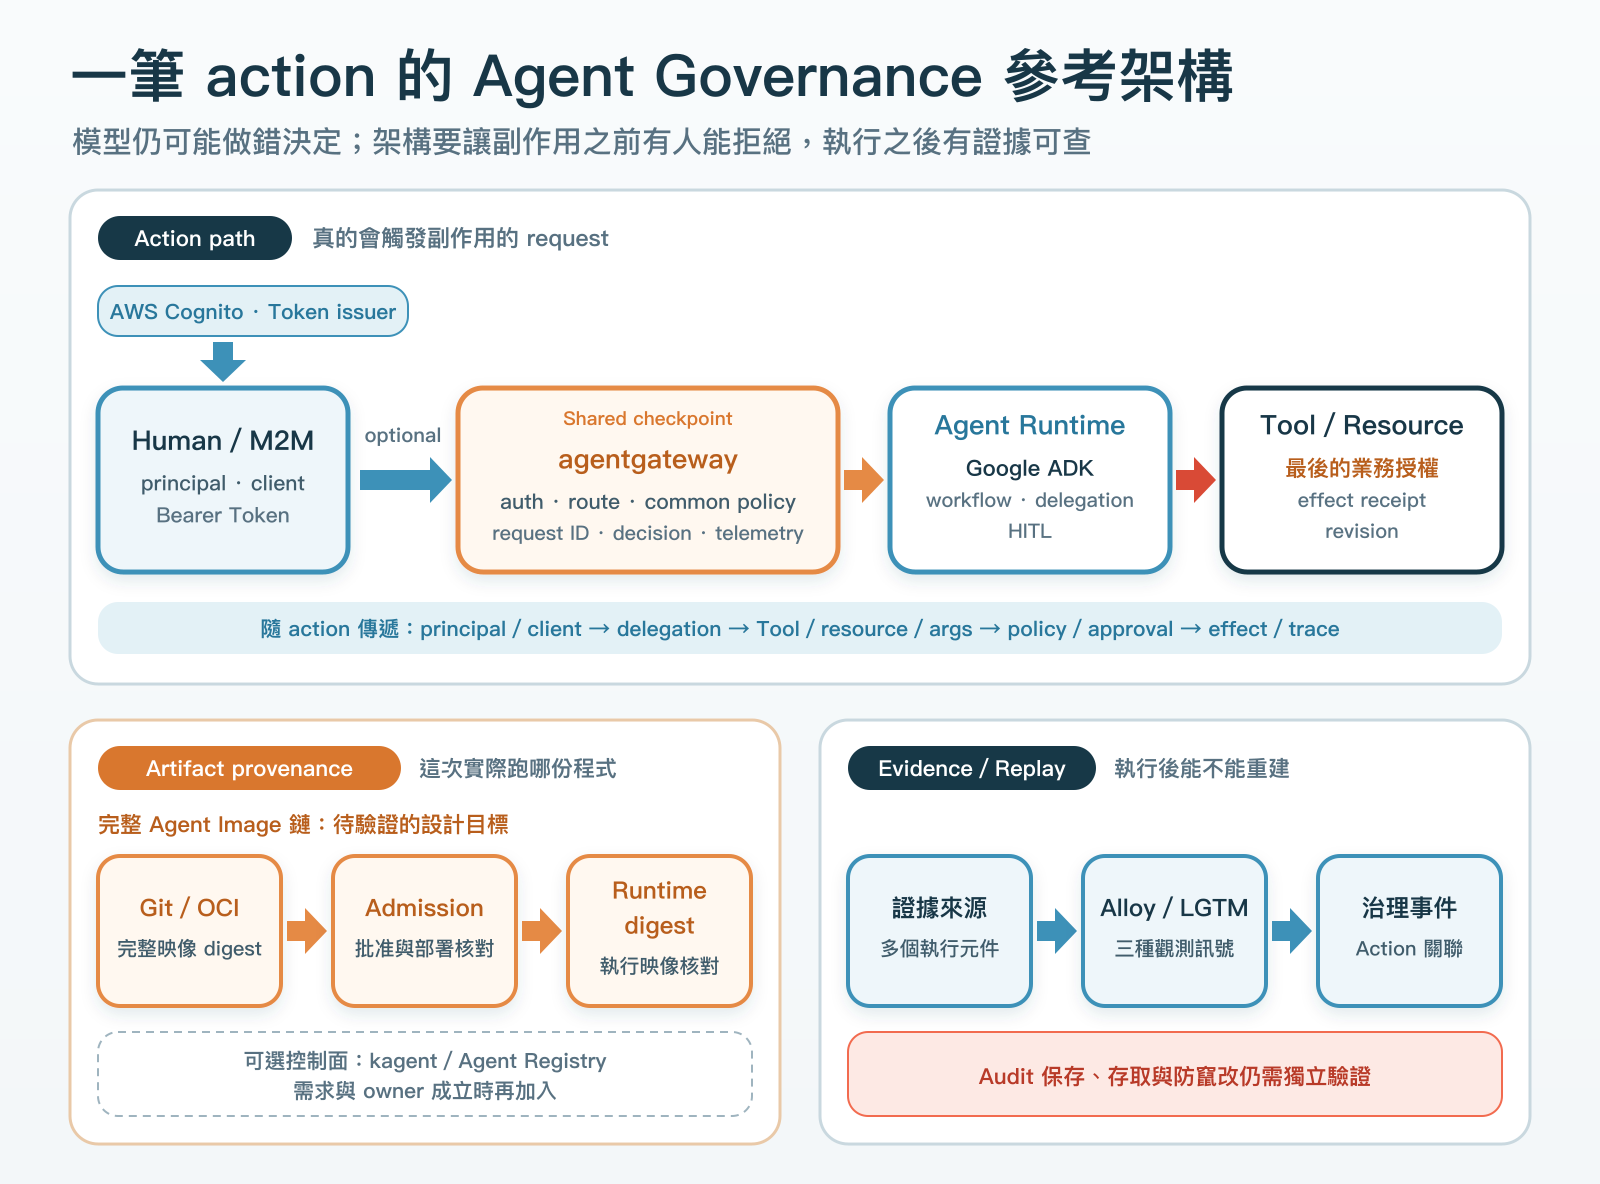
同一筆操作還需要帶著可驗證的脈絡往下走。入口的 Caller、Runtime 的工具與參數、資源端的結果,不能只因為放在同一個 JSON 就視為同等可信。每個位置都要說明自己提供什麼、根據什麼來源,再用 ID 關聯。
Human 和 M2M 先走各自的登入或取 Token 流程。Cognito 在本系列提供這兩種入口,簽發完成後就退出業務資料路徑,Agent 每次查工具並不需要讓請求穿過 IdP。讀者也可以沿用組織已有的身分系統。
Token 到達服務入口,才驗證簽章、Issuer、Audience 和有效時間。這一步確認憑證可被此服務接受。登入者的角色、服務 Client 和實際執行 Workload 仍是不同身分,若下游政策需要知道是哪個工作負載,還要有相應的可驗證憑證。
既有 Ingress 可以留在外層處理 TLS 和 Host Routing。agentgateway 作為多個 Runtime 的共同入口,處理已配置的認證、路由、流量政策和觀測。兩層分清等待、重試與 Header 處理,才能避免一次 Agent 串流被外層設定意外改變。
Gateway 可以拒絕不符合共同規則的請求,但特定工單允許修改哪個資料庫,需要理解該資源的服務決定。共同入口與資源端各守自己的規則,這一點比把所有判斷都放進單一產品更重要。
Google ADK Runtime 保留工作流程、狀態、工具介面、參數處理和暫停恢復。模型提出工具後,Runtime 可以先將參數轉成一致形式,再按應用規則檢查。外部 Log、網頁或工具輸出可以提供線索,是否要取得動作權限,仍由這條執行路徑決定。
資源服務則以自己掌握的目標與權限作最後判斷。刪除資料需要檢查環境和範圍,查 Logs 需要限制資料來源,部署需要確認可接受的版本和目標。這些例子有不同的業務語意,Gateway 的入口放行不能代替所有判斷。
正式設計時,可以將工單範圍與正規化參數交到授權點,再留下 Policy Version 和決定。下游不應只相信上游自行宣告 authorized=true,而要有明確的信任來源與資料契約。哪些欄位由 Runtime 提供、哪些由資源服務驗證,必須在接線時說清楚。
若需要人工決定,Runtime 先固定待執行內容並暫停,由對這個資源有權的人批准。恢復前再核對目標、參數、產物和規則版本,內容改變時原決定失效。Day 18 已驗證部分 BYO Pause/Resume 路徑,正式批准者認證、授權與完整動作綁定仍是待驗證設計。
入口提供身分確認與路由決策,Runtime 記工具提議、參數與執行產物,資源端補結果。Action ID 關聯同一個操作,Trace ID 指向執行路徑,事件本身再保存資料來源,調查者才能分清每一站知道什麼。
例如 Runtime 說工具成功,資源端只回報已接受工作,事件就應保留「已接受」而不是直接寫成完成修改。若 Policy 已拒絕,則不用替沒有執行的工具補一份效果收據。這些結果差異在 Day 20 和 Day 26 已形成欄位與回放方法。
這條脈絡是本系列的資料設計,不是產品裝完後自動生成的完整上下文。組織接入時仍要定義哪些欄位可信、如何傳遞與覆寫,以及缺少關鍵資料時怎麼處理。關聯 ID 可以幫忙找紀錄,不能取代身分或批准驗證。
工程師改 Agent 程式,交付流程可以記 PR、Commit、建置結果和完整映像 Digest。部署再選定這份產物,執行事件記下實際使用的版本。這樣調查某次工具操作時,才能從結果回到產生它的程式和設定。
Tag 只是名稱,可能改指向。Day 19 的 approved Catalog Tag 實測可以換 Image Reference,提醒我們批准紀錄需要綁內容。Day 18 鎖定的是 BYO 基底映像,也不能直接當成完整 Agent Image 的來源鏈。
因此參考架構把完整產物的 Digest、批准和部署核對列為設計目標。公開 Lab 尚未完成所有 Admission 和每個 Workload 的執行映像綁定,事件調查需要保留這個缺口。只知道某個版本曾發布,仍不能證明某次請求跑的就是它。
kagent 和 Agent Registry 位於這條交付與平台操作路徑,適合在共享部署、發現或目錄需求成立後評估。它們不會替每筆工具請求確認業務意圖。Git-owned BYO Runtime 也可以是正式選擇,只要交付、執行和維護責任清楚。
既有 LGTM 提供 Logs、Metrics 和 Traces 的查詢。Gateway、Runtime 和工具端各自送出所見資料,Alloy 收集與轉送。日常可以先看錯誤趨勢,再展開 Trace,最後查事件內容,分辨入口拒絕、下游失敗或結果不足。
Day 25 已讓 SRE Agent 經 Grafana MCP 真正查到 Loki,並保留 Action ID 和 Trace ID。Day 26 另送一筆新請求,查到跨四個服務的 Trace 和相關事件。這些結果支持現行管線的查詢能力,舊事件的 Principal、執行產物和批准缺口仍然不能由新資料補造。
我會讓設定變更回 Git 查,單次執行回 Gateway、Runtime 和 LGTM 查,再核對實際產物。當工具結果只剩一段摘要,或關聯欄位在中間被丟掉,模型仍可能寫出像樣的回答,值班者卻失去下一步查證入口。因此資料是否能一路保留,也要和工具功能一起驗收。
如果保存目的超出日常維運,例如需要特定保存期限或防刪改,則由對應角色確認事件來源、存取權限和儲存方式。LGTM 能查到紀錄,不會自動證明紀錄沒有缺漏或從未被修改。這項差別要按實際要求處理,不能由完整 Waterfall 代替。
去年寫 LLM Observability 時,我關心模型為什麼這樣回答、一次呼叫用了多少 Token,以及輸入、輸出和耗時能不能對回來。今年把工具接上後,需要再問誰讓它做、它代表誰、跑哪份程式,以及哪一層有權拒絕。
讀者可以從自己的一個工具開始,先畫它的請求與資料來源,再畫程式如何交付、執行紀錄存在哪裡。查詢工具先檢查資料範圍與結果,修改工具再補目標授權和必要批准,多個 Runtime 的共同工作才交給平台收斂。這個方法可以使用現有產品,不需要照抄我們的選型。
這三十天也有幾次跑通後仍未採用的決定。Keycloak、kagent 和 Registry 都各有能解決的工作,但需求範圍與長期維護者是否成立,會改變採用方式。我會讓每段工作都有能理解、能維護的人,也有出問題時可以核對的資料,再決定產品怎麼接進來。
回到最初那段混著指令的 Log,Agent 仍可能提出刪除工具。我希望後續不同的是,它在接觸正式資源以前,會遇到能理解這次目標與參數的授權檢查。若獲准執行,結果能對回批准、規則和實際版本。有些控制已有實測,有些還保留明確缺口,這讓我們能在開放真正副作用以前,知道下一次應該驗證什麼。
最初的 Canary 最後沒有變成一場真實資料庫事故。它留下的價值,是讓「模型提出了什麼」一路延伸成「系統允許了什麼,資源做了什麼,我們又能查證什麼」。這條路清楚之後,工具和平台可以繼續演進,責任與證據也有位置可以接下去。



 iThome鐵人賽
 看影片追技術