
昨天我們把畫面上的東西講清楚了。今天要打開畫面背後的東西:資料。
先看 AI 目前寫給我們的版本,點開其中一張專輯的詳情,會發現「發行版本」那一排只是幾個標籤,點了沒有反應;下面的內容物,也只有一份。
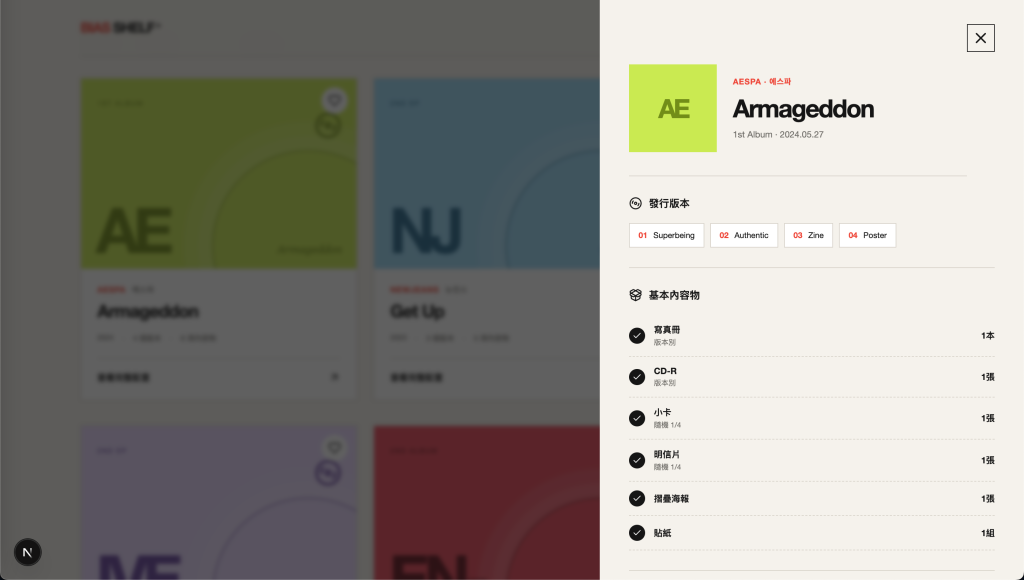
【圖 1|專輯詳情:版本無法點選、內容物只有一種】
照這樣看,會以為不管買哪個版本,拿到的東西都一樣。
但買過專輯的人都知道,這好像有點不太對,因為不同的版本內容物應該不同。但這不是畫面的問題,而是資料本身就是這樣記的。畫面只是老實地把資料的樣子顯示出來而已。
在打開資料之前,先分清楚兩件事:
資料填錯,通常改那一筆就好。模型錯了,會同時牽動所有資料,還有用到這些資料的程式。
今天要檢查的主要是資料模型。
Day 7 請 Codex 用 Next.js 做網站時,它順手生了一份假資料,放在 app/data.ts 裡。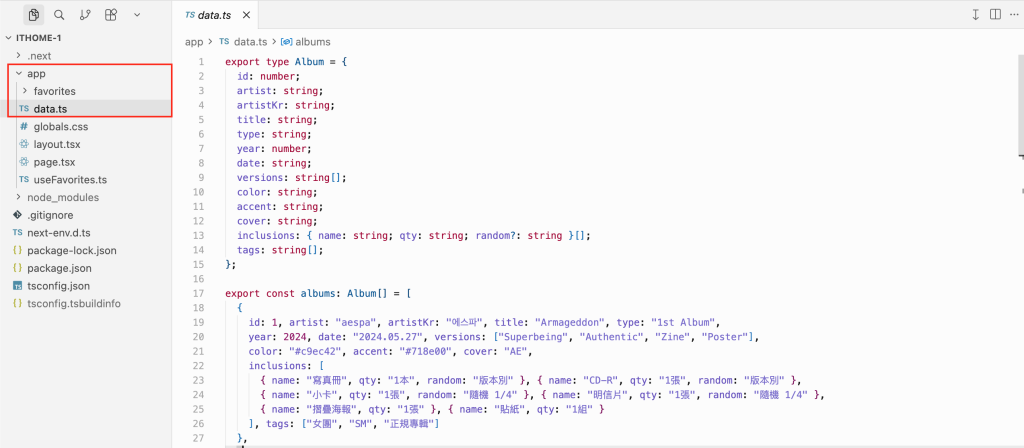
【圖 2|目前生成的資料】
第一次看程式裡的資料,可能會被一堆符號嚇到。其實只要認得幾個就好:
| 符號 | 意思 | 例子 |
|---|---|---|
{ } |
一筆東西,裡面是「欄位: 值」 | { name: "小卡", qty: "1張" } |
[ ] |
一串東西 | ["Superbeing", "Zine"] |
"..." |
文字 | "Get Up" |
| 沒有引號的數字 | 數字 | 2023 |
檔案最上面,先定義了「一張專輯長什麼樣子」:
export type Album = {
  id: number;
  artist: string;
  artistKr: string;
  title: string;
  type: string;
  year: number;
  date: string;
  versions: string[];
  color: string;
  accent: string;
  cover: string;
  inclusions: { name: string; qty: string; random?: string }[];
  tags: string[];
};
這段就是 Day 7 提過的 TypeScript,它是一份說明書,寫著每張專輯要有哪些欄位。
下面是照著說明書填的資料,其中一張長這樣:
{
    id: 1, artist: "aespa", artistKr: "에스파", title: "Armageddon", type: "1st Album",
    year: 2024, date: "2024.05.27", versions: ["Superbeing", "Authentic", "Zine", "Poster"],
    color: "#c9ec42", accent: "#718e00", cover: "AE",
    inclusions: [
      { name: "寫真冊", qty: "1本", random: "版本別" }, { name: "CD-R", qty: "1張", random: "版本別" },
      { name: "小卡", qty: "1張", random: "隨機 1/4" }, { name: "明信片", qty: "1張", random: "隨機 1/4" },
      { name: "摺疊海報", qty: "1張" }, { name: "貼紙", qty: "1組" }
    ], tags: ["女團", "SM", "正規專輯"]
  }
用剛剛的方法讀:這是一張專輯({ }),它有三個版本(versions 資料內容是一串文字)、好幾樣內容物(inclusions 是一串 { }),每樣內容物有名稱、數量,有些還標了「隨機」的方式。
藝人、專輯名稱、發行日期、版本、內容物,該有的好像都有了。如果只看「能不能跑」,這份資料是跑得出來的,但是他與現實不符。
versions(版本)和 inclusions(內容物)是並排的,都直接掛在專輯底下,這代表「那張專輯的內容物」,而不是「某個版本的內容物」。換句話說:這張專輯不管哪個版本,內容物都一樣。 這就是引言裡,畫面只顯示一份內容物的原因。
有趣的是,資料裡其實已經露了餡。看 aespa 那張:
{ name: "寫真冊", qty: "1本", random: "版本別" }
旁邊標了「版本別」,意思是「每個版本的寫真冊不一樣」。但也就只有這樣了。它告訴你「每個版本不一樣」,卻沒辦法告訴你 Superbeing 版的寫真冊是哪一本、Zine 版又是哪一本。
所以內容物應該掛在 版本 底下,不是專輯底下。
再看那個 random 欄位,把所有專輯裡出現過的值列出來:
| 值 | 實際意思 |
|---|---|
"版本別" |
每個版本不同 |
"版本別套組" |
每個版本附一整組 |
"成員別" |
每位成員各一款 |
"隨機 1/4" |
4 款裡隨機抽 1 張 |
四種完全不同的意思,全擠在同一個欄位裡。
這時候如果想做「只看小卡超過 5 款的專輯」這種篩選,就做不到了:程式讀不懂「隨機 1/4」,它只看到一串字。
qty: "1本"
數量被寫成了文字。「1本」「3張」「1組」看起來很自然,但程式沒辦法拿來計算或比大小。數字應該是數字,單位另外記的話,會比較方便比大笑。
year: 2024, date: "2024.05.27"
年份其實可以從日期看出來,卻另外存了一份。現在兩個是一致的,但只要哪天有人改了其中一個、忘了另一個,就會出現「2024 年發行、日期卻是 2023 年」的資料。
能從同一個地方穩定推得出來的資料,通常可以不要重複存。因為重複得越多,就越容易對不起來;或是說修改的時候漏掉地方沒有改。
tags: ["女團", "SM", "正規專輯"]
這三個標籤,其實是三種完全不同的東西:
type: "1st Album" 重複了全部混在一起,程式就分不出哪個是哪個。如果想做「只看 SM 公司的專輯」,只能在一串標籤裡碰運氣。
這跟 3.2 其實是同一個毛病:一個欄位同時扛了好幾種意思。
另外,artistKr: "에스파" 也有類似的問題:aespa 如果有十張專輯,「에스파」就要寫十次。
這些問題有一個共同點:AI 沒有寫出不能跑的程式碼,只是他可能沒有考慮到這件事。
因為當初的提示詞並沒有叫他考慮這件事。你只有說做一個可以查詢的網站而已。沒有提醒它確認資料模型,以及每個版本內容物的種類、數量都有可能不同。
它做出了一份「看起來像專輯配置資料」的東西,但一張專輯到底怎麼組成、哪些東西會隨版本改變、「隨機」到底有幾種 —— 這些事,他可能知道,但你沒有叫他確認。
AI 生的配置內容本身也可能是錯的,它有可能是自己編的。拿來開發、測試畫面沒問題,但絕對不能當成真的資料上線。
問題列完了,那該怎麼改?其實只要一直問同一個問題:
這個欄位,是誰的?
| 欄位 | 屬於誰 | 原本放在 |
|---|---|---|
| 發行日期 | 專輯 | date,另外還重複存了 year |
| 專輯類型 | 專輯 | type 和 tags 各寫一次 |
| 內容物 | 版本 | 專輯底下 |
| 韓文名 | 藝人 | 每張專輯各寫一次 |
| 經紀公司 | 藝人 | tags |
| 團體類型(女團、男團、Solo) | 藝人 | tags |
第三節的問題,大部分都是同一個原因:**東西放錯了主人。**內容物是版本的,卻放在專輯底下;經紀公司是藝人的,卻塞進專輯的 tags。歸位之後,很多問題就自然消失了。
照這個問題整理下來,專輯本身會是這樣:
專輯
└── 版本
    └── 內容物
一張專輯有好幾個版本,一個版本又有好幾樣內容物;反過來,每個版本只屬於一張專輯。這種「一個對好幾個」的關係,叫做一對多。
藝人和專輯的關係就不一樣了。
一位藝人會出很多張專輯;而如果是合作專輯,一張專輯也會有好幾位藝人。兩邊都是「好幾個」,這叫多對多。
這兩種關係,在資料裡的寫法也不同。目前可以先用一個很好用的判斷方式:
只屬於它的,先包在裡面;會被很多地方共用、改的時候要一起改的,可以獨立出來,用編號指過去。
這樣「에스파」和「SM」只要寫一次。哪天要改,也只要改一個地方。
這並不是 K-POP 專輯的特殊問題。剛剛對專輯做的事情,其實有三步:找出有哪些「東西」 → 決定每個東西有哪些欄位 → 想清楚它們彼此怎麼連。換個產品,可以用一樣的步驟跑一次。
一筆記帳紀錄,大概長這樣:
一筆紀錄
├─ 性質:支出
├─ 分類:餐飲
├─ 金額:120
├─ 帳戶:現金
└─ 日期
如果這個 App 只做「記一筆收支」,這樣其實就夠了,市面上很多記帳軟體也差不多是這樣。但如果要加上轉帳的功能,就會發現它裝不下:你從銀行領了三千塊現金——這不是支出,也不是收入,錢還在你身上,只是換了地方。而且它同時動到兩個帳戶,但上面只有一個「帳戶」欄位。
再往下,預算、定期帳單、資產管理⋯⋯每加一個功能,模型就很有可能需要去擴充欄位。
所以不是一開始就要把資料設計完,而是先把現在真的要做的功能講清楚。
一份菜單品項,大概會有這些:
餐點
├─ 名稱:珍珠奶茶
├─ 分類:飲料
├─ 價格:60
├─ 大小:大杯 / 小杯
└─ 可加料:珍珠、椰果
看起來很合理。但「大小」那一行,值得多看一眼。如果大小只是顯示「大杯/小杯」,一個欄位就夠了。但當不同大小開始有自己的價格、自己能加的料、甚至自己的庫存——它就不再適合當一個欄位,而是餐點底下的一層。
這跟 3.1 是同一件事:
餐點 → 規格(大杯/小杯)→ 各自的價格
專輯 → 版本(Superbeing/Zine)→ 各自的內容物
非常類似的形狀。
還有一件專輯沒有的事。顧客點餐之後會產生訂單:
訂單
└─ 明細
   ├─ 點了哪道菜
   ├─ 幾份
   ├─ 什麼規格
   └─ 加了什麼料
而明細如果只記「哪道菜的編號」,價格去菜單查,那下個月餐廳漲價,你上個月的訂單金額也會跟著變。所以訂單要把當時的品名和價格複製一份存下來。
這跟第四節說的「共用的用編號指過去」剛好相反。但它不是推翻,而是補上另一種情況:
如果你要保存的是「當時的樣子」,重複存一份反而是必要的。
同樣一套問法,換領域都適用。順帶一提,這件事有個名字,叫做資料建模,是系統設計最前面的一步。它不用寫程式,但後面的資料庫、API、畫面,全都是照這一步長出來的。
這套問題不只適用於專輯。換到任何領域,都可以這樣檢查。
看到這裡,有些人可能會覺得:這些我怎麼可能自己想得到?感覺一定很容易漏掉一些什麼。其實不一調要自己想。你可以先跟 AI 聊一輪再開始。但差別在你跟它說了什麼。如果只說「幫我設計專輯的資料結構」,拿到的大概就是 Day 7 那一份:能跑、看起來合理,但不懂專輯。我通常會利用幾種方法:
一、先餵它領域事實,再請它設計
同一張專輯有好幾個版本,每個版本的內容物不一樣;小卡是幾款裡隨機抽幾張。請依照這些,提出一個資料模型。
這幾句就是第三、四節的結論。AI 可能知道很多 K-POP 的事,但它不知道這個產品要把哪些差異當成資料,除非我告訴它。
二、請它挑自己的毛病
這個結構在哪些情況下會裝不下?舉幾個我之後可能會遇到、但現在寫不進去的狀況。
這樣它會自己講出轉帳、漲價這類問題,你不用是老手才想得到。
三、請它幫你劃範圍
以我現在要做的功能來說,哪些欄位是必要的?哪些可以之後再加?
AI 可以提模型、找反例、比較做法。而我要做的,是把真實的需求補進去,最後確認這個模型符合我要做的產品。
我個人認為,這段對話越早越好。Day 7 那句「幫我做一個網站」,它連資料都一起生了;等到 25 張假資料和畫面都做出來,再回頭改模型,成本可能就不一樣了。
想清楚了,接下來換 AI 寫。
第二節那段 type Album 就是型別:「這個欄位應該放什麼」的說明書。待會會看到新的版本,先認得這幾個就夠:
| 型別 | 意思 | 例子 |
|---|---|---|
string |
文字 | 專輯名稱 |
number |
數字 | 小卡張數 |
boolean |
是或否 | 是否附海報 |
Version[] |
一串版本 | 一張專輯的所有版本 |
? |
可以不填 | 不是每樣東西都是隨機的 |
以下是我後來給Codex 的Prompt:
我剛剛發現,專輯詳情之中,我的版本是沒有辦法點擊的,而且根據資料型別,你的內容物好像是掛在專輯你下而不是版本?以下是我想請你重新設計專輯資料的型別,並照新型別重整所有假資料:
- 內容物改掛在各個版本底下,不同版本的內容物可以不同
- 隨機的內容物拆成「幾張」和「從幾款中隨機」兩個數字
- 數量的數字和單位分開
- 藝人獨立成一份清單,韓文名、經紀公司、團體類型放在藝人底下,專輯只記藝人編號(一張專輯只有一位藝人)
- 移除 year,日期只留一個欄位,格式改為 2024-05-27
- 專輯類型只保留一個欄位,不要同時放在 tags 裡
- 每張專輯加上網址用的 slug:英文小寫、數字和連字號,例如 `seventeen-17-is-right-here`,不可重複
- 所有假資料集中放在同一個檔案
- 專輯詳情裡點選不同版本時,內容物要跟著切換
你認為這些建議怎麼樣?我是否有漏掉什麼?或是你有沒有什麼更好的建議?先幫我分析,還不用實作。
一樣維持我個人的習慣,不會請他直接動手,而是先分析、給建議。
他並沒有全盤接收,同時也補充了一些他覺得可以調整的地方,包含: 1. 不只專輯需要穩定 ID、2. 日期欄位最好叫 releaseDate、 3. albumType 建議限制選項、4. 藝人類型不只團體與 Solo、5. agency 未必永遠只有一個。同時,在他實作之前,我們也來回確認了幾輪。
export type ArtistType = "girl-group" | "boy-group" | "mixed-group" | "solo" | "subunit";
export type AlbumType  = "single-album" | "ep" | "studio-album" | "repackage" | "compilation" | "special-album";
export type AlbumFormat = "cd" | "platform" | "vinyl";

export type Artist = {
  id: string; name: string; koreanName: string;
  agency: string; type: ArtistType;
};

export type Inclusion = {
  id: string; name: string;
  quantity: number; unit: string;
  randomFrom?: number;
};

export type AlbumVersion = {
  id: string; name: string;
  format: AlbumFormat;
  designs?: { id: string; name: string }[];
  inclusions: Inclusion[];
};

export type Album = {
  id: string; slug: string; artistId: string;
  title: string; albumType: AlbumType; releaseDate: string;
  versions: AlbumVersion[];
  color: string; accent: string; cover: string;
  tags: string[];
  sourceUrls?: string[];
};
資料的部分,以 aespa 的《Armageddon》為例(節錄):
album("armageddon", "aespa-armageddon", "aespa", "Armageddon", "studio-album", "2024-05-27", [
  version("authentic",  "Authentic Ver.",  "cd", standard(4)),
  version("superbeing", "Superbeing Ver.", "cd", standard(4), m4),
  version("smini",      "SMini Ver.",      "platform", compact(4), m4),
  version("lp",         "LP Ver.",         "vinyl", [
    { id: "vinyl", name: "黑膠唱片", quantity: 2, unit: "張" },
    ...
  ]),
], ...)
每個版本都有自己的一份內容物了。
東西拿到了,別急著相信。把第三節那五個問題拿出來對:
| 第三節的問題 | 結果 |
|---|---|
| 3.1 內容物掛在專輯底下 | ✅ 搬進 AlbumVersion 了,每個版本各一份 |
3.2 random 一個欄位四種意思 |
✅ 只剩 randomFrom 記款數,其他三種被結構本身解決了 |
| 3.3 數字和單位黏在一起 | ✅ 拆成 quantity 和 unit |
3.4 year 和 date 記兩次 |
✅ 只留 releaseDate,而且格式統一成 YYYYYYYY-MM-DD |
| 3.5 tags 什麼都塞 | ⚠️ 算改了一半 |
他有改完型別了,但是有一些資料是跟現實的不符合的。這也會是之後要處理的事情。
回到引言那個畫面:現在版本可以點了,並且點不同的版本,內容物跟著改變。
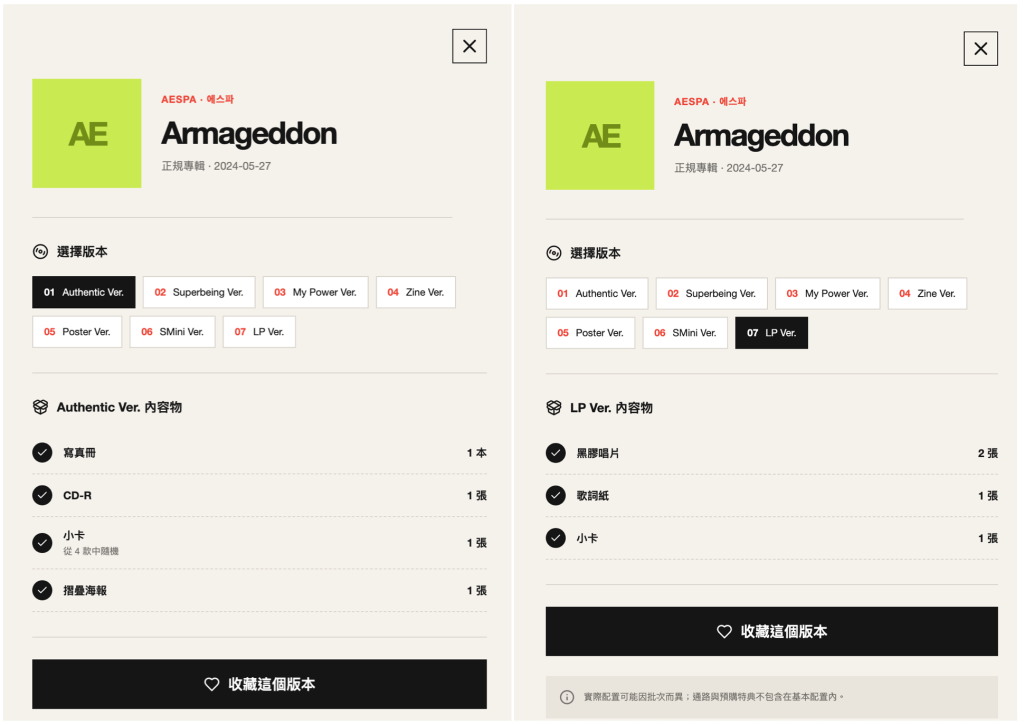
【圖 3|點選不同版本,內容物跟著改變】
畫面只多了一個小小的互動,但底下的資料模型已經整個換過了。
今天沒有加什麼大功能,但資料模型已經換過了。
這種事情,越早確認越省事。現在只有幾筆假資料,改起來相對容易一些;等之後接上資料庫、累積真的資料,再發現模型不對,牽動的地方就會多很多。
回頭看,Day 7 那份資料其實能跑、也很合理。只是當時很多領域規則沒有講清楚,AI 就只能自己補答案。
越早把重要規則講清楚,AI 就越少需要自己猜。
這不代表資料模型都要自己想。你可以先跟 AI 討論、請它提案、找反例,再一起收斂。
但這時候還有一個問題,如果我想將某一張專輯複製給朋友看,是沒辦法的。因為在點擊某張專輯的某個版本的時候,網址都和原本的一樣,這是明天要處理的事情,明天,我們會讓每張專輯有自己的網址。
明天見。


 iThome鐵人賽
 看影片追技術