
在 AI 的時代,越來越多人可以透過 Vibe Coding,替自己生活中的小麻煩做出一個解法,不一定要先成為工程師。
搜輯 Biashelf 也是這樣開始的。在專輯店買專輯的時候,我常常想查一張專輯有哪些版本、裡面附了什麼,卻總要翻好幾個網站。於是我想:來做一個吧。
做出一個能跑的版本,其實不用太久;但要讓它真的上線、讓別人用、出事時知道、還養得起,中間還有很多事。28 天後,它有了網域、登入、權限、測試和監控,也開始想怎麼養活自己。
今天我們要把這些分散的篇章進行總整理,看看除了工具之外,還有什麼值得帶走的。
AI 很會完成我們說出口的需求,但它不一定知道我們沒說出口的未來。叫它做一個專輯網站,它很快就能做出一個能跑的版本;但每張專輯要有自己的網址、要能登入收藏、要被搜尋引擎找到,這些如果沒說,它不一定會先想到。
能跑跟能長大是兩件事,能用跟好用也是。在 localhost 裡,網站只要能跑就好;公開之後,它開始需要更多東西:
| 領域 | 在解決什麼問題 |
|---|---|
| 工具與協作 | 用什麼工具?要做什麼?AI 可以決定多少? |
| 前端與互動 | 網站怎麼運作?使用者怎麼看到、操作、分享? |
| 資料與後端 | 資料怎麼存、怎麼交換、怎麼驗證? |
| 身分與權限 | 你是誰?你能做什麼? |
| 上線與品質 | 怎麼部署、收發信、測試,避免改壞? |
| 營運與成長 | 怎麼被找到、看見問題、養得起? |
有些觀念不特別屬於哪一個領域,而是在不同的天數裡,用不同的樣子反覆出現:
先搞清楚誰說了算
同一個狀態,可以存在網址、瀏覽器、快取和資料庫裡,但重要的事只能有一個最後的答案。搜尋條件以網址為準(Day 11);快取只是暫存,真正的資料在資料庫(Day 22);付款成功頁不算數,驗證過的金流通知和資料庫裡的訂單狀態才算(Day 28)。
重要規則不能只靠前端守住
前端負責讓事情變得好用;不能交給使用者自己決定的事,要留在可信任的一側。送進來的資料(Day 17)、誰能看哪些資料(Day 19)、誰是管理員(Day 21)、使用者被導回哪個網址(Day 26),都要在伺服器或資料庫再檢查一次。至於篩選條件、要不要打開一個視窗,交給前端就好。
問題修好,留下防線
AI 可以幫我們檢查一次,但能自動化的檢查,盡量寫成測試、放進 CI,才不需要每次人工測試(Day 25)。Day 27 監控網站的錯誤,則是在驗證另一種防線:真的出事時,我會不會知道。
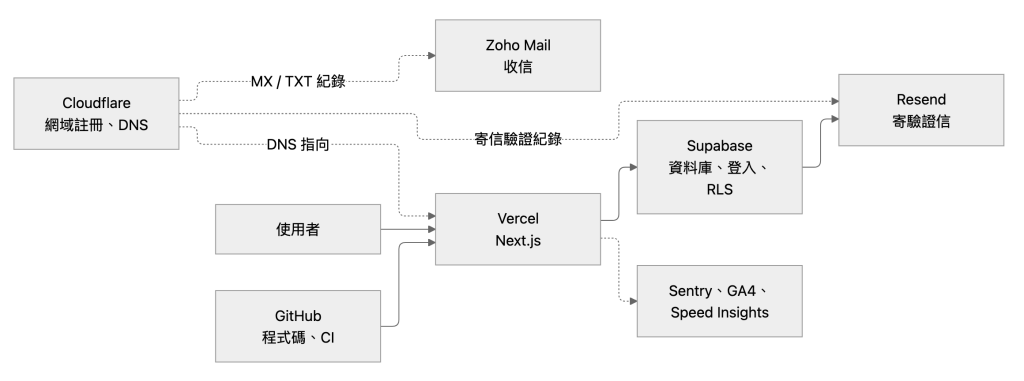
【圖 1|搜輯 Biashelf 的整體架構】
一個「能上線的網站」,背後通常會包含這些零件:放程式的地方、放資料的地方、讓人找得到的網域、寄信收信的服務、上線前自動檢查的流程,以及上線後看得見問題的監控。
把這 28 天的重點,整理成一份清單。下次做自己的專案時,可以拿來對照、思考:
規劃與協作
前端
後端與資料庫
部署
NEXT_PUBLIC_,也沒有 commit 進 repo(Day 23、26)資安
營運
這份清單只涵蓋系列裡提到的部分;功能越多,要確認的事情通常也會跟著增加。
不管是修 404、設 RLS,還是處理資安報告,做事的步驟其實都差不多:
| 步驟 | 在做什麼 | 例子 |
|---|---|---|
| 察覺 | 發現「好像怪怪的」 | 傳出去的網址只會回到首頁(Day 10);自己看頁面正常,爬蟲卻看不到內容 |
| 描述 | 把現象說清楚。越能指出問題在哪,AI 越少需要自己猜 | 「這邊怪怪的」要說清楚在哪、怎麼怪(Day 8) |
| 盤點 | 先讓 AI 調查、列出選項,不急著改 | 讓兩個 AI 各審一次資安問題(Day 26);先盤點快取再決定 |
| 判斷 | AI 很擅長產生選項,選哪個還是自己的工作 | 三個 AI 做出三種設計(Day 14);race condition 要不要修?(Day 26) |
| 實作 | 範圍說清楚,再交給 AI 動手 | 大改之前先開分支(Day 13) |
| 驗證 | 不只聽 AI 說「改好了」,自己確認 | 換別的帳號測 RLS(Day 19);實際看伺服器怎麼回應,而不是看程式被叫什麼名字(Day 20) |
| 留下 | 把這次的問題變成測試、型別或 CI | 把檢查放進 CI(Day 25);修正後補上測試(Day 26) |
這不是固定的 SOP,而是我在利用 Vibe Coding 開發時很常走的一個循環。
這七步裡,AI 最能幫上忙的是盤點和實作:它可以很快讀完整個專案、列出選項、寫出程式碼和測試。
AI 也可以參與判斷和驗證,但這兩步不能完全交給 AI。Day 26 讓兩個 AI 審同一份程式碼,一個找到 open redirect、另一個漏掉,對同一個問題的嚴重程度也判斷不同。問過 AI,不等於檢查過;名詞也一樣,它能幫我們找方向,但不能拿來當作結果正確的證據。
另外想補充的是,文章中示範的做法並不是唯一的答案。 就像網址的設計,/search/aespa 和 /search?q=aespa 都可以, 重點不是哪個方法正確,而是哪一種比較適合,並且知道自己為什麼這樣選。 還有像是要先做畫面還是先設計資料庫、用哪個框架、選哪家服務,也都是同樣的道理,並沒有絕對的答案,選適合需求、自己也好上手的就好。
程式語言的語法,可以交給 AI;但如果連自己做的東西大概長什麼樣子都不知道,就很難判斷功能該放哪裡、哪些地方有風險。AI 大幅降低了上手的成本,但判斷的成本並沒有跟著消失。
而且很多技術,不一定要會從零做出來,但至少要知道它為什麼存在:
| 不一定要會 | 但要知道 |
|---|---|
| 自己寫登入系統 | 登入和權限是兩件事 |
| 手寫 RLS 規則 | 畫面上看不到,不代表真的拿不到 |
| 設計資料庫的每個細節 | 資料表怎麼分、怎麼擋掉錯誤的資料、怎麼查得快,是不同的問題 |
| 自己做簽章驗證 | 付款通知不能收到就相信,要驗證來源 |
| 搞懂渲染的所有細節 | 爬蟲和社群預覽看到的,可能跟你看到的不一樣 |
| 背下所有資安漏洞 | 哪一側可以信任,哪些輸入不能相信 |
| 自己寫測試工具 | 想清楚「我要證明什麼沒有壞」 |
AI 通常知道怎麼做,但要我們先知道該問什麼,它才幫得上忙。
前 28 天不是網站或產品開發的全部,而是把一個產品從零帶到線上的主要路徑。下面這些主題,依照「什麼時候會需要」分成四類:
就像網站有很多種框架,開發 App 也可以選原生的 Swift(iOS)、Kotlin(Android),或跨平台的 Flutter、React Native。開發完要上架,也要先通過 App Store、Google Play 各自的審核。
以往開發 App,通常要找熟悉該語言的工程師;有了 AI,這個門檻低了很多,比較關鍵的反而變成:你知不知道問題在哪、要注意什麼、要怎麼取捨。
這個系列一直在用 AI 寫程式,但 Biashelf 本身沒有用到 AI 功能。不過在 Vibe Coding 的產品裡,AI 功能是很多人會想加的,例如 AI 客服、依學生的觀看紀錄推薦課程,或例如讓使用者可以輸入「aespa 有哪些專輯附海報」來進行自然語言搜尋。
這類功能通常要串接 AI 的 API(如 Claude API、OpenAI API、OpenRouter),用多少付多少,所以要多想幾件事:用量和成本要設上限;提示注入會從「攻擊幫你寫程式的 AI」變成「攻擊你網站裡的 AI」;回答要以資料庫裡的資料為準,不能讓 AI 自己編;哪些使用者資料真的需要送給 AI,也要先想清楚。
這 28 天用了很多工具,但工具會換、模型能力也會一直增強,今天整理一些我認為相對之下比較不容易過時的內容:四條貫穿全系列的觀念、從察覺到留下的七個步驟,以及一份「不一定要會,但要知道」的清單。
用 AI 開發,重點不是更相信它,而是知道什麼時候可以相信它、怎麼驗證它說的對不對。
明天是最後一天。不談工具,我想聊聊這次的參賽心得;以及在 AI 已經會寫程式的時代,思考、表達和行動,為什麼反而變得更重要。
我們明天見。



 iThome鐵人賽
 看影片追技術