

前言
在 Day 8 的架構規劃中,我們確立了「雙層解耦」的核心原則:前線高頻操作使用內部關聯式資料庫承接,標準交換層則透過 Gateway 映射至 HL7 FHIR。
很多初入醫療資訊領域的工程師常遇到兩難:
1.直接將資料庫設計成 FHIR JSON 儲存庫(Document Store): 雖然寫入時能省去轉換,但在處理「查詢 8 樓病房過去 24 小時發燒病患」、「計算特定班別平均脈搏」、或進行複雜跨表 JOIN 分析時,JSON 查詢的效能與索引成本極高。
2.完全無視標準自訂 Table: 雖然在內部 CRUD 非常直覺,但到了與外部 EMR/FHIR 交換時,欄位語意模糊、型態斷層,導致 Adapter 層寫滿龐大的例外邏輯。
今天我們將以 PostgreSQL 為底層,設計一套兼顧「高頻寫入效能、完整關聯約束(FK Constraints)」以及「與 FHIR Resource 語意 1:1 精確映射」的現代護理資料庫 Schema,並訂定清晰的映射策略。
一、實體關聯模型(ERD)架構規劃
在護理臨床業務中,核心實體環繞著:人員(Staffs)、病患(Patients)、空間床位(Beds)、就醫紀錄(Encounters)、以及高頻產生的生命徵象(Vital Signs)與醫囑執行記錄(Medication Logs)。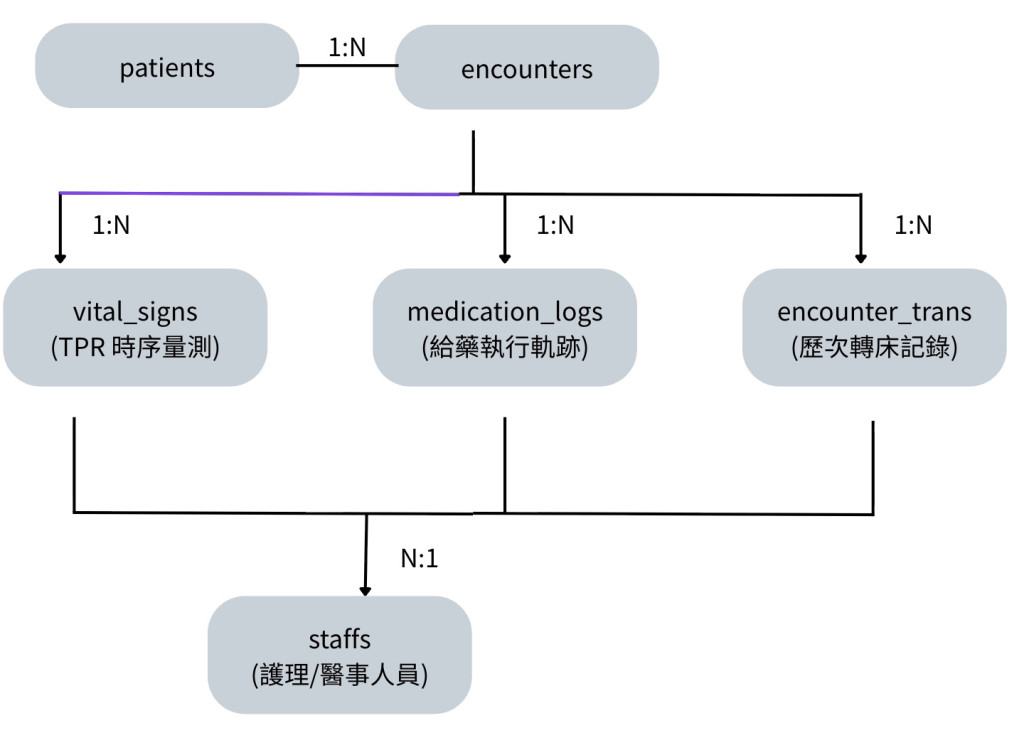
二、PostgreSQL DDL 綱要設計實戰
我們採用 PostgreSQL 15+ 特性,包含原生 UUID、時區感知時間戳記(TIMESTAMPTZ)、檢查約束(CHECK)與複合索引。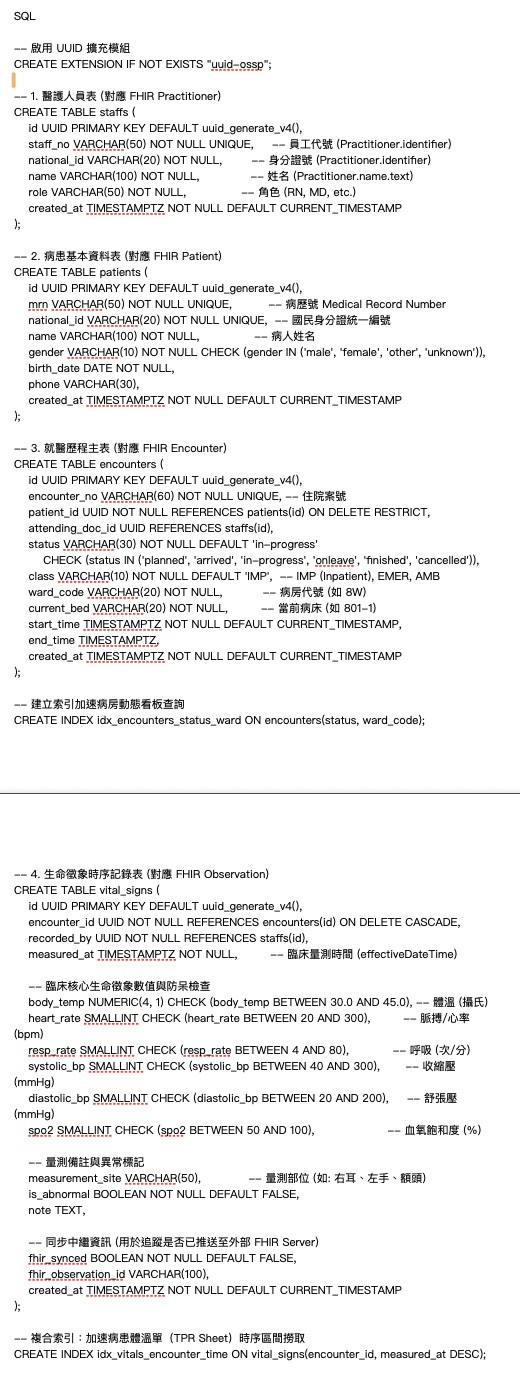
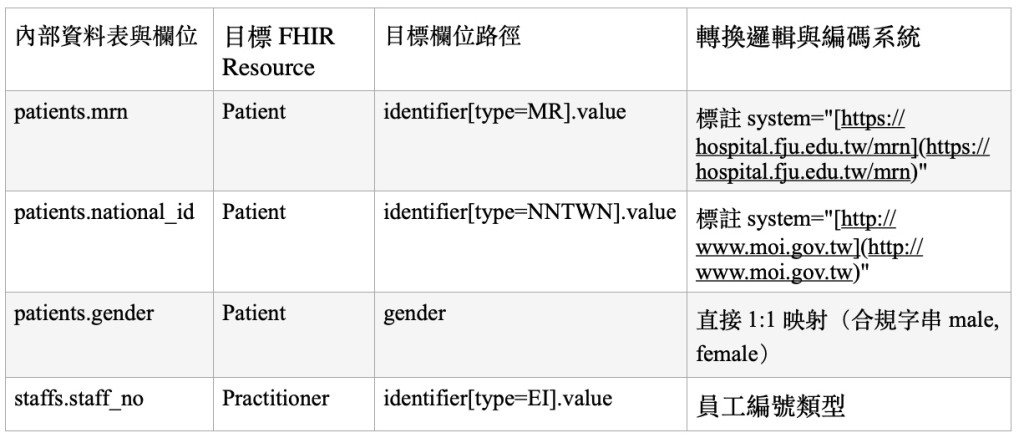
三、關聯式欄位與 FHIR 映射策略
在設計 Adapter 層時,我們需要明確的映射規則矩陣,確保雙向轉換無損:
四、資料同步機制:寫入日誌與雙向一致性
在 vital_signs 表中,我們特別保留了兩個欄位:
-fhir_synced (BOOLEAN):預設為 FALSE。
-fhir_observation_id (VARCHAR):記錄外部 FHIR Server 成功配發的 Resource ID。
同步流程最佳實踐:
1.臨床前線寫入: 行動端送出量測,後端以極快速度(約 5~15ms)將資料寫入 PostgreSQL vital_signs,fhir_synced 初始為 FALSE,立刻回傳 200 OK 給前端。
2.背景排程/事件監聽(Outbox Pattern): 後台非同步 Worker 撈取 fhir_synced = FALSE 的記錄,由 Adapter 轉換為 FHIR JSON POST 至 HAPI FHIR。
3.回寫確認: 接收到 HAPI FHIR 回傳的 201 Created 與 ID 後,更新資料庫: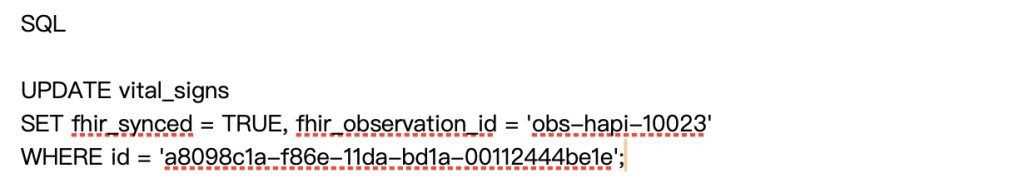
這樣即使 HAPI FHIR 暫時重啟或斷線,前線護理師的量測工作永遠不會受阻,系統會在重連後自動補發。
小結
今天我們為護理資訊系統打下了堅實的資料基石:
1.設計了高規格的 PostgreSQL Schema,包含身分、空間、就醫歷程與時序體徵表。
2.運用 CHECK 約束在資料庫底層設立臨床防呆機制(如體溫 30~45°C 區間限制)。
3.明確了關聯式資料與 FHIR Resources 的映射對照表,並規劃了確保雙向一致性的非同步同步策略。
底層綱要就緒後,明天 Day 11 我們將專注於臨床最具特色的追蹤圖表:生命徵象(TPR Sheet)時序資料收集、臨床防呆驗證與異常警示邏輯!


 iThome鐵人賽
 看影片追技術