
昨天的測試從頭到尾都使用同一個 bge-small-zh-v1.5 模型,但實際上,Hit@1 的分數仍然會隨著 Embedding 模型的選擇而變動,所以今天,我們就來聊聊 Embedding 模型到底該怎麼選,以及一個很多人容易忽略、但少了它可能會讓模型表現大打折扣的關鍵前綴(Prefix),到底該怎麼撰寫。
這篇的完整程式碼一樣會放在 GitHub repo:https://github.com/AUSTIN2526/30-days-ironman-agent,可以直接下載下來執行。
通常挑 Embedding 模型的時候,最容易踩的坑就是直接去排行榜上抓分數最高的那個。但這件事其實不會是最佳解法,因為排行榜的測試資料跟你的文件一定長得完全不一樣,它在他的資料考第一名,不代表搬到你的知識庫也考第一名,所以我自己的習慣是先用下面幾個條件篩掉大部分的選項,把名單縮到三、四個,再拿自己的問題去實測:
| 條件 | 為什麼重要 |
|---|---|
| 語言 | 純中文的知識庫用中文模型通常比多語系模型好,但如果文件裡混著英文技術名詞或產品型號,多語系模型反而比較穩。 |
| 向量維度 | 決定每一塊要佔多少空間,也決定每次搜尋要算多少乘法。 |
| 長度上限 | 超過的部分會被直接截掉,而且不會有任何警告,這個值必須大於你的 chunk_size。 |
| 模型大小 | 影響 Indexing 的時間跟記憶體,也影響能不能放進你的部署環境。 |
| 前綴用法 | 每個模型訓練時的習慣不同,用錯就等於把模型的能力關掉一半。 |
| 授權 | 要商用的話,記得確認模型的 License 允不允許。 |
所以照這個標準,我選出了這四個候選名單,它們剛好各自代表一種取捨:
| 模型 | 維度 | 長度上限 | 定位 |
|---|---|---|---|
BAAI/bge-small-zh-v1.5 |
512 | 512 | 中文,體積小,Day 7 用到現在的預設 |
BAAI/bge-base-zh-v1.5 |
768 | 512 | 中文,同系列的大一號版本 |
intfloat/multilingual-e5-small |
384 | 512 | 多語系,支援上百種語言 |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
384 | 128 | 多語系,主打語意相似度而不是檢索 |
而上述的表格中,維度高不代表模型就比較聰明,但它直接影響你的硬碟空間,假設知識庫有 100 萬個 Chunk,向量用 float32 存,每個數字佔 4 個位元組,就會變成這樣:
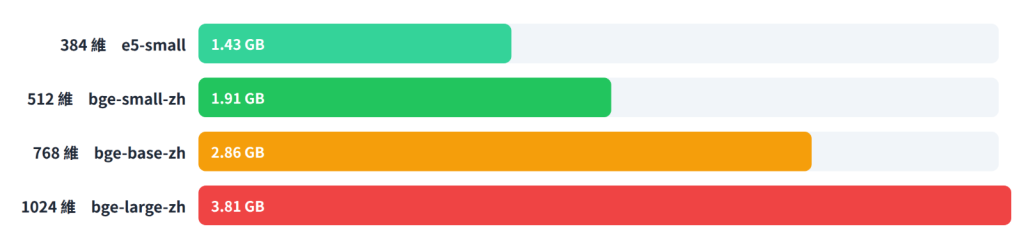
從 384 維換到 1024 維,光是向量本身就從 1.43 GB 變成 3.81 GB,而且還沒算索引結構本身的開銷更有感的是速度,用前面提到的 IndexFlatIP 來說,每次搜尋都要把查詢向量跟庫裡每一個向量算一次內積,維度變成兩倍,每次搜尋的計算量也跟著變成兩倍,當然維度大也有它的好處,能表達的語意細節比較多,碰到刁鑽的問題通常表現更好。
接著是最容易被忽略的長度上限,也就是 MiniLM 那一列的 128,其他三個都是 512,只有它特別小,這代表你要是把 chunk_size 設成 300 個字,丟給它的每一塊都會被默默砍掉後面一大段,後面的文字完全不會被帶入運算。
這裡還有一個新手很容易搞混的地方,就是 Token 和文字字數其實不是同一件事。我們昨天使用 len() 計算的是字元數,但模型真正處理的是 Token,而中文、英文、數字的 Token 切分方式都不一樣。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("BAAI/bge-small-zh-v1.5")
print(model.max_seq_length)                      # 512
print(len(model.tokenizer.encode(chunk)))        # 這一塊實際佔幾個 Token
更重要的是,不同模型使用的 Tokenizer 也可能不同,所以同一段文字在不同模型中,Token 數量可能完全不一樣。因此實際在設定 Chunk 大小時,不能只用 len() 估算,而應該使用模型實際使用的 Tokenizer來計算 Token 數量。
就像 LLM 一樣,有些 Embedding 模型在訓練時也有特定的提示格式。例如 bge 和 e5 都要求在文字前面加上特定前綴,讓模型知道這段文字是用來做檢索的。如果沒有按照模型訓練時的格式加入 Embedding 的效果可能會下降。
麻煩的是每個模型的規則都不一樣。bge 只需要在問題前面加上官方指定的中文指令,文件不需要加;e5 則是問題加 query: 、文件加 passage: ,兩邊的前綴也不同;而 MiniLM 沒有這類前綴,硬加反而可能變成雜訊。因此可以把模型名稱、模型來源以及 query / document 的前綴規則集中寫在同一個設定檔,讓 Indexing 和 Retrieval 都從同一份設定讀取,避免一邊有加、另一邊忘記加的問題。
# models.py
# 每個模型的 query / passage 前綴都不一樣,寫在同一個地方比較不會用錯
CANDIDATES = {
    "bge-small-zh": {
        "repo": "BAAI/bge-small-zh-v1.5",
        "query_prefix": "为这个句子生成表示以用于检索相关文章:",
        "doc_prefix": "",
    },
    "bge-base-zh": {
        "repo": "BAAI/bge-base-zh-v1.5",
        "query_prefix": "为这个句子生成表示以用于检索相关文章:",
        "doc_prefix": "",
    },
    "e5-small": {
        "repo": "intfloat/multilingual-e5-small",
        "query_prefix": "query: ",
        "doc_prefix": "passage: ",
    },
    "minilm-multilingual": {
        "repo": "sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2",
        "query_prefix": "",
        "doc_prefix": "",
    },
}
另外bge 的官方指令是簡體中文,但這是模型訓練時使用的格式,因此應該直接按照官方設定使用,不要自行改成繁體,更重要的是前綴屬於 Embedding 流程的一部分,改變前綴就可能改變產生向量的方式。
如果因此更換了 Embedding 設定,原本建立的索引也應該重新建立,不能只重新計算 Query 的向量,這和前面提到的更換 Embedding 模型就必須重建索引是同樣的概念。
有了設定檔之後,比較的程式就很單純了,這邊我們直接沿用昨天的 markdown_chunk 和同一份員工手冊,讓變因只剩下模型本身:
# benchmark.py
import sys
import time

import faiss
import numpy as np
from sentence_transformers import SentenceTransformer

from models import CANDIDATES

# 直接沿用 Day 8 的切塊程式與知識庫
sys.path.append("../day08-chunking")
from chunkers import markdown_chunk  # noqa: E402

with open("../day08-chunking/handbook.md", encoding="utf-8") as f:
    handbook = f.read()

chunks = markdown_chunk(handbook, chunk_size=100)
接著的 evaluate() 跟昨天幾乎一樣,只多是多幫文件和問題各自加上自己的前綴,並且順便記錄編碼所花的時間,讓我們知道換大模型要付出多少時間。
def evaluate(model, cfg, top_k: int = 3) -> dict:
    # 文件與問題各自加上自己的前綴,這是每個模型訓練時就決定好的用法
    docs = [cfg["doc_prefix"] + c for c in chunks]
    queries = [cfg["query_prefix"] + q for q, _ in test_cases]

    start = time.perf_counter()
    doc_vecs = model.encode(docs, normalize_embeddings=True).astype("float32")
    encode_time = time.perf_counter() - start

    index = faiss.IndexFlatIP(doc_vecs.shape[1])
    index.add(doc_vecs)

    q_vecs = model.encode(queries, normalize_embeddings=True).astype("float32")
    _, indices = index.search(q_vecs, top_k)

    hit1 = hitk = 0
    for (_, answer), idxs in zip(test_cases, indices):
        retrieved = [chunks[i] for i in idxs if i != -1]
        hit1 += answer in retrieved[0]
        hitk += any(answer in c for c in retrieved)

    n = len(test_cases)
    return {
        "dim": doc_vecs.shape[1],
        "params": sum(p.numel() for p in model.parameters()) / 1e6,
        "max_len": model.max_seq_length,
        "encode_time": encode_time,
        "hit1": hit1 / n,
        "hit3": hitk / n,
    }
最後把四個模型輪流跑一次,不過要特別注意每跑完一個就要 del model 從記憶體移出來,不然四個模型會一起佔著記憶體,這時就會發生 OOM 的問題。
if __name__ == "__main__":
    for name, cfg in CANDIDATES.items():
        model = SentenceTransformer(cfg["repo"])
        r = evaluate(model, cfg)
        print(
            f"{name:<22}{r['params']:>9.0f}{r['dim']:>6}{r['max_len']:>9}"
            f"{r['encode_time']:>9.2f}{r['hit1']:>8.0%}{r['hit3']:>8.0%}"
        )
        del model  # 跑完就釋放,不然四個模型會一起佔著記憶體
| 模型 | 參數(M) | 維度 | 長度上限 | 編碼秒數 | Hit@1 | Hit@3 |
|---|---|---|---|---|---|---|
| bge-small-zh | 24 | 512 | 512 | 0.42 | 86% | 100% |
| bge-base-zh | 102 | 768 | 512 | 0.04 | 86% | 100% |
| e5-small | 118 | 384 | 512 | 0.07 | 86% | 100% |
| minilm-multilingual | 118 | 384 | 128 | 0.02 | 100% | 100% |
而我們最終跑完後可以看到它幾乎沒有太大的差別,Hit@3 全都是 100%,Hit@1 也只差一題,這是因為我們的題目太簡單了,7 個 chunk 各自講不同的事,光靠關鍵字就能分辨,這種測試根本壓不出模型的極限。
不過我們注意到 MiniLM,它是唯一拿到 Hit@1 100% 的模型,但在實際用上要小心使用,因為它的長度上限只有 128 個 Token,而我們的 chunk 剛好都在 100 字以內,若文件只要再長一點,它就會開始默默截斷內容,這個滿分也就跟著消失了,而這個評分表只能說明MiniLM在我們的系統中是最有效的而已。
另外我們還要再測試一個前墜對模型造成的影響,其他條件完全一樣:
# prefix_test.py
if __name__ == "__main__":
    for name in ["bge-small-zh", "e5-small"]:
        cfg = CANDIDATES[name]
        model = SentenceTransformer(cfg["repo"])

        without = hit_rate(model, "", "")                               # 兩邊都不加前綴
        with_prefix = hit_rate(model, cfg["query_prefix"], cfg["doc_prefix"])  # 照官方建議加

        print(f"\n{name}")
        print(f"  不加前綴 Hit@1 {without[0]:.0%} Hit@3 {without[1]:.0%}")
        print(f"  加了前綴 Hit@1 {with_prefix[0]:.0%} Hit@3 {with_prefix[1]:.0%}")
        del model
python prefix_test.py
| 模型 | 前綴 | Hit@1 | Hit@3 |
|---|---|---|---|
| bge-small-zh | 照官方加 | 100% | 100% |
| bge-small-zh | 不加 | 86% | 100% |
| e5-small | 照官方加 | 100% | 100% |
| e5-small | 不加 | 86% | 100% |
從這個結果可以看出來,不論是 bge-small-zh 還是 e5-small,只要沒有按照模型官方規則加上前綴,Hit@1 都會從 100% 降到 86%,也就是 7 題中少找到 1 題。不過 Hit@3 仍然維持 100%,代表正確答案雖然不一定排在第一名,但還是有被檢索到前三名之內。
這也說明了前綴不是可有可無的格式,而是 Embedding 模型訓練時就已經學習到的一部分輸入方式。如果沒有按照官方規則使用,模型仍然可以正常產生向量但檢索排名就可能受到影響。
回到最開始的問題,Embedding 模型到底要選哪一個?其實沒有一個模型可以直接適用所有情況,最實際的做法就是選幾個候選模型後直接用自己的文件和問題測試,根據實際的 Hit@1、Hit@3 等結果來決定。
而且不管最後選哪個模型都要記得換模型就必須重建整個索引。不只是模型,切塊策略、前綴、模型這三個設定,只要其中任何一個改變,之前的評估結果就不能直接沿用,必須重新跑一次。
我們現在已經有了不錯的切塊策略,也知道如何選擇 Embedding 模型,但還有一個問題需要解決。IndexFlatIP 採用的是暴力搜尋,每次查詢都必須和資料庫中的每一個向量計算一次內積。資料只有 5 筆時幾乎沒有差別,但如果資料量增加到 100 萬筆,每次查詢就可能需要計算 100 萬次,速度會變得很慢。
因此接下來就要處理向量資料庫與索引結構,看看 IVF、HNSW 等近似最近鄰搜尋方法,如何透過少搜尋一些向量,在可接受的準確度範圍內換取大量的搜尋速度。
那我們明天再見!


 iThome鐵人賽
 看影片追技術