
從 Day 7 到現在我們的搜尋索引一直都是 IndexFlatIP,前面也提到了它的做法是把查詢向量拿去跟庫裡的每一個向量都算一次內積,而這樣就會導致該區塊成為整個系統最慢的一段。
所以今天我們要來處理向量索引,看看 IVF 和 HNSW 這兩種近似最近鄰搜尋(ANN)是怎麼用犧牲一點點準確度,換取大量的查詢速度的
這篇的完整程式碼一樣會放在 GitHub repo:https://github.com/AUSTIN2526/30-days-ironman-agent,可以直接下載下來執行。
在講解決方法之前,我們先看看暴力搜尋的速度到底有多慢,這邊我用 512 維的向量,從 1 萬筆一路測到 40 萬筆,每次都是單筆查詢、取前 10 名,測出來的延遲長這樣: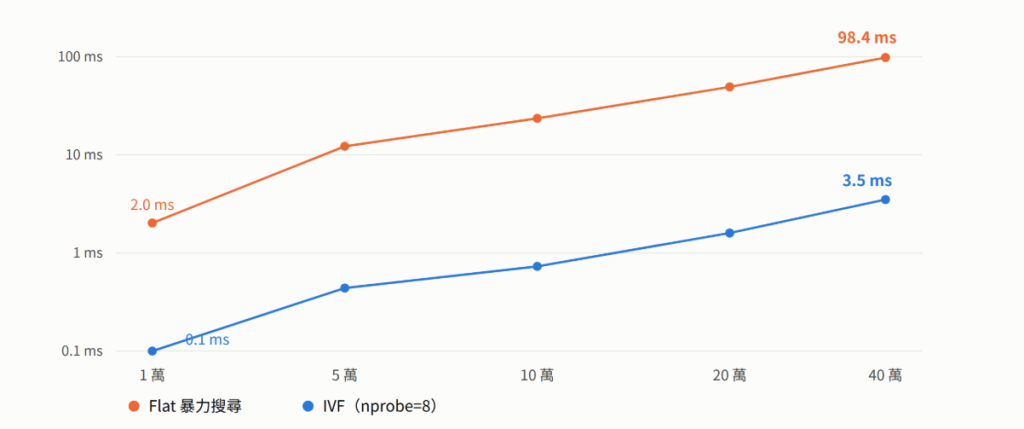
可以看到 Flat 的延遲幾乎是完美的線性成長當資料量翻一倍,查詢時間就跟著翻一倍,到了 40 萬筆時單筆查詢已經要 98 毫秒,而這還只是檢索的部分,當後面還要接上 LLM 生成,使用者感受到的等待只會更長。
這裡有地方要特別提醒,就是批次查詢和單筆查詢的速度差很多,如果你把 1000 個問題一次丟進
search(),FAISS 會把它轉成矩陣運算,平均每筆只要 0.9 毫秒;但同樣的資料改成一次查一筆,就變成 24 毫秒,差了 20 倍以上。
而今天為了模擬實際資料庫中的資料量與 Embedding 分布,在開始比較之前,我們得先準備一份足夠大的測試資料。但這一步其實比想像中還要麻煩,所以我想先花一點篇幅把這件事講清楚,也讓你透過這個過程理解 Embedding 模型究竟是如何運作的。
在 Embedding 資料中,能不能找出正確答案,關鍵在於近似搜尋都建立在同一個前提上,也就是相似的資料會聚在一起。
IVF 之所以敢只搜尋少數幾個群,是因為它假設答案會和查詢落在相同或鄰近的群組;HNSW 之所以能在圖上一路跳到目標附近,也是因為它假設鄰居的鄰居,通常還是鄰居。
而真實的 Embedding 正是透過模型訓練,讓語意相近的資料形成這樣的空間結構。就像我們前幾天的員工手冊,請假的內容會聚在向量空間的某一區,報帳的內容則會聚在另一區。所以如果我們直接用 np.random.normal 產生一批隨機向量來測試,這個前提就不存在了。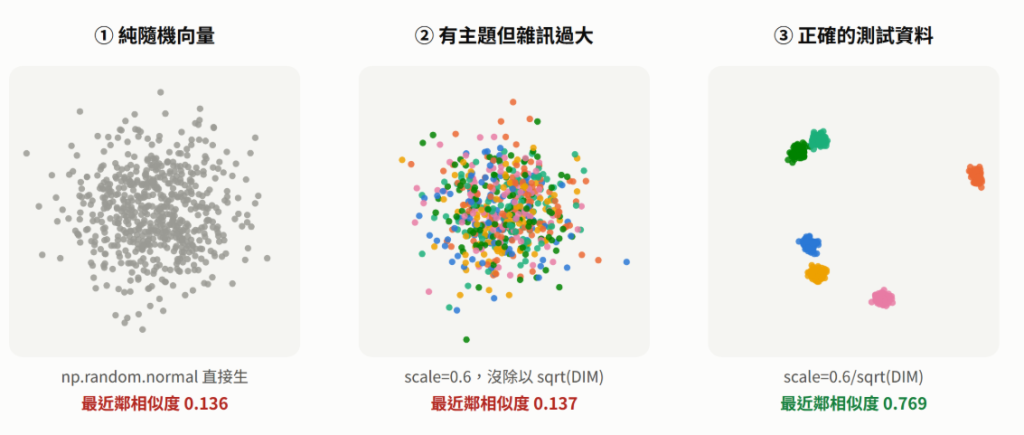
更反直覺的是高維空間中的隨機向量有一個特性彼此之間的距離會變得非常接近。例如在 512 維空間中,任意兩個隨機點幾乎等距,整份資料自然也就沒有明顯的群集結構。
這時不管 IVF 怎麼分群,每個群裡放的都只是一堆彼此不相關的資料。測出來的 Recall 可能低到只剩個位數,而且不管怎麼調參數都很難救回來,因為問題從頭到尾都不在索引,而在測試資料本身。
所以,我們需要自己建立具有群集結構的測試資料。做法是先隨機產生幾百個主題中心,再讓每一筆資料圍繞著自己的主題中心散開:
N_TOPIC = 200      # 模擬知識庫裡有幾個主題

# 真實的 Embedding 不是均勻散落在空間裡,同一個主題的文件會擠在一起,
# 所以這裡先造出幾百個主題中心,再讓每一筆資料圍著自己的主題分佈。
centers = rng.normal(size=(N_TOPIC, DIM)).astype("float32")
faiss.normalize_L2(centers)


def make_vectors(n: int, spread: float = 0.6) -> np.ndarray:
    # 雜訊的尺度要除以 sqrt(DIM),否則在高維度下雜訊會蓋過主題中心,資料就退化成完全隨機
    topic = rng.integers(0, N_TOPIC, size=n)
    noise = rng.normal(scale=spread / np.sqrt(DIM), size=(n, DIM)).astype("float32")
    vecs = centers[topic] + noise
    faiss.normalize_L2(vecs)
    return vecs


def make_queries(base: np.ndarray, n: int) -> np.ndarray:
    # 模擬使用者的問題:它不會跟文件一模一樣,但會落在某一筆文件附近
    idx = rng.integers(0, len(base), size=n)
    noise = rng.normal(scale=0.3 / np.sqrt(DIM), size=(n, DIM)).astype("float32")
    vecs = base[idx] + noise
    faiss.normalize_L2(vecs)
    return vecs
而在程式碼中可以看到,我寫了一個 spread / np.sqrt(DIM)。這是為了控制雜訊的影響。因為每個維度單獨看,雜訊其實都很小,但當 512 個維度累積起來後,整體的雜訊幅度會被放大約 22 倍。如果沒有除以 sqrt(DIM),雜訊很容易直接蓋過主題中心,讓資料重新變成接近隨機分佈的狀態。
這也是高維度資料在調整參數時很常見的一個陷阱**單看每個維度的變化似乎不大,但累積到整個向量後,影響可能非常明顯。**至於 make_queries,則是讓查詢向量落在某一筆資料附近。這是為了模擬真實情境:使用者的問題通常不會和文件一字不差,但如果語意相近,Embedding 應該要讓它們在向量空間中彼此靠近。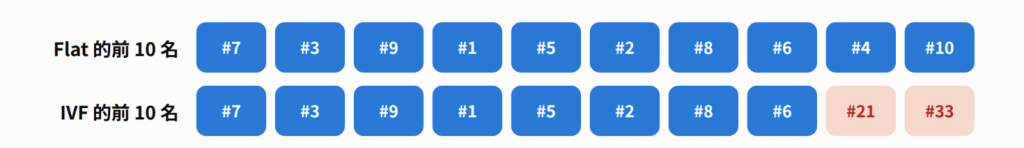
而這次衡量準確度的方式,我們使用 Recall@10。簡單來說就是把 Flat 的前 10 名結果當作標準答案,再看近似搜尋的前 10 名中,有多少筆成功命中:
def recall(approx: np.ndarray, exact: np.ndarray) -> float:
    """近似搜尋的前 k 名,有多少比例出現在暴力搜尋的前 k 名裡。"""
    hits = sum(len(set(a) & set(e)) for a, e in zip(approx, exact))
    return hits / exact.size
之所以使用 Recall,是因為近似搜尋的核心就是用速度換取部分準確度。既然結果是近似的,就代表它有可能漏掉真正的近鄰。
第一種做法是 IVF(Inverted File),它的概念是建索引時先用 k-means 把所有向量分成 nlist 群,每一群都有一個中心點。查詢進來時,先跟這些中心點比對,找出最接近的 nprobe 群,然後只在這幾群裡面搜尋。
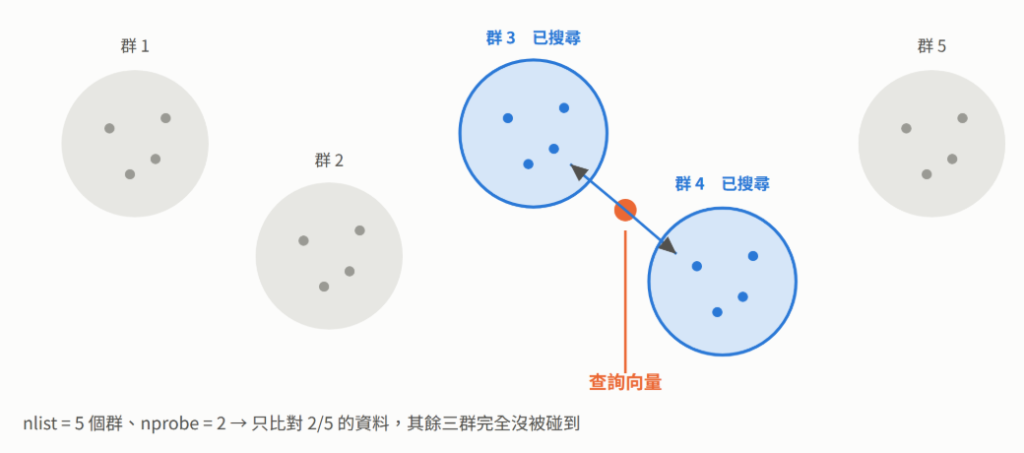
就像圖裡的情況,5 個群只搜其中 2 群,等於一開始就砍掉 60% 的計算量。程式寫起來也很單純,不過要注意它比 Flat 多一個 train() 的步驟,因為 k-means 必須先看過資料才知道中心點要放哪裡:
quantizer = faiss.IndexFlatIP(DIM)
ivf = faiss.IndexIVFFlat(quantizer, DIM, 256, faiss.METRIC_INNER_PRODUCT)
ivf.train(base)          # 這一步在做 k-means 分群
ivf.add(base)
ivf.nprobe = 8           # 查詢時要搜幾群,隨時可以改
而這裡真正要調的是 nprobe,它是速度和準確度之間的旋鈕。調小可以增加速度,但如果答案剛好落在隔壁群,你就整個找不到它;調大會比較準但搜的群變多,大到極限時就跟暴力搜尋沒兩樣了,所以 nprobe 它很適合上線後再依照實際的 recall 去微調他的超參數。
第二種做法是 HNSW(Hierarchical Navigable Small World),它不做分群的動作而是把所有向量連成一張多層的圖。
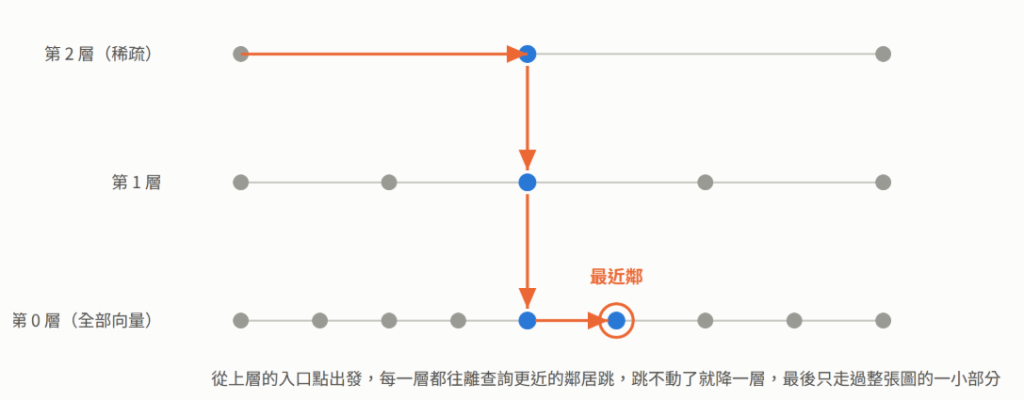
他的查詢方式是從上層的入口點出發,每一層都往離查詢更近的鄰居移動,跳不動了就往下降一層,重複這個動作直到最底層。這個過程只會走過整張圖的一小部分,所以即使資料量很大,查詢時間也不會像 Flat 那樣線性成長。
hnsw = faiss.IndexHNSWFlat(DIM, 32, faiss.METRIC_INNER_PRODUCT)   # 32 就是 M
hnsw.hnsw.efConstruction = 40
hnsw.add(base)           # 不需要 train,但 add 的過程就是在建圖,會比較久
hnsw.hnsw.efSearch = 64  # 查詢時的候選數量,同樣可以隨時改
HNSW 有三個重要參數需要先認識。
M 代表每個節點最多連接多少個鄰居。調大通常能提升搜尋品質,但同時也會增加記憶體使用量與建索引的時間。
efConstruction 是建立圖時,每一步要考慮的候選數量。它會影響最後建立出的圖品質,因此修改後需要重新建立索引。
efSearch 則是查詢時要保留的候選數量,它和 IVF 的 nprobe 很像,都是查詢階段可以動態調整的參數,不需要重新建立索引。
我們把上面三種索引放在同一份 10 萬筆資料上比較,並用 1000 筆查詢測量單次查詢延遲,結果如下:
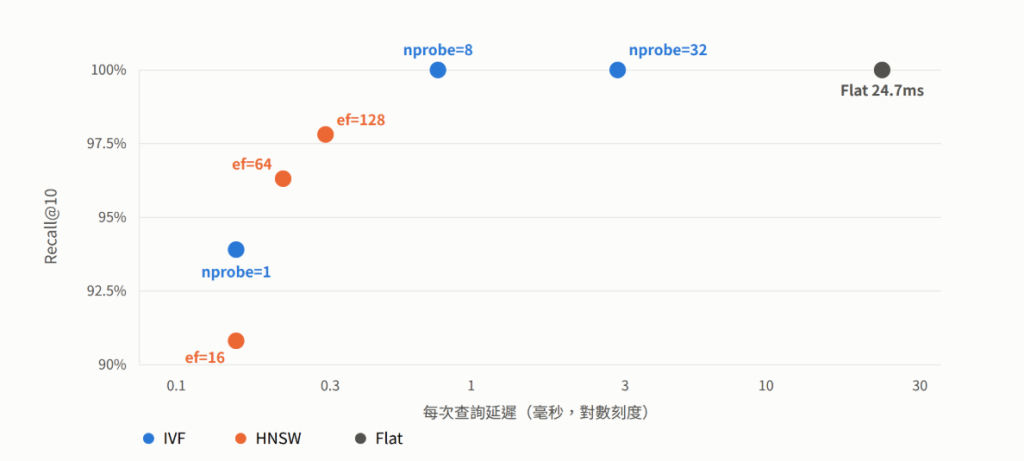
這張表可以看到 IVF 只搜尋 1 個群時,查詢延遲從 24.7 毫秒降到 0.16 毫秒,快了約 154 倍,且 Recall@10 仍有 93.9%,也就是說,在這組測試中大部分查詢都能找到正確的近鄰,如果把 nprobe 提高到 8 之後,Recall@10 就達到 100%,延遲也只有 0.77 毫秒,依然比暴力搜尋快約 32 倍,但若繼續把 nprobe 提高到 32,Recall 並沒有進一步提升,延遲卻增加到 3.14 毫秒,這就是因為搜尋範圍已經足夠,再增加 nprobe 只是在花更多時間做相同的事情。所以參數不是越大越好,而是要找到符合需求的 Recall 與延遲平衡點
至於 HNSW,它的查詢速度和 IVF 大致落在同一個等級,但建索引需要約 10 秒,明顯高於 IVF。這是因為 HNSW 在建立圖結構時,需要逐步為節點建立鄰居關係。
不過可以發現 HNSW 在這份測試資料上的 Recall 反而略低於 IVF,這是因為我們刻意建立的資料是圍繞著主題中心產生,具有明顯的群集結構,而這種資料分布正好符合 IVF 透過 k-means 分群的設計。這並不代表 IVF 一定比 HNSW 好,而是不同索引對資料分布的適應方式不同。HNSW 是透過鄰居關係建立圖結構,而 IVF 則是先把向量分成不同群組,再限制搜尋範圍。
這點其實和前幾天談 Chunking 與 Embedding 模型時的結論是一樣的**不要只看理論或別人的 Benchmark,真正重要的是它在自己的資料和查詢上表現如何。**如果資料本身具有明顯的群集結構,可以優先測試 IVF;如果資料的相似性更適合透過鄰居關係來連接,則可以測試 HNSW。最終仍然應該用自己的資料實際 Benchmark,而不是直接根據資料類型下結論。
到這裡我們的 RAG 已經快要學習完畢了。但還記得 Day 7 留下的最後一個問題嗎?當時我們發現 top_k=3 一定會湊滿三筆,就算後面兩筆和問題根本沒有關係,它們還是會被塞進 Prompt 裡。
所以明天,我們要開始處理檢索結果的品質,看看 BM25 關鍵字檢索如何補上向量搜尋抓不到的內容,以及 Reranking 如何把真正相關的 Chunk 排到前面。
那我們明天再見!


 iThome鐵人賽
 看影片追技術