

在開發 AI 虛擬助教的過程中,最讓教學現場老師和學生捏一把冷汗的問題絕對是 「AI 幻覺(Hallucination)」。過去幾天我們透過 System Instruction 賦予了 AI 角色,但當學生拿出一份特定的課堂講義或原文書章節提問時,模型若因為記憶庫龐雜而開始自由發揮、一本正經胡說八道,不僅會誤導學生的學習觀念,更會讓教育性質的應用失去信任感。
為了解決這個問題,我們想在試著導入 RAG的基礎架構。我們要讓 Node.js 後端學會接收學生上傳的指定 PDF 教材,並透過 Google GenAI SDK 將檔案傳遞給 Gemini,讓 AI 助教每一次開口回答,都必須「有所本」地依據該份教材進行引導。
今天的實作核心在於如何將本機或前端上傳的 PDF 檔案,無縫串接到 Google AI Studio 的底層檔案處理與大模型生成流程中。整個技術串接與測試流程主要分為下面幾個關鍵步驟:
multer 套件來接收前端傳送過來的單一 PDF 檔案(例如教學講義),並暫存於伺服器的 uploads/ 資料夾中。ai.files.upload): 由於 PDF 是二進位檔案,不能直接當作純文字 Prompt 傳遞。我們透過 @google/genai SDK 將 PDF 檔案上傳至 Gemini 雲端暫存空間,並取得雲端檔案的 uri。fileData 與嚴格的 systemInstruction: 在呼叫 ai.models.generateContent 時,我們建構了符合 SDK 規範的 fileData物件,並設定嚴格的系統指令,要求 AI「只能根據提供的教材回答,若不在範圍內必須明確拒絕」。以下是我們今天在專案後端實作的 RAG 核心路由模組(routes/ragRoutes.js),完美整合了檔案接收、雲端上傳與帶有 System Instruction 的嚴格問答邏輯:
import express from 'express';
import multer from 'multer';
import { GoogleGenAI } from '@google/genai';
import fs from 'fs';
import path from 'path';

const router = express.Router();

// 設定 multer 暫存上傳檔案至 uploads/ 目錄
const upload = multer({ dest: 'uploads/' });

// 初始化 GoogleGenAI (自動讀取環境變數中的 GEMINI_API_KEY)
const ai = new GoogleGenAI({});

router.post('/ask-pdf', upload.single('pdf'), async (req, res, next) => {
  let filePath = '';
  try {
    const file = req.file;
    const question = req.body.question || '請為我總結這份教材的重點。';

    if (!file) {
      return res.status(400).json({ error: '請上傳 PDF 教材檔案' });
    }

    filePath = file.path;
    const originalExt = path.extname(file.originalname) || '.pdf';
    const targetPath = filePath + originalExt;

    // 將暫存檔重新命名,確保副檔名完整
    fs.renameSync(filePath, targetPath);
    filePath = targetPath;

    // 1. 上傳 PDF 至 Gemini 雲端暫存空間
    const uploadResult = await ai.files.upload({
      file: filePath,
      mimeType: file.mimetype || 'application/pdf',
    });

    console.log(`檔案上傳成功,URI: ${uploadResult.uri}`);

    // 2. 呼叫 Gemini 模型進行限制範圍的問答 (使用正確的 fileData 結構)
    const response = await ai.models.generateContent({
      model: 'gemini-3.6-flash',
      config: {
        systemInstruction: "你是一位嚴格但溫暖的 AI 助教。請嚴格根據提供的【指定教材 PDF】來回答學生的問題。如果問題不在教材範圍內,請引導學生回到課程主題,絕對不可自行瞎編答案。",
      },
      contents: [
        {
          fileData: {
            fileUri: uploadResult.uri,
            mimeType: uploadResult.mimeType || 'application/pdf',
          },
        },
        `學生提問:${question}`
      ],
    });

    // 清理伺服器上的本地暫存檔案
    if (fs.existsSync(filePath)) {
      fs.unlinkSync(filePath);
    }

    res.json({
      success: true,
      answer: response.text,
    });

  } catch (error) {
    if (filePath && fs.existsSync(filePath)) {
      try { fs.unlinkSync(filePath); } catch (e) {}
    }
    next(error);
  }
});

export default router;
在開發過程中,我們也遭遇了幾個非常經典的工程實務考驗:
400 INVALID_ARGUMENT (required oneof field 'data' must have one initialized field)
{ fileData: { fileUri, mimeType } } 格式包裝。404 NOT_FOUND 搭配舊模型
pkill -f "node server.js" 終止舊進程並重新啟動 Server 即可順利解決。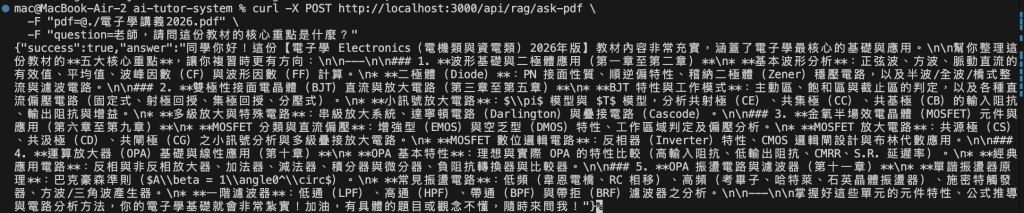
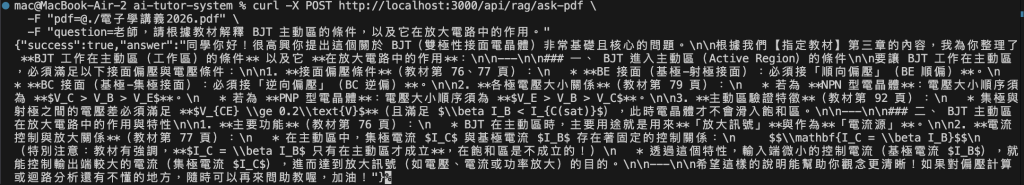
為了驗證我們的 RAG 系統是否具備「防瞎編」能力,我們進行了兩次對比測試:
1.測試教材內問題:「請根據教材解釋 BJT 主動區的條件與作用。」 → AI 能夠完美結合講義中的波形與半導體特性進行精準回答 。
2.測試教材外問題:「請問量子電腦的 Shor 演算法是怎麼運作的?」 → AI 回答:「這個問題在目前教材中沒有提到喔!」並進一步列出教材涵蓋的範圍,拒絕盲目擴展 。

這證明了我們透過 System Instruction 所設定的邊界條件成功發揮了作用,讓 AI 的回答有了明確的知識來源與約束。
傳統教育現場中,老師們常常需要面對大量重複性、基礎觀念的提問;而當學生想透過一般 AI 工具自學時,又常因 AI 的「幻覺」特性而接收到錯誤的公式或觀念。
透過今天的 RAG 基礎架構,我們真正實現了「教材主權歸於學校與老師」的願景。學生看什麼講義、上什麼進度,AI 助教就讀什麼教材。這種「有所本」的知識檢索與引導機制,不僅確保了學術內容的正確性,更能有效減輕教師在基礎答疑上的負擔。
我們的本地 AI 助教系統已經具備文字對話、圖片多模態辨識以及 PDF 教材 RAG 閱讀能力。明天我們將使用 Firebase Hosting 將我們的 AI 助教專案正式部署上線,取得屬於自己的免費公開網址。


 iThome鐵人賽
 看影片追技術