
走讀活動現場,你把「集合地點在哪裡?」送出去,卻等到逾時。今天要讓 LOCAL 用原送出鍵查回單號;需要重送時仍沿用原鍵,資料庫只收同一筆。明明沒收到回覆,後端怎麼已經有資料?
Day 10 connects LOCAL’s original timeout policy to the confirmed request flow. We reuse the Day 8 confirmation core and Day 9 SQLite service, inject failures before writing and after committing, and reconcile with the original operation key. A bounded controller coordinates ADK tools; offline CI keeps the selected contracts under regression checks. Model behavior and remote workflow execution are verified separately.
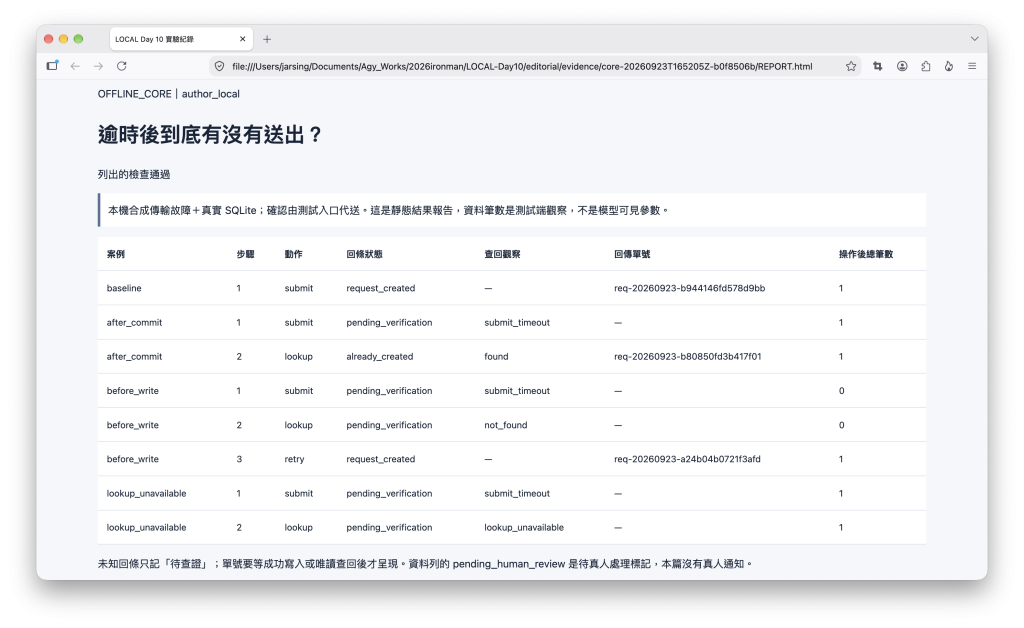
圖 1:離線核心實驗的靜態結果報告。先看四種情境下的當下資料庫筆數與查回動作;本次逾時由傳輸包裝注入。
Day 9 已經能建立請求、拿到單號。這次把回覆中斷的位置分成兩種,看看同一句「等不到回覆」背後藏著什麼。以下是本機實測產生的四組對照,實際單號與筆數可對照本機產生的 HTML 報告:
| 情境 | 第一次取得的結果 | 逾時當下資料庫 | 接著怎麼做? | 操作後總筆數 | 本次實測回傳單號 |
|---|---|---|---|---|---|
| 正常送出(baseline) | 已建立,取得單號 | 1 | 保留回條 | 1 | req-20260923-b944146fd578d9bb |
| 後端已提交,回條遺失(after_commit) | 待查證 | 1(單號已存在) | 用原鍵查回,取回原回條 | 1 | req-20260923-b80850fd3b417f01 |
| 寫入之前中斷(before_write) | 待查證 | 0 | 用原鍵查無紀錄,再以同鍵重送一次 | 1 | req-20260923-a24b04b0721f3afd |
| 回條遺失,查回也受阻(lookup_unavailable) | 待查證 | 1 | 保留待查證,停止這次自動流程 | 1 | —(流程保持未知) |
先看中間兩列:第一次得到的結果都是「待查證(pending_verification)」,資料庫卻可能是一筆或零筆。逾時描述的是「這次等不到結果」,寫入是否完成,要另外核對。
最右兩欄是操作後總筆數與實際單號。表中的「待查證」是 pending_verification;請求保存在資料庫後,仍維持前篇的待真人處理標記(pending_human_review)。
我的判讀很單純: 寫入前中斷時,資料庫仍是零筆,後續同鍵重送補上原請求;提交後中斷時,原鍵查回已經存在的那一筆。查回也受阻,就保留待查證,停止這次自動流程。
本次本機離線核心回歸共 144 項通過(含 Day 1 原規格、Day 2/8/9/10 核心回歸);加上真正 Google ADK Runner 搭配固定腳本模型的 19 項整合測試,共 163 項全數通過。完整選測範圍與 CI 紀錄見第五節。
去郵局寄掛號時,窗口人員其實已經收件蓋章,只是回條還沒遞到你手上,外頭就突然颳大風把紙吹跑了。這時你最需要的,不是重新寄第二封信,而是拿著原本的識別回窗口查收件紀錄。另一種情況則是,信件根本還沒交給窗口就中斷了。表面上看起來都是「等不到回條」,背後的處理進度卻完全不同。
在網路與分散式系統中,不能只有非黑即白的「成功」或「失敗」,必須有第三種關鍵狀態:「待查證(Unknown / pending_verification)」。
這時候先不要判定成功或失敗。LOCAL 把結果記成 pending_verification,再用原本的送出鍵查後端紀錄,老老實實承認「我現在還不知道後端進度」,才不會製造重複建單的問題。
Day 1 的 handoff-timeout-001 就把這件事列成規格:結果待查證、保留原送出鍵、先核對後端。[1] Day 2 以 Python 示範過原理;Day 8 把同意綁到具體內容,Day 9 再讓這份內容成為真正的資料列。今天要把它們接成同一條查回流程。
我想保留的體驗很簡單:詢問內容已經整理好了,使用者沿用原本那份內容,只要知道目前查到哪一步就好。
故障注入(Fault Injection) 就是在指定位置刻意製造錯誤,讓同一個失敗情境可以重複驗證。本篇分別在「寫入前」與「資料庫提交後、回條回來前」製造 timeout。我的本機與 GitHub Actions 都使用 Python 3.13.5;其他版本是否相容,以 README 與實際測試為準。
從包含前篇程式的 Repo 根目錄執行:
python3 examples/day10/demo.py
這個入口只需要 Python 標準函式庫,不需連網,也不依賴額外套件。它會產生 REPORT.html,以及各案例的 events.jsonl、handoff.sqlite3 和每一步的 SQLite 快照。先開報告,再比較提交後逾時與寫入前逾時兩列。
BEFORE_WRITE 在呼叫建單服務之前中斷;AFTER_COMMIT 則先讓 Day 9 完成寫入,才丟棄回條。 提交(Commit) 表示資料庫完成這筆交易;拿到回條則是另外一段傳遞過程。[4]
以下節錄 fault.py;中間的事件記錄省略,原建單服務仍沿用 Day 9:
if fault is Fault.BEFORE_WRITE:
    ...
    raise SyntheticTimeout('SYNTHETIC_TRANSPORT_TIMEOUT')
receipt = self.service.create(actor=actor, **args.tool_args())
...
if fault is Fault.AFTER_COMMIT and receipt['status'] in ('request_created', 'already_created'):
    ...
    raise SyntheticTimeout('SYNTHETIC_TRANSPORT_TIMEOUT')
return receipt
故障設定留在測試端,服務流程收到的只有逾時。查回流程要靠後端紀錄判斷。
先跑一個案例也可以:
python3 examples/day10/demo.py --case after_commit
這一輪的第一步應顯示待查證,但 step-01.sqlite3 已有一列。下一步拿回原單號後,資料筆數仍是一。這個前後對照,比只看一句「成功查回」更有意思。
查回對帳(Reconciliation),就是拿原本那次操作的識別去問後端,把「現在知道的結果」和「實際留下的紀錄」對起來。
這次新增 reconcile_handoff_request,只負責讀取;create_handoff_request 仍負責受控建立。兩個工具都收到原本的送出鍵、確認碼、詢問文字與活動識別,可信應用端再提供使用者與對話身分。
原送出逾時 → 唯讀查回 → 找到就回原單;當次查無紀錄,才允許同鍵重送一次。
為什麼送出之前就要先有操作識別?
如果單號要等資料庫寫入後才產生,那麼回條一旦遺失,送出端就少了一個能回頭核對原操作的識別。所以 LOCAL 在真正送出以前,就先由可信應用端配置一把送出鍵(Idempotency Key)。即使回覆途中斷線,查回或重送都沿用同一把鍵,不必猜這是不是另一件新操作。
查回連線使用 SQLite mode=ro,讓這條路徑只讀不寫;連路徑錯誤時,也不會順手建立新的空資料庫。查回找到資料時,仍核對當前權限、本人、Session 與內容。Session 是這一段對話的工作階段;本篇把原操作綁在同一個對話中,避免回條被套到其他對話。
資料庫成功回答「這次沒有找到」,會記為 not_found;連查詢都受阻,則是 lookup_unavailable。它們都保留待查證,但接下來的安排不同。
以下節錄 reconcile.py 的查回分支:
try:
    result = self.transport.lookup(actor, args)
except SyntheticTimeout:
    result = pending_result('lookup_unavailable')
self.phase = ('retry' if result['status'] == 'pending_verification'
              and result.get('observation') == 'not_found' else 'done')
這幾行只在成功查詢卻沒找到時,允許下一步重送。查詢本身受阻,這次流程就先停在待查證。
還有一個細節:查無紀錄只代表當下看到的狀態。如果另一個請求剛好在查回後寫入,重送仍可能遇到已經存在的資料。因此,安全性來自 沿用同一把鍵,再交給 Day 9 的交易和唯一性限制核對,而不是把一次空查詢當成永遠沒寫入的證明。[2][4]
冪等鍵是辨認同一次操作的號碼;重送沿用原鍵,才能維持同一筆建立結果。它和「目前有權限」是兩件事。
已經存在的回條,按前篇規則核對身分與內容後取回。第一次要新增資料,則重新確認同意是否仍有效、活動版本是否相符,以及目前是否有操作權限。[2]
這也是為什麼程式重用原 Day 8 確認核心、原 Day 9 建單服務。逾時只是多了一段查回路徑,原本的同意和權限檢查照樣保留。
Google ADK(Agent Development Kit) 是把模型、工具與對話流程接在一起的開發框架。本篇把送出與查回包成函式工具,讓模型提出呼叫,再由 ADK 執行並送回結果。[3]
但重送幾次、下一步可以做什麼,由 RecoveryController 掌握。它把原四參數和目前階段綁定起來:送出、查回、必要時再送一次。模型可以換一種說法解釋回條,操作識別則維持原值。
本篇由控制器安排重試策略,模型入口收到指定工具與原參數,因此檢查的是受控工具往返與結果解釋。
AI 可以提出工具呼叫,但不能自己決定身分。
ToolContext 是 ADK 在工具執行時自動提供的環境物件。本篇從其中取得目前 Session,再和可信應用端提供的預期使用者/Session 做比對;模型看不到可以自由填寫的 user_id 欄位。真正的登入與入口驗證仍由應用服務負責,ADK 不取代身分驗證。[3]
沿用前篇已安裝 ADK 的 Python 環境,從 Repo 根目錄執行:
PY=examples/day05/.venv/bin/python
$PY examples/day10/verify.py --sdk
$PY examples/day10/run.py --case after_commit
$PY examples/day10/run.py --case before_write
環境尚未準備好時,依本章 README 的安裝步驟建立即可。這裡先用固定腳本模型搭配真正 ADK,檢查提出呼叫、執行、回傳三個事件,以及它們對應的單號和資料列。
本篇以真正 ADK Runner 搭配固定腳本模型,驗證工具往返與後端結果,沒有新增真實 Gemini API 實測。 程式保留 --live --approve-live --model 入口;另外執行時,再記錄模型原文、用量與工具事件,判讀「待查證」是否說得準。這篇先驗證受控工具流程、資料列與 CI。
特別留意 CLIENT_STATUS:這是應用端在逾時時留下的「待查證」事件,後續可接到訊息介面。讀報告時把兩種文字分開,就知道是程式先決定狀態,還是模型如何描述它。
Day 9 先讓同一次送出只留下同一筆請求,今天再補上逾時後的查回。每次多做一點,舊功能還好嗎?使用者又多了什麼方便?
這呼應 敏捷開發(Agile) 重視的做法:及早交付一小段有價值的軟體,與使用者合作,根據回饋調整下一步。[8] 分段增加功能只是其中一部分;每天發文,也不等於完成了一次敏捷循環。
我把回饋分成兩種:程式測試檢查「同鍵重送是否多了一筆」;後續試用則要觀察「使用者看懂待查證了嗎,知道下一步嗎?」前者驗證目前定下的行為,後者幫我們判斷下一版該改什麼。
為了讓改動持續得到技術回饋,我把選定的回歸測試接進 CI(Continuous Integration,持續整合):經常把小改動整合回同一份程式,再自動檢查原有行為有沒有退步。這次使用 GitHub Actions,依工作流程(workflow)在 GitHub 提供的執行環境(runner)重跑。[5]
本篇工作流程在 Push 到 main 後,核對 Day 1 原規格,執行 Day 2/8/9/10 的核心回歸;真正 ADK Runner 搭配固定腳本模型的 Day 9/10 整合測試,另放一個工作。
這裡的「離線」是指測試不呼叫 Gemini、LINE 或 Google Cloud 業務 API,也不用提供這些服務的私人金鑰;取得程式、安裝套件與上傳測試產物(artifact)仍會連網。
本篇 workflow 的核心步驟節錄如下;完整檔案在 .github/workflows/ci.yml:
- name: Verify the frozen specification and core contracts
  run: python examples/day10/verify.py --group core --out ci-output/core
- name: Run the SQLite fault experiment
  run: python examples/day10/demo.py --out ci-output/core
workflow 裡的 actions 全數以 commit SHA 釘選版本、權限為最小的唯讀(contents: read),而且完全不放任何業務 secret。第一次 Push Day 10 功能後,LOCAL offline CI 在 commit 0e33e058… 跑完兩個工作:核心回歸 144/144,ADK 整合 19/19,合計 163/163,沒有失敗、錯誤或略過。原始執行紀錄附在參考資料 [7]。
修改程式 → Push → 自動檢查 → 核對這個版本的紀錄。 綠燈只支持這個版本通過已納入的檢查;Push 後檢查不會撤回已提交的版本。Gemini 語意表現、LINE 整合與 Cloud Run 部署,仍有各自的驗證。
我也留了一個隔離反例:刻意讓查回使用錯鍵,再讓同一套斷言檢查實際事件。外層測試預期抓到這個錯誤,所以通過代表它有發現問題,不是一筆 GitHub 工作流程失敗紀錄。
那 CD 呢? Continuous Delivery(持續交付) 是讓版本保持可依需要部署的狀態; Continuous Deployment(持續部署) 則把通過既定流程的變更自動送上正式環境。[6] LOCAL 今天先做到這條離線 CI,後續再接交付流程,正式上線保留人工決定。
敏捷幫我根據回饋調整下一步,CI 讓已涵蓋的行為隨著改動反覆接受檢查,CD 則把可驗證的版本接向交付。LOCAL 要累積的,是使用者用得上的能力,以及每次修改都能核對的方法。
第一,介面與真實網路。 這篇以本機包裝模擬傳輸中斷,保留可接 LINE 的狀態文案事件;LINE 訊息送達和實際行動網路故障,留到整合測試時核對。
第二,持久化接續。 每個案例最多初次送出、查回、重送三步,沒有持續輪詢的背景行程。請求保存在 SQLite,確認與控制器狀態仍在記憶體,重啟接續是下一篇要推進的方向。
第三,真人與上線。 本篇只留下服務請求,尚未通知真人或部署雲端。這個明確範圍,也讓我們能把同一個實驗在另一台電腦再做一次。
Day 1 問「逾時後到底有沒有完成」,Day 2 拆開回覆與資料庫狀態,Day 8、9 把確認與建單接起來。今天再補上原鍵查回,讓「我暫時不知道」也有下一個可靠的動作。
一筆請求可以經過多次傳遞,但每一步都要認得原本那件事。 今天有這套核對方法,後面再增加工具、更新提示或搬上雲端,就能回來看看:我們是否仍守住同一張單?
下一篇接著處理 Firestore 持久化:程式重啟後,哪些紀錄還在,這段流程又該從哪一步繼續?
前篇:Day 9|按兩次送出,會不會多一筆?受控建單與冪等。本篇程式在 Repo 的 examples/day10/,操作與完整測試範圍見該目錄 README.md、CONTRACT.md。


 iThome鐵人賽
 看影片追技術