
既然昨天提到的問題主要是簡體、字太小、沒辦法一次專注一句
這些都是所謂廣義上的 UI/UX 問題
那就和華安借個
還我漂漂拳👊
來讓醜醜的稿子版面變得好看一些吧
基本上,是一個
「希望一次專注讀一個
方便 iPad 閱讀的介面」
所以這個工具做的事情很單純
一次只看一句
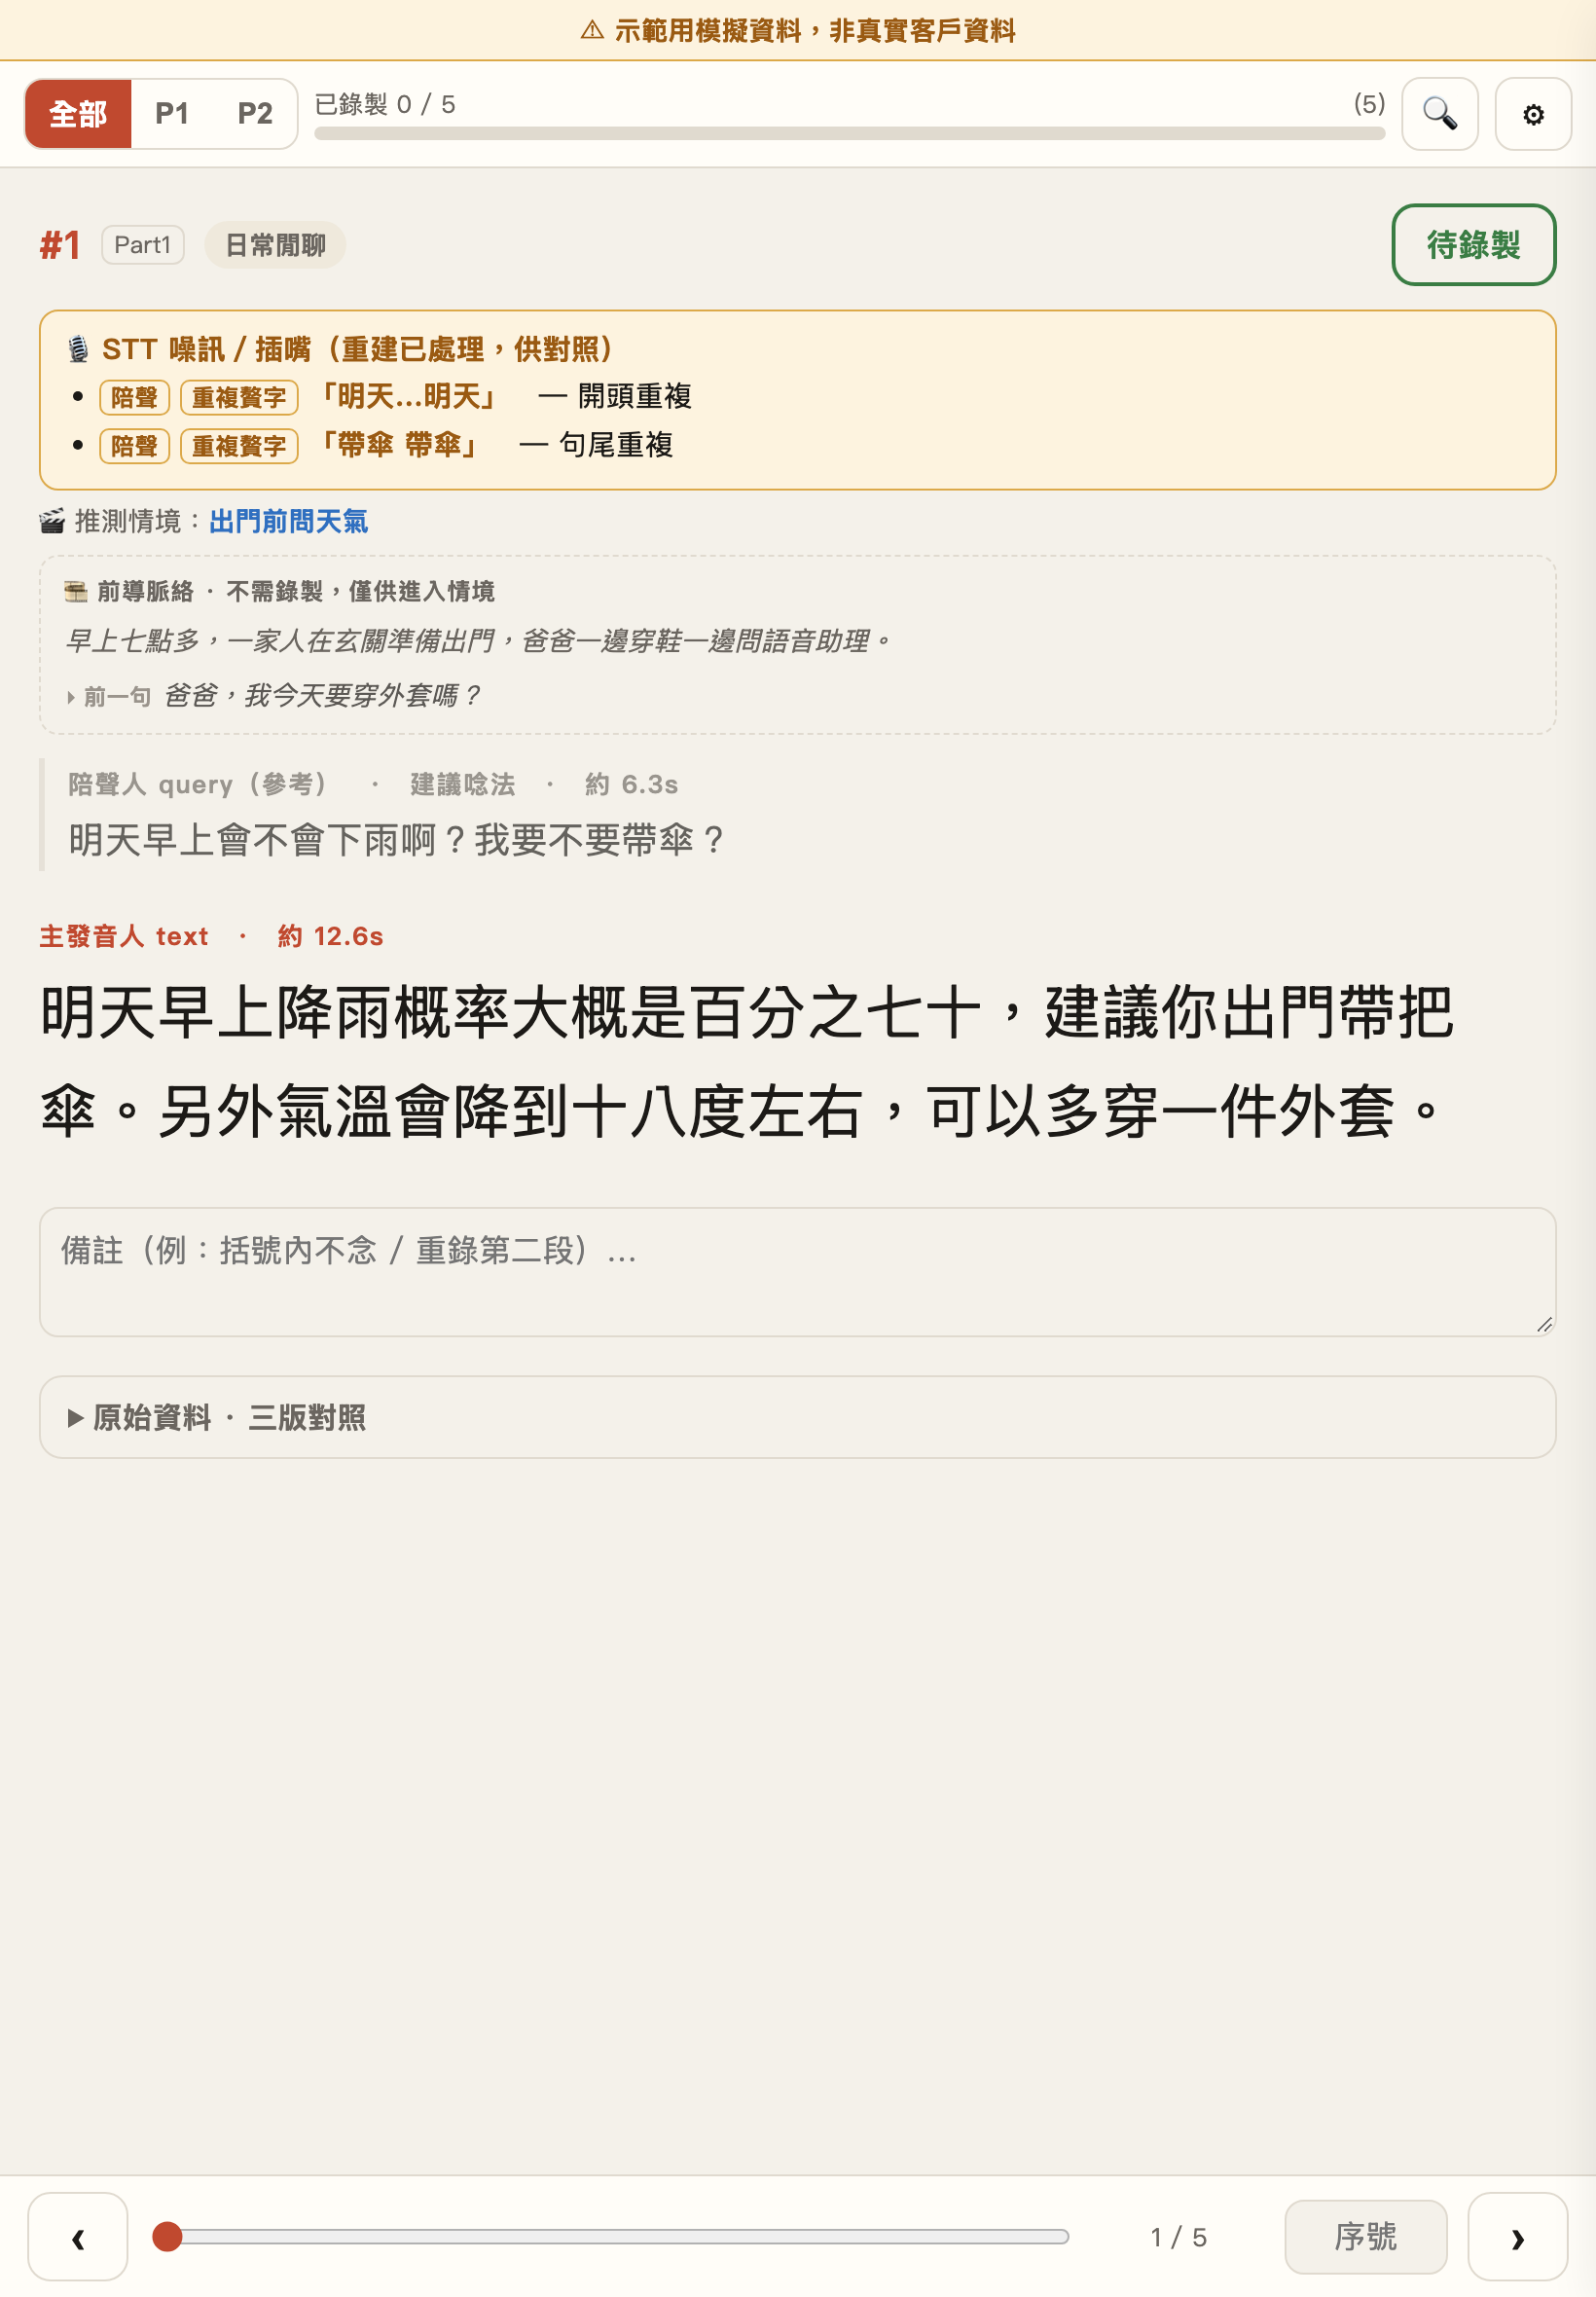
截圖是示範版,模擬資料,不含任何實際客戶資訊
除此之外還有設計一個簡單的進度機制
錄完之後可以就按「已錄製」
從進度條看錄到哪都一目了然
而稿子不順的地方還可以寫個備註讓對方回去確認
這樣當要錄音的時候
就可以專心在聲音本身上,而不用被那些東西煩惱了
而這次一樣是用 Claude Code 做的
整個工具就是一個 HTML 檔,不用連網,iPad 打開就能用
(雖然我後來還是把它部署到我的個人部署平台上,不過那就是後話了)
而且除了介面的問題以外,對於簡繁體的轉換也有不同的眉角
因為光是簡繁體轉換其實就有不同的門路
如果很粗暴的轉用詞
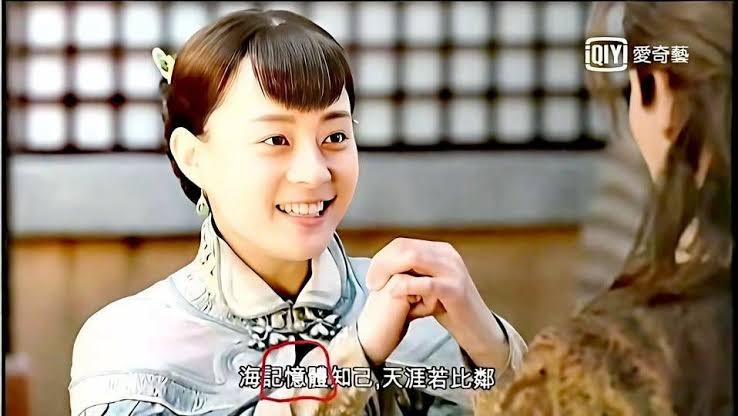
就可能會發生這種
海記憶體知己,天涯若比鄰
的窘境
而根據甲方要求的不同,可能需要保留不同的轉換方式作為參考
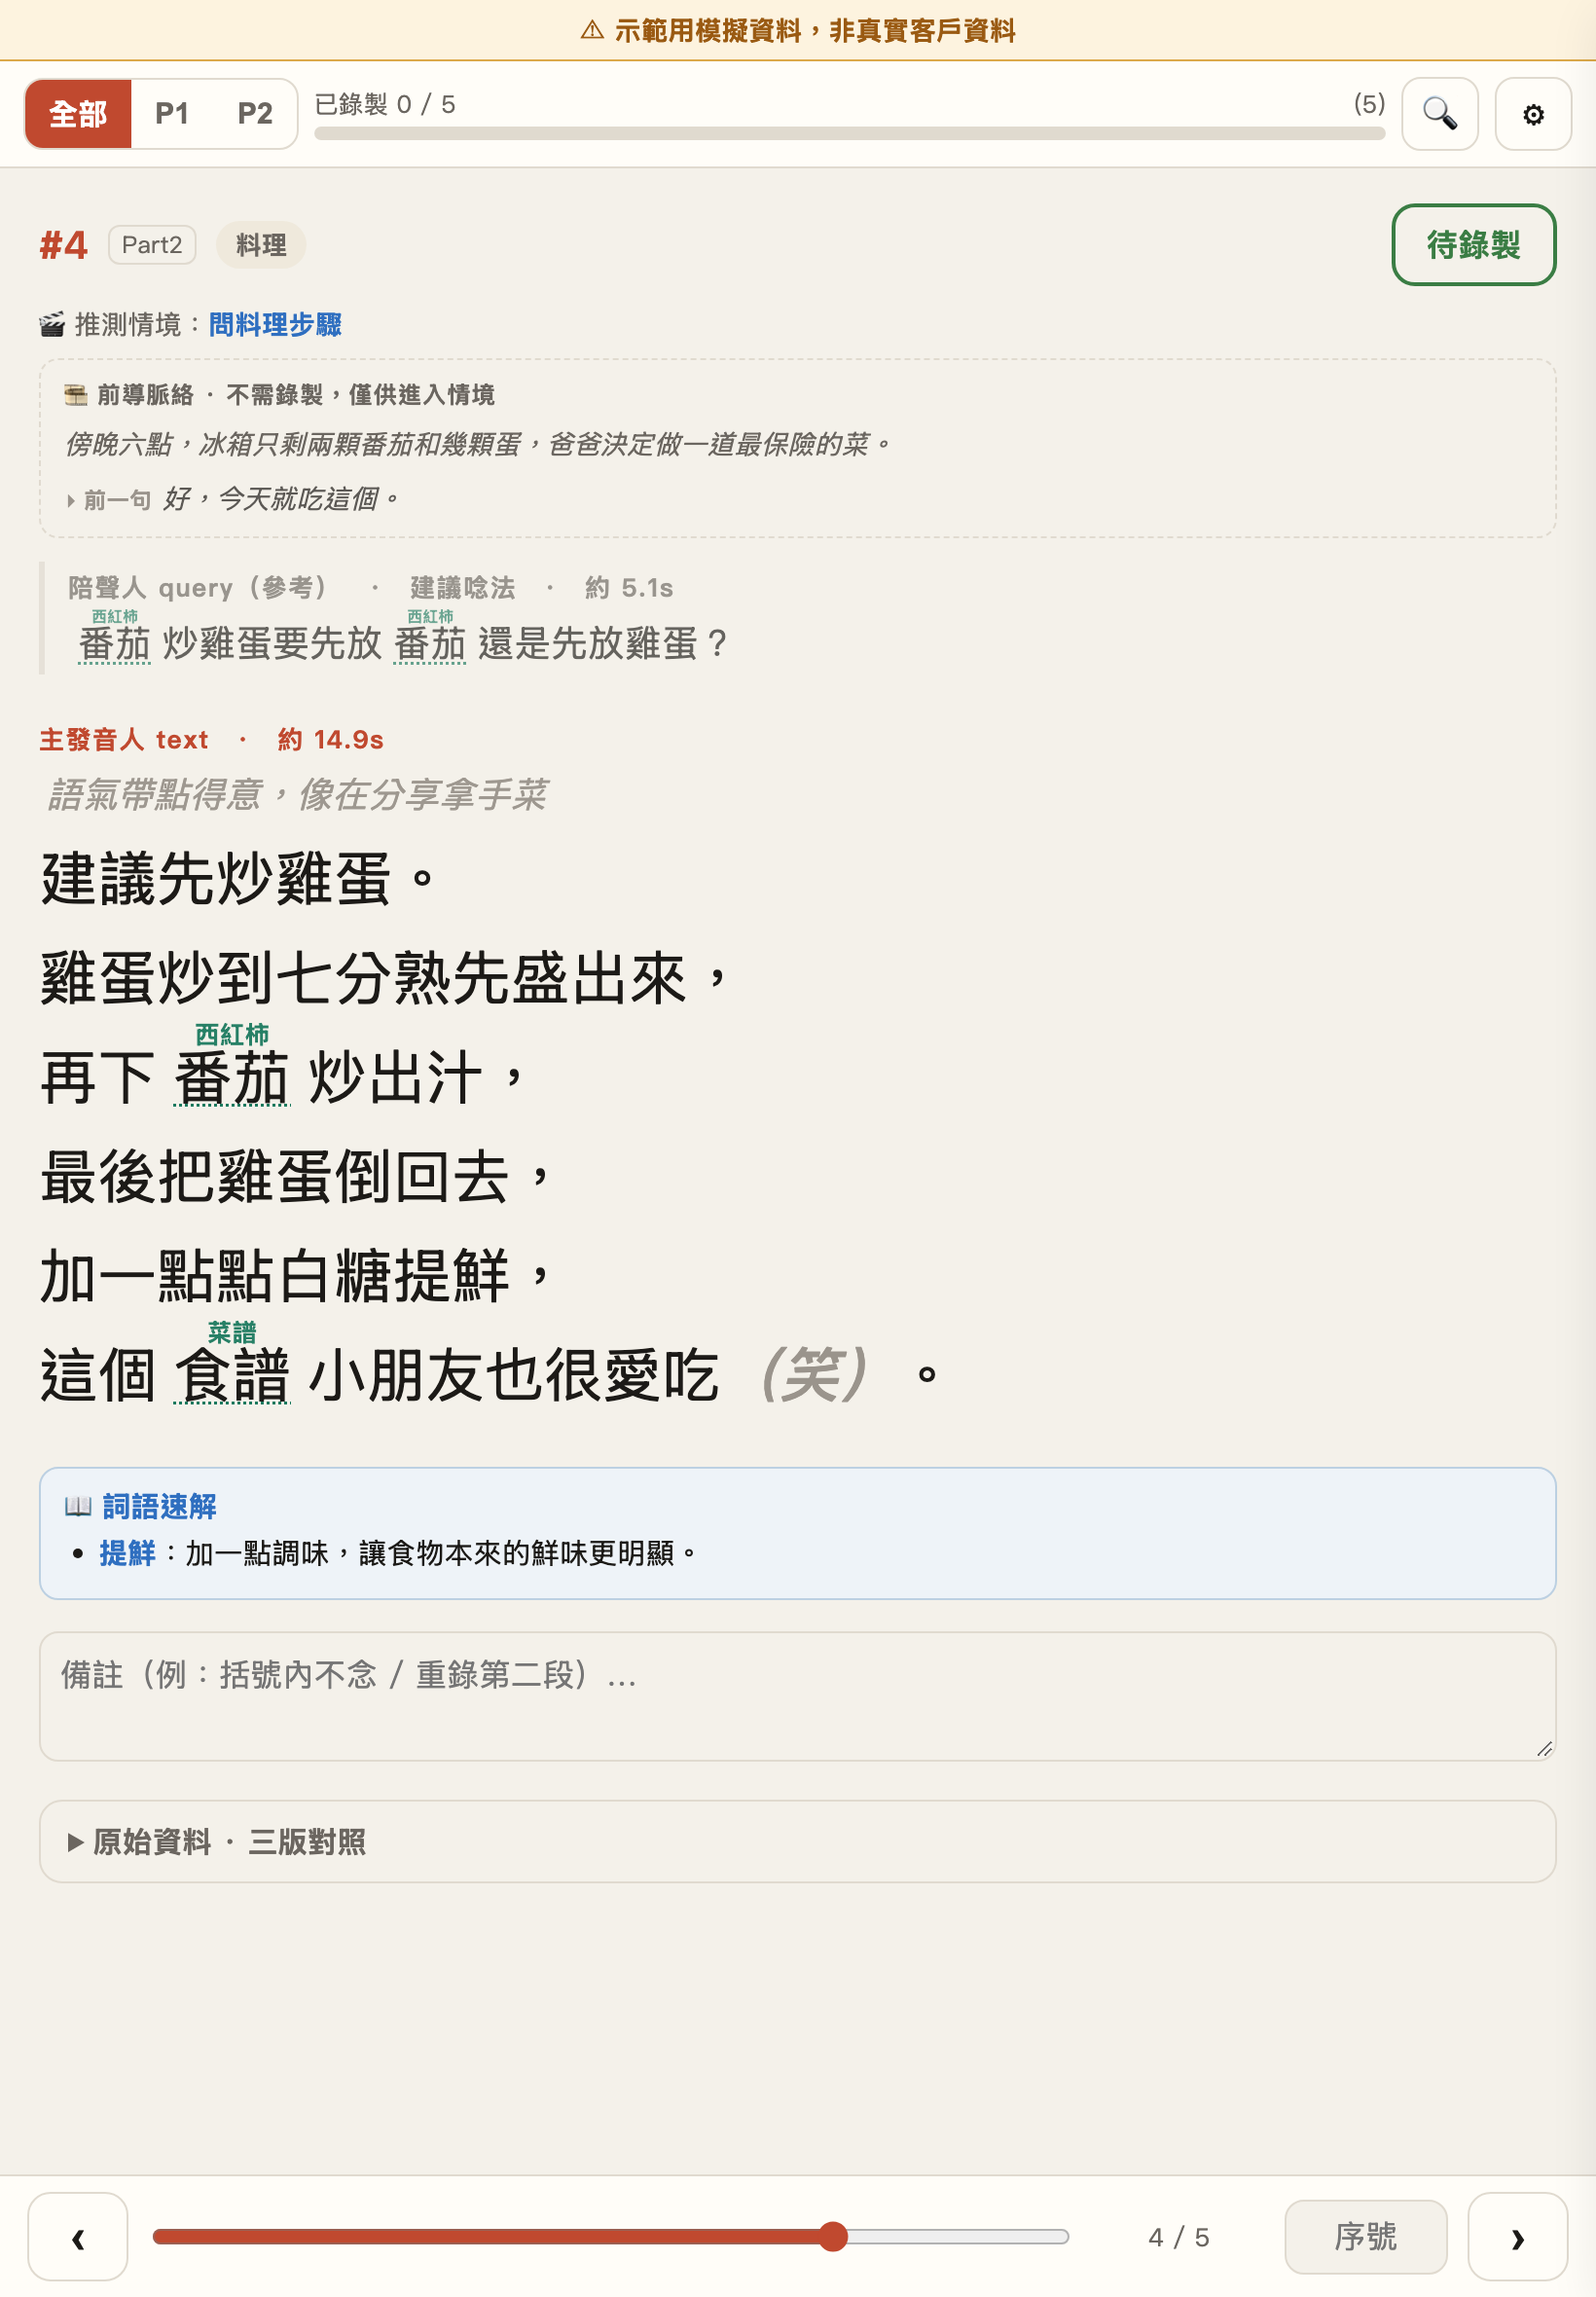
像是詞彙在地化:只換用語、不動句子,原本的詞用小字標在上面(「番茄」上面標著「西紅柿」)
昨天那句「是要照念還是換成台灣的說法?」
反正我不確定也不能決定
就讓兩個版本都能看得到,讓錄的人在現場自己和甲方討論決定
或是台灣在地化:整句改成台灣的口吻,再加上換氣的斷行和語氣提示
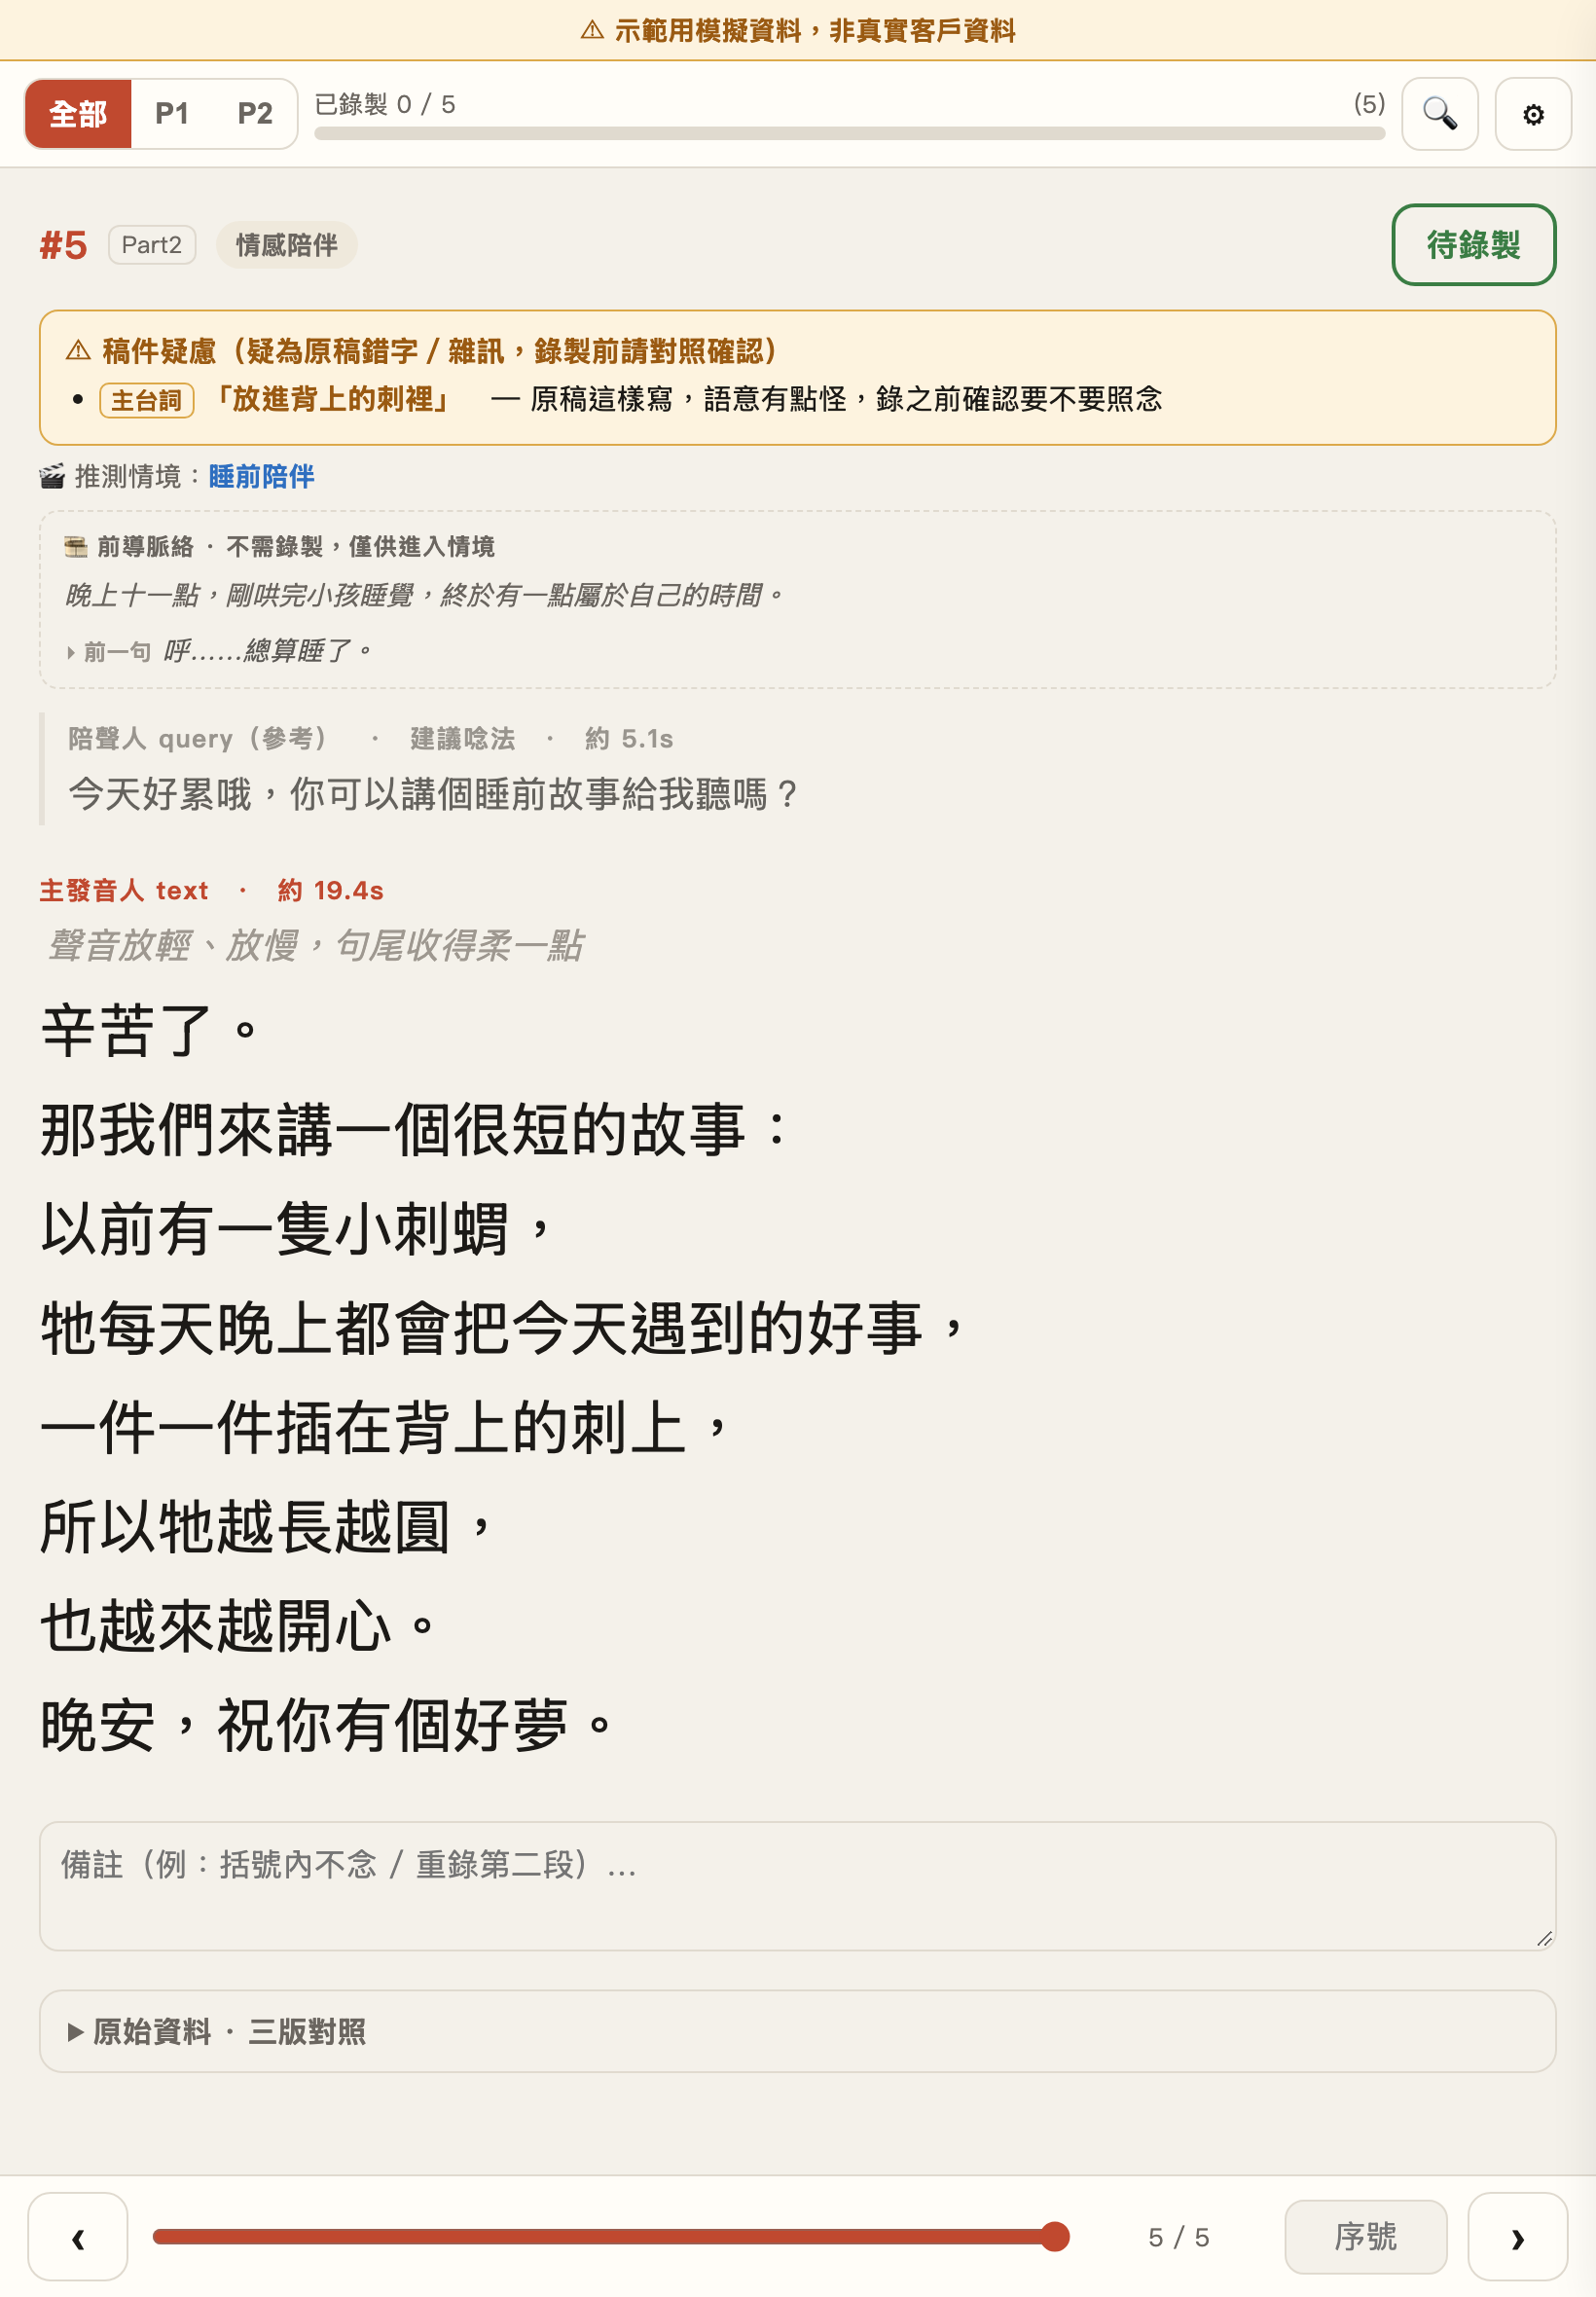
然後考慮到錄音者的閱讀省力程度
所以再設計了透過 LLM 把它分析語意之後做的斷行換氣
還記得昨天的通靈王嗎?
稿子是從對話裡截出來的,沒頭沒尾
所以每一句前面,我都會讓 AI 先幫忙推測一下
當然這些都不用錄
不過可以讓老婆在錄音的時候比較好入戲
另外,原稿其實是語音轉文字出來的
常常會有重複、或是旁邊有人插嘴
AI 會對照前後文,整理出一句念得出來的版本
原本的雜訊也會標出來,方便對照
這些都是一句一句的語意判斷
幾千句一句一句來會等很久
所以就讓 Claude Code 開好幾個子代理
一批十幾、二十句,同時一起跑
Vibe Coding 小技巧
對於大量沒有前後依賴的資料處理
可以試著讓你的 AI 使用 Sub-agent(子代理) 來同步處理
至於模型的話,我有先比較過
兩個都試過,Sonnet 對這種細微的語氣、情境還抓不太到
所以要理解語意的工作,最後都交給 Opus
補充:當時應該是 Sonnet 5 / Opus 4.8 比較
不用複雜的功能
老婆覺得滿意就好(這個最重要)
一次只看一句、字夠大
簡繁、用語、斷行、情境都先整理好
而這次不是一個提示詞就結束
PDF 要先把字抽出來、轉換,再讓 AI 一批一批處理
但這個工具是當天現場緊急 Vibe Coding 出來的
就算算上等 Claude Code 產出的時間
都比在那邊慢慢用反人類格式讀還要快
而後續其實還有一些微調,這邊就不展開贅述了
AI 幫忙改寫、斷行,難免會有判斷不準的時候
不過因為這邊精準度不是最要緊的
所以我在設計的時候同時保留了好幾種版本和原文
這樣就能隨時可以切回去看
至少有個保底
至此
稿子還是那份反人類的 PDF
但老婆看到的,已經是一次一句、字大大的讀稿工具
我們不改稿子,改看稿子的方式
C005 也就此宣布解決!



 iThome鐵人賽
 看影片追技術