
在 Day 16 中,我們解開了買家的金流偏好,證實分期付款是撬動 4 倍客單價的核心槓桿。
然而,當平台累積了近 10 萬筆訂單,營運主管最常問的下一個問題是:「我們平台到底有沒有忠誠的『超級大客』?誰買得最多、買得最貴?我們該把行銷預算砸在誰身上?」
在客戶關係管理(CRM)與用戶增長領域,最權威且歷久不衰的分析框架正是 RFM 模型:
R (Recency) 最近消費天數: 距離上次下單隔了多久?越近期消費的顧客,再次啟動的成本越低。
F (Frequency) 消費頻次: 終身在平台下過幾次單?消費次數代表顧客對平台的依賴度。
M (Monetary) 消費總金額: 累計貢獻了多少營收?消費總額直接決定了顧客的終身商業價值(LTV)。
今天我們將動手打造這張 RFM 客戶基底寬表,並避開 Olist 數據中最隱密的「身分識別陷阱」,
揪出全平台最具價值的超級買家!
很多新手在做客戶分群時,會習慣性直接對訂單表或顧客表裡的 customer_id 執行 groupby。
這是在 Olist 資料集中最嚴重的致命失誤!
我們先來檢驗 olist_customers_dataset 的欄位設計:
import pandas as pd

# 1. 從資料庫字典取出顧客表
customers = olist_db['olist_customers_dataset'].copy()

# 2. 檢驗兩個客戶代碼的唯一值數量
print(f"customer_id 唯一值筆數: {customers['customer_id'].nunique():,}")
print(f"customer_unique_id 唯一值筆數: {customers['customer_unique_id'].nunique():,}")
實作區 :
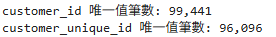
資料陷阱拆解:
customer_id: 只是單次結帳的「會話交易代碼(Session Token)」,每一次買家下單,
系統就會隨機生成一個新的 customer_id。如果拿它當分組鍵,所有人的消費頻次(Frequency)永遠等於 1!
customer_unique_id: 才是真正代表「現實生活中的同一個自然人」的真實身分識別碼。
因此,在建構任何用戶模型時,唯一的合法分組鍵只有 customer_unique_id。
我們將 Day 8 產出的有效訂單大表 valid_orders 與顧客表串聯,把顧客的真實身分找回來,
並計算每筆訂單的結帳總額(商品金額 + 運費):
# 1. 串接有效訂單與顧客真實身分
rfm_orders = pd.merge(
    valid_orders[['order_id', 'customer_id', 'order_purchase_timestamp', 'total_item_price', 'total_freight_value']],
    customers[['customer_id', 'customer_unique_id']],
    on='customer_id',
    how='inner'
)

# 2. 計算每筆訂單顧客的實際總支出(含運費)
rfm_orders['order_total_amount'] = (
    rfm_orders['total_item_price'] + rfm_orders['total_freight_value']
)

# 檢視合併樣本
rfm_orders[['order_id', 'customer_unique_id', 'order_purchase_timestamp', 'order_total_amount']].head(3)
實作 :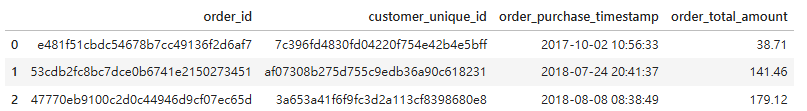
在計算 Recency(距離上次購買天數)時,標準公式為:
Recency = 時間基準日 - 該顧客最後一次下單時間
在即時生產環境中,基準日通常是 datetime.now()。
但在分析歷史資料集時,若直接拿今天的日期去減,所有顧客的 Recency 都會落在數千天以上,
徹底失去相對比較的意義。
專業作法:
以資料集中「最後一筆訂單發生的隔天」作為虛擬的分析基準日(Snapshot Date):
# 取資料集中最大購買日期的次日為基準日
snapshot_date = rfm_orders['order_purchase_timestamp'].max() + pd.Timedelta(days=1)
print(f"RFM 計算基準日 (Snapshot Date): {snapshot_date.strftime('%Y-%m-%d %H:%M:%S')}")
實作區 :

現在我們以 customer_unique_id 為核心,使用一氣呵成的聚合語法提煉每位顧客的 R、F、M 原始數值:
# 依顧客真實身分聚合計算 RFM 指標
rfm_table = rfm_orders.groupby('customer_unique_id').agg(
    # Recency: 基準日減去最近一次下單日(換算為天數)
    recency=('order_purchase_timestamp', lambda x: (snapshot_date - x.max()).days),
    # Frequency: 該用戶累計下過幾張有效訂單
    frequency=('order_id', 'nunique'),
    # Monetary: 該用戶累計貢獻的總營收
    monetary=('order_total_amount', 'sum')
).reset_index()

# 整理數值位數
rfm_table['monetary'] = rfm_table['monetary'].round(2)

# 檢視 RFM 表前五筆資料
rfm_table.head(5)
實作:
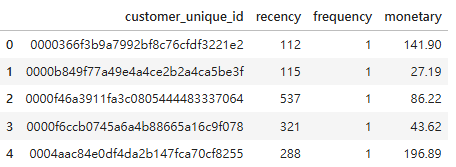
建好寬表後,我們下 .describe() 檢驗數據分佈,並找出全平台累計消費最高與下單次數最多的「超級大戶」:
# 1. 檢視分佈統計
print(rfm_table[['recency', 'frequency', 'monetary']].describe().round(2))

# 2. 依消費金額 (Monetary) 降冪排序,檢視全平台 Top 5 超級大客
top_spenders = rfm_table.sort_values(by='monetary', ascending=False).head(5)
print("\n--- 全平台累計消費金額 Top 5 買家 ---")
print(top_spenders)
實作區 :
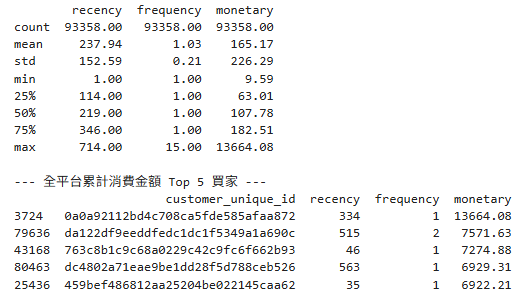
從數據看出的殘酷真相與驚人發現:
- 消費頻次(Frequency)的殘酷真相:
frequency 的 75% 甚至 95% 分位數全部都是 1!全平台近 10 萬名獨立買家中,
超過 96% 的人終身「只買 過這一次」。這反映了電商平台獲取新客成本極高,
但回購率卻極度疲軟的營運危機。- 誰是全平台最強大客?
雖然回購次數普遍只有 1~2 次,但頂級超級大戶的消費力驚人:
> - 榜首買家累計消費金額飆破 13,000 BRL(是全體平均客單價 165 BRL 的近 80 倍!)。
> - 這些大客往往是集中採購高單價電子產品、專業設備或批發用途的個人商家。
今天我們完成了電商用戶價值建模最重要的一哩路:
身分代碼校正: 識破 customer_id 陷阱,堅持以 customer_unique_id 確保頻次計算精準。
確立基準錨點: 掌握歷史數據分析中設定 Snapshot Date 的標準 SOP。
完成 RFM 寬表: 產出近 10 萬名買家的 R、F、M 原始特徵,並鎖定了頂級大客的名單。
我們發現 Frequency 有超過 96% 都是 1,如果直接使用傳統的五等分位數(pd.qcut)來打分數,
程式一定會報錯(因為分位點重複無法切分)。
明天 Day 18,我們將展示如何運用量身打造的自訂評分分箱(RFM Scoring),
並正式將顧客劃分為「核心 VIP」、「潛力新客」、「流失警戒群」等具備落地指導價值的客群名單!


 iThome鐵人賽
 看影片追技術