
在 Day 17 中,我們成功避開了身分代碼陷阱,產出了近 10 萬名獨立買家的 R、F、M 原始數值。
但如果今天你拿著一張寫滿 recency=145, frequency=1, monetary=182.5 的表格走進營運主管的辦公室,
主管只會問你一句話:
「所以呢?下週的行銷預算有 50 萬,我們該發簡訊給誰?優惠券要給多少面額?誰快跑了需要挽回?」
資料分析師的價值,在於將抽象的統計指標轉譯為具體的商業決策。
今天,我們將解決 Frequency(消費頻次)極端偏態的評分難題,
打造出電商領域極具代表性的「顧客價值金字塔(Customer Value Pyramid)」,
並輸出可以直接交付行銷團隊執行的「分群行銷決策地圖」!
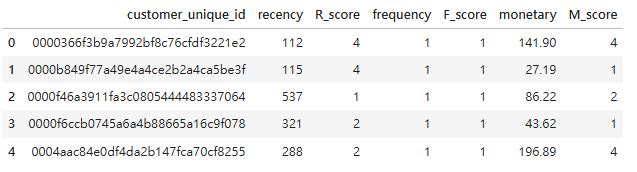
在將顧客分群前,我們必須先將單位不同的 R、F、M(天數、次數、金額)統一標準化為 1~5 分的量度。
此時初學者最容易踩的坑,就是照抄教科書對三個欄位通通使用 pd.qcut(q=5)。
在 Day 17 的探索中我們已知:全平台有超過 96% 的顧客終身只買過 1 次。
分位切點全部擠在「1」,直接下 qcut 會立刻觸發 ValueError: Bin edges must be unique 錯誤而中斷。
實務解法:R (Recency): 天數分佈平滑,使用 pd.qcut 切成 5 等分。
天數越少代表越近消費,分數越高(5 分 to 1 分)。
M (Monetary): 消費總額呈現連續長尾分佈,使用 pd.qcut 切成 5 等分。
金額越高分數越高(1 分 to 5 分)。
F (Frequency): 採用基於業務規則的自訂分箱(Rule-based Binning):
買 1 次(大盤主力新客):給 1 分
買 2 次(成功產生首次回購):給 3 分
買 3 次以上(平台忠誠大客):給 5 分
import pandas as pd
import numpy as np

# 複製 Day 17 的寬表,確保原始數據不被污染
rfm_scored = rfm_table.copy()

# 1. Recency 打分:天數越少代表越活躍,給予高分 (5 -> 1)
rfm_scored['R_score'] = pd.qcut(
    rfm_scored['recency'],
    q=5,
    labels=[5, 4, 3, 2, 1]
).astype(int)

# 2. Monetary 打分:金額越高貢獻越大,給予高分 (1 -> 5)
rfm_scored['M_score'] = pd.qcut(
    rfm_scored['monetary'],
    q=5,
    labels=[1, 2, 3, 4, 5]
).astype(int)

# 3. Frequency 自訂業務打分:優雅破解極端偏態
def score_frequency(freq):
    if freq == 1:
        return 1
    elif freq == 2:
        return 3
    else:
        return 5

rfm_scored['F_score'] = rfm_scored['frequency'].apply(score_frequency)

# 檢視標準化成果
rfm_scored[['customer_unique_id', 'recency', 'R_score', 'frequency', 'F_score', 'monetary', 'M_score']].head(5)
實作區:
三維指標各有 5 個級別,理論上有 $5 * 5 * 5 = 125 種排列組合。
如果全數拋給行銷人員,只會造成溝通災難。
在真實業務場景中,由於 Frequency 整體偏低,
我們通常會將 F 與 M 合併為綜合「價值維度 (Value Score)」,
再與代表「活躍維度」的 R (Recency) 交叉定位,將近 10 萬名買家歸入顧客價值金字塔的 5 大核心層級:
# 1. 計算綜合價值分 (FM_score)
rfm_scored['FM_score'] = ((rfm_scored['F_score'] + rfm_scored['M_score']) / 2).round(1)

# 2. 定義金字塔 5 大層級映射邏輯
def assign_pyramid_tier(row):
    r = row['R_score']
    fm = row['FM_score']

    # 頂層:核心 VIP (最近有買、頻次高或金額極高)
    if r >= 4 and fm >= 3.5:
        return 'Tier 1: 核心 VIP (Champions)'
    # 中高層:潛力忠誠客 (近期消費、價值中上)
    elif r >= 3 and fm >= 2.5:
        return 'Tier 2: 潛力忠誠客 (Potential Loyalists)'
    # 中層:平價新買家 (近期首購、客單偏低)
    elif r >= 3 and fm < 2.5:
        return 'Tier 3: 平價新客 (Promising)'
    # 中低層:流失警示客 (過去的高價值客戶,但許久未回訪)
    elif r < 3 and fm >= 3.0:
        return 'Tier 4: 高價值流失警示 (At Risk)'
    # 底層:沉睡與已流失客群 (低價值且長時間無互動)
    else:
        return 'Tier 5: 沉睡流失客 (Lost)'

rfm_scored['pyramid_tier'] = rfm_scored.apply(assign_pyramid_tier, axis=1)
金字塔搭建完成後,我們立刻依據層級聚合,檢視各層級的人數佔比與 GMV 貢獻度:
# 依金字塔層級聚合人數與總消費金額
pyramid_summary = rfm_scored.groupby('pyramid_tier').agg(
    customer_count=('customer_unique_id', 'count'),
    total_gmv=('monetary', 'sum'),
    avg_spend=('monetary', 'mean'),
    avg_recency=('recency', 'mean')
).reset_index()

# 計算佔比 (%)
pyramid_summary['customer_share_pct'] = (pyramid_summary['customer_count'] / pyramid_summary['customer_count'].sum() * 100).round(2)
pyramid_summary['gmv_share_pct'] = (pyramid_summary['total_gmv'] / pyramid_summary['total_gmv'].sum() * 100).round(2)
pyramid_summary['avg_spend'] = pyramid_summary['avg_spend'].round(1)
pyramid_summary['avg_recency'] = pyramid_summary['avg_recency'].round(1)

# 依金字塔層級排序輸出
pyramid_summary.sort_values(by='pyramid_tier')
實作區 :
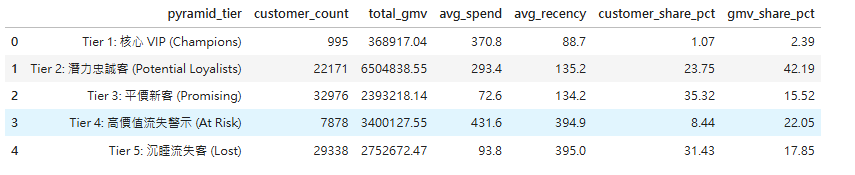
有了這張金字塔,分析師就能端出一張清晰的「分群行銷策略矩陣」,直接指導營運、廣告與 CRM 團隊的每日行動:
| 金字塔層級 | 客群特徵與痛點 | 核心行銷目標 | 具體溝通手段與戰術 | 預算配置權重 |
|---|---|---|---|---|
| Tier 1: 核心 VIP(Champions) | 最近剛買、高頻回購或超大額消費;平台的營收基石。 | 維繫尊榮感防止跳槽至競業 | 1. 專屬 VIP 客服管道與新品搶先購2. 贈送無門檻免運通行證3. 嚴禁頻繁用廉價折價券打擾 | ⭐️⭐️⭐️⭐️⭐️(高邊際 ROI) |
| Tier 2: 潛力忠誠客(Potential Loyalists) | 近期有消費、客單價高,但尚未養成跨品類回購習慣。 | 促成二回購推動升級為 VIP | 1. 下單後 14~21 天內推播關聯配件優惠2. 滿額升級 VIP 禮遇提示3. 跨品類推薦(如買手機推耳機) | ⭐️⭐️⭐️⭐️(最具成長潛力) |
| Tier 3: 平價新客(Promising) | 最近剛完成首購,但購買金額偏低、單件商品。 | 提高客單價建立平台認知 | 1. 發送階梯式滿減券(如滿 150 折 20)2. 購物車湊單包郵推薦3. 熱銷爆款榜單推播 | ⭐️⭐️⭐️(重在拉高單筆金額) |
| Tier 4: 高價值流失警示(At Risk) | 過去曾是大客戶(貢獻高),但已超過半年未下單! | 緊急召回避免永久流失 | 1. 專屬回娘家大額抵用券(Win-back Voucher)2. 主動關懷推播:「我們想念您」+ 專屬折扣3. 滿意度問卷調查(是否曾遭遇物流延遲?) | ⭐️⭐️⭐️⭐️(防止高價值資產蒸發) |
| Tier 5: 沉睡流失客(Lost) | 超過一年未回訪,且過去僅消費極低金額。 | 低成本觸達嚴格控制預算 | 1. 切忌投放昂貴的 SMS / 簡訊廣告2. 僅在雙 11 或黑五等全站大型狂歡節利用 EDM 廣播3. 停止日常付費廣告 Retargeting | ⭐️(預算最小化) |
今天我們完成了從演算法除錯到商業決策賦能的完整跨越:
防呆評分落地: 理解真實電商數據的偏態本質,以自訂規則破解 Frequency 的分位點衝突。
搭建價值金字塔: 將複雜的多維數據收斂為 5 大階層,具象化呈現買家的商業價值分佈。
交付行銷決策地圖: 針對每個層級制定清晰的作戰目標、觸達工具與預算優先級,
讓數據分析真正成為驅動業務增長的引擎。
看著金字塔底層那群龐大的「流失客群」,一個更深層的疑惑油然而生:
「過去兩年裡,每個月進來的新客人,到底是在第幾個月迅速流失的?
平台的顧客留存體質,究竟有沒有隨時間變好?」
明天 Day 19,我們將迎戰電商領域最硬核、也是高階面試必考的靈魂指標——用 Pandas 實作月度顧客留存隊列分析(Cohort Retention Analysis)!


 iThome鐵人賽
 看影片追技術