
Day10 說了 Skills 的機制:只有名稱和描述常駐在 system prompt,完整內容要模型自己用 read 去載入。今天量它值多少。
Task 模型加一個 due_date 欄位,並依照專案的六步驟遷移流程完成(改 schema、重新產生模型、寫 migration 檔、更新 INDEX、改 API schema、跑檢查)。skill_off vs skill_on。差別只有一個變數——有沒有掛上那份 taskapp-migration 的 SKILL.md。AGENTS.md,而且兩組專案裡的 docs/migrations.md 都在。也就是說,skill 提供的資訊,在沒有 skill 的那一組其實也找得到,只是要自己翻。gpt-5.6-luna,thinking level medium。| 條件 | 成功 | 成本中位數 | tokens 中位數 | 工具呼叫中位數 | 耗時中位數 |
|---|---|---|---|---|---|
| 無 Skill | 5/5 | $0.0094 | 90,108 | 31 | 89s |
| 有 Skill | 5/5 | $0.0045 | 42,915 | 16 | 34s |
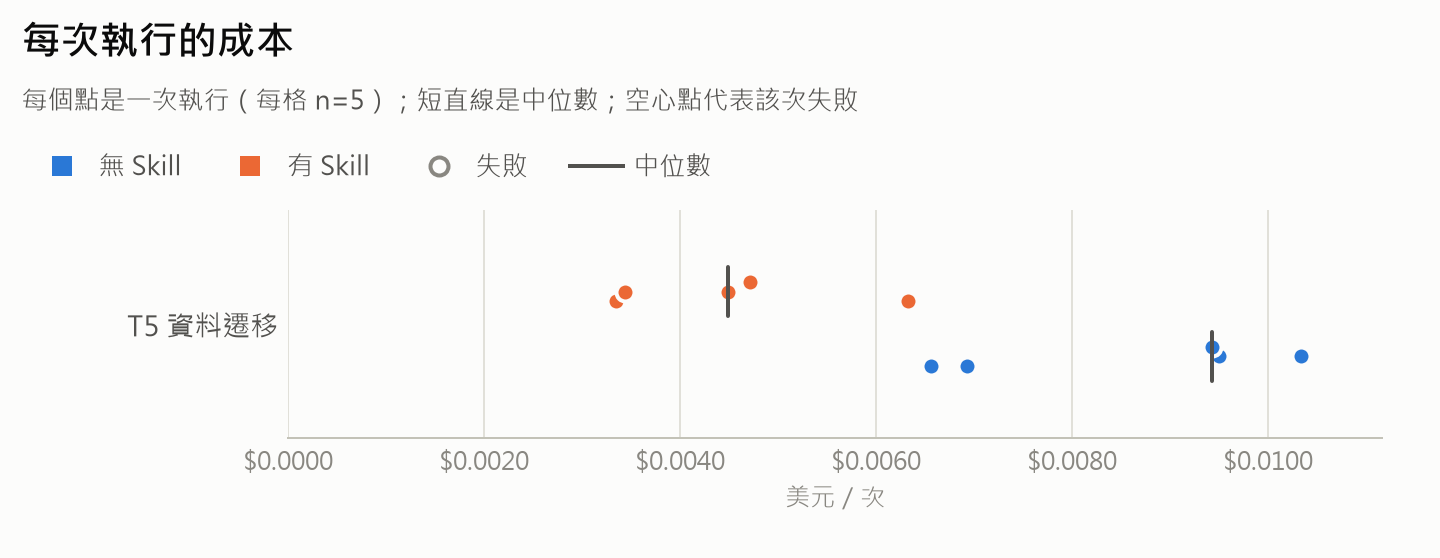
成功率完全一樣,成本卻差一倍。
這跟 Day9 看到的是同一件事:成功率這個指標在這種任務上已經頂到天花板,訊號跑到效率那邊去了。如果只看成功率,結論會是「skill 沒用」——那會是完全錯誤的結論。
Day10 說過,skill 有一個 AGENTS.md 不會有的失敗模式:模型可能根本沒去讀。所以這個實驗一定要同時量載入率。
量測台從 session 記錄裡撈出每一次 read 的路徑,只要有讀到 SKILL.md 就算載入:
| 執行 | 讀了 SKILL.md | 總 read 次數 | 工具呼叫 | 成本 |
|---|---|---|---|---|
| skill_on r01 | 是 | 9 | 16 | $0.0033 |
| skill_on r02 | 是 | 16 | 24 | $0.0047 |
| skill_on r03 | 是 | 8 | 15 | $0.0034 |
| skill_on r04 | 是 | 9 | 18 | $0.0063 |
| skill_on r05 | 是 | 9 | 16 | $0.0045 |
5 次全部都讀了。 載入率 100%。
這個數字之所以重要,是因為它讓上面那個「成本減半」的結論站得住腳。如果載入率只有 2/5,那成本差異可能是別的原因造成的,不能歸給 skill。
我猜載入率這麼高,跟描述寫得夠具體有關。那份 SKILL.md 的描述是:
Required procedure for any change to taskapp data models (adding or changing a field on User, Project, Task or Comment) ... Use whenever a task changes a taskapp model or asks for a data migration.
任務裡出現「Task 模型要新增一個欄位 due_date」,跟描述幾乎是逐字對上。如果描述只寫「處理資料相關的工作」,結果大概不會這麼漂亮。
真正有意思的是沒有 skill 的那一組在做什麼:
| 條件 | 每次執行的 read 次數 | 有沒有找到 docs/migrations.md |
|---|---|---|
| 無 Skill | 23、22、20、20、24 | 5/5 都找到了 |
| 有 Skill | 9、16、8、9、9 | 只有 1 次去翻 docs |
沒有 skill 的那一組,5 次全部都自己找到了 docs/migrations.md。 資訊一直都在,它們也都讀到了——只是為了找到它,平均多讀了十幾個檔案。
所以這個實驗量到的東西,用一句話講是:
skill 給的不是「新資訊」,是「不用找」。
專案文件寫得再完整,agent 還是得花 token 去發現它。skill 的描述等於在 system prompt 裡放了一個路標,直接把它導到正確的那份文件。省下來的是搜尋成本,不是知識。
這也解釋了為什麼成本差距(一倍)比工具呼叫次數差距(31 vs 16)更誇張:那多出來的十幾次 read,每一次的結果都會留在 context 裡,之後每一輪都要重送一遍。搜尋的代價會複利累積。
Day10 講機制的時候,我以為 skill 的主要價值是「省 system prompt 的 token」——不用把所有流程都塞進 AGENTS.md。
資料出來之後,我認為那是次要的。那份 SKILL.md 全文大約 1,560 字元,照 Day9 量到的單價(1,145 字元的 AGENTS.md 是 354 個 token)換算,就算整份塞進 AGENTS.md,每次請求也只多 480 個 token 左右。但它省下的搜尋成本是 47,000 個 token。
progressive disclosure 真正的價值不在「常駐的東西變少」,而在「模型不用自己找」。
這個結論有三個明顯的限制,我不打算藏起來:
AGENTS.md。 如果 AGENTS.md 裡本來就有一行「資料遷移看 docs/migrations.md」,無 skill 那組的搜尋成本應該會下降不少——那又是另一個實驗了。Day12 回到迴圈的「動手做」那一站,拆 Pi 的四個內建工具原始碼:它們各自對模型說了什麼、又各自設了哪些限制。


 iThome鐵人賽
 看影片追技術