

Day 11 說 ML Team 的工作是把相機畫面變成每一台車的完整旅程,detection 就是這條 pipeline 的第一棒。今天從線圈計時器的極限講起,走過資料自建、模型選擇與數據解讀,說明一套 production 等級的物件偵測是如何建立的。
得來速的計時方案已存在數十年:路面下鋪設感應線圈 (inductive loop),車輛駛過、電感改變,系統記下一個事件。這套技術成熟可靠,但它只能回答「有沒有東西壓過線圈」:分不出車輛與其他金屬物體,也答不出點餐機前與取餐窗前的兩個訊號是不是同一台車,功能因此有了天花板。而餐廳營運想知道的恰好都建立在「同一台車」之上:這台車從排隊到取餐花了多久?瓶頸卡在哪一站?
視覺則不同。一支架在高處的相機同時看得到車的位置、外觀、軌跡與多個站點,「辨識每台車、串起每段旅程」才有可能做到。把影像變成營運數據,第一步就是夠好的 detection:把每台車、每個人準確框出來,後續的 tracking 與 journey 分析全都建立在這些框之上。
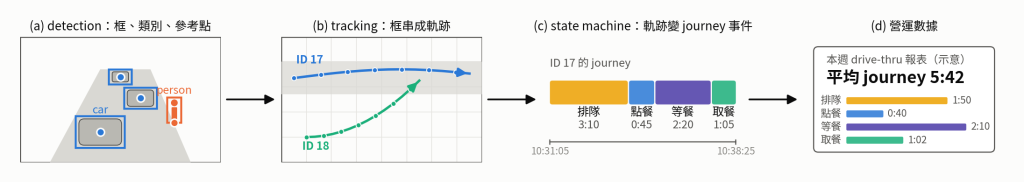
圖 1:框 → 軌跡 → journey 事件 → 營運報表。
建 detection 模型大致有三條路:用現成模型、以公開權重 fine-tune,或自建資料集完整重訓。Fine-tune 通常是成本效益最好的起點,前提是場域跟公開資料集夠像,而得來速並不是:常見的 open dataset (COCO、KITTI 與自駕車資料集) 多是平視或車載視角、以正常行駛為主;得來速的相機從高處俯視車道,車輛排隊、蠕行、倒車、跨車道。我們因此走第三條路:資料集從零自建、模型完整重訓 (負責抽特徵的 backbone 仍從 pre-trained 權重出發)。
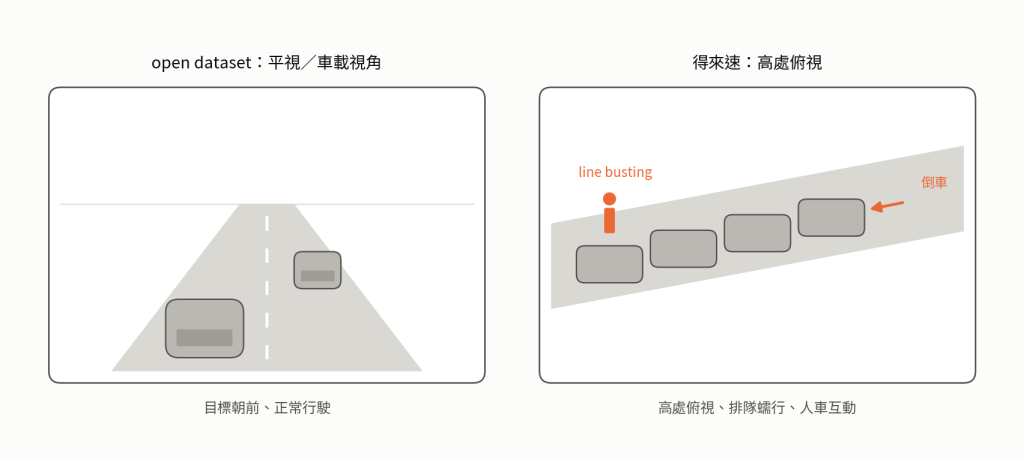
圖 2:domain gap,視角與行為分布都不同。
自建的好處是收集策略可以跟著產品需求走。例如 line busting — 尖峰時段店員走進車道、提前為排隊車輛點餐 — 這種人車緊鄰的畫面公開資料集裡幾乎沒有;又如美國常見的露營車與拖車,長寬比和轎車差很多,都得專門收集。收集的 pipeline 是混合式架構:門市的 edge server 透過 MediaMTX (Day 07) 接相機串流、擷取畫面上傳 cloud;cloud 端挑選並預標註後,匯入自建的標註平台 BerryTool (Day 19 會介紹)。標註內容高度貼合下游:除了框與類別,還有投影用的參考點、供 ReID (跨相機重新識別同一台車) 使用的識別資訊,以及 truncated、iscrowd 這類決定「這個框要不要算進 loss」的屬性標籤。
物件偵測大致分兩派:CNN (Convolutional Neural Network) 與 transformer,前者有 YOLOX、NanoDet,後者是 DETR 家族。Transformer 的準確率上限更高,但我們的產品形態限制了選擇:dashboard、streaming、detection、tracking、journey、monitoring、ops 全部跑在門市同一台 edge server 上。這個前提下 CNN 有結構性優勢:計算與記憶體對輸入呈線性 (self-attention 對 token 數是二次)。CNN 還有兩個我們想善用的 inductive bias (模型結構內建的假設):locality (相鄰的像素彼此相關) 與 translation invariance (物件移到畫面另一處,特徵不變)。Attention 沒有類似的內建機制,實務上就得用更多資料把這些規律學出來。此外,固定輸入解析度下每次 forward 的 FLOPs、記憶體占用與延遲都是固定的。當一台機器要塞下整個產品,可預測性本身就是規格。
CNN 這一派內再選 anchor-free。Anchor-based detector 會先在畫面上鋪滿一組預設尺寸與長寬比的候選框 (anchor),再學習修正它們;anchor 的尺寸與長寬比要根據資料分布調,對露營車、拖車這類極端長寬比很難調好,候選框又多、正負樣本失衡。Anchor-free 直接逐點回歸物件中心與邊界,head (backbone 之後負責輸出框與類別的層) 更輕;label assignment,也就是訓練時決定哪些預測點負責哪個物件,可交給 SimOTA、NanoDet 動態分配這類學習式策略。最後以 split-head 把 multi-class head 拆成每類一個完整的 single-class head:分類、回歸、參考點到 label assignment 全部獨立,NMS (去除重疊框的後處理) 只在類別內進行,car 與 person 各自的下游任務都拿到語意完整、互不衝突的預測。
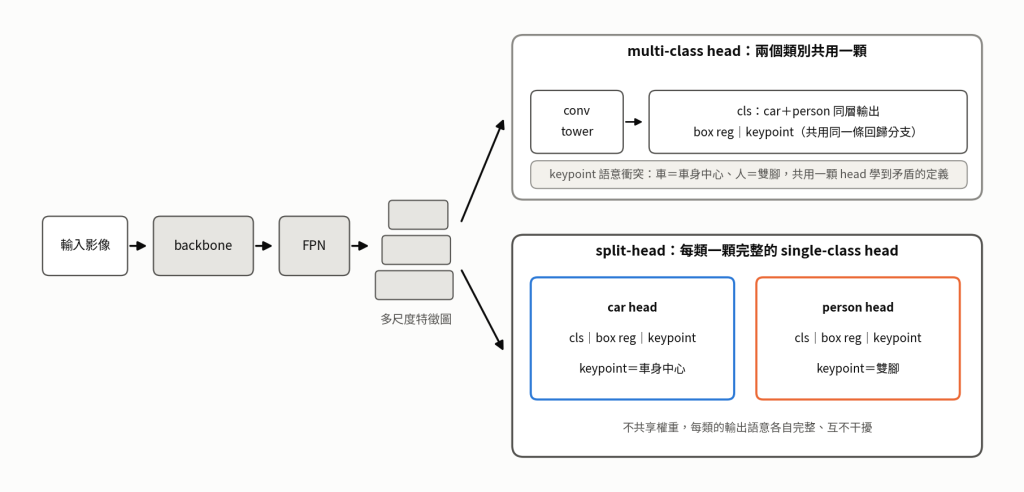
圖 3:multi-class head 的參考點 (keypoint) 語意互相矛盾;split-head 讓每類語意獨立且完整。
比較模型時我們同樣看 mAP (mean Average Precision),但那只是驗證的一半:兩種錯誤進了產品,造成的後果並不一樣。False positive (FP) 是 ghost car:雪堆、影子、反光被偵測成車 (Day 02 提過),經過 tracking 之後變成一條幽靈軌跡,報表上就會出現一台排了一整晚的車。False negative (FN) 是 missing car:車沒被偵測到或中途斷軌,一台車被拆成兩段較短的 journey,統計數字反而「變漂亮」,因為一個長 track 會斷成多個服務時間更短的 track。
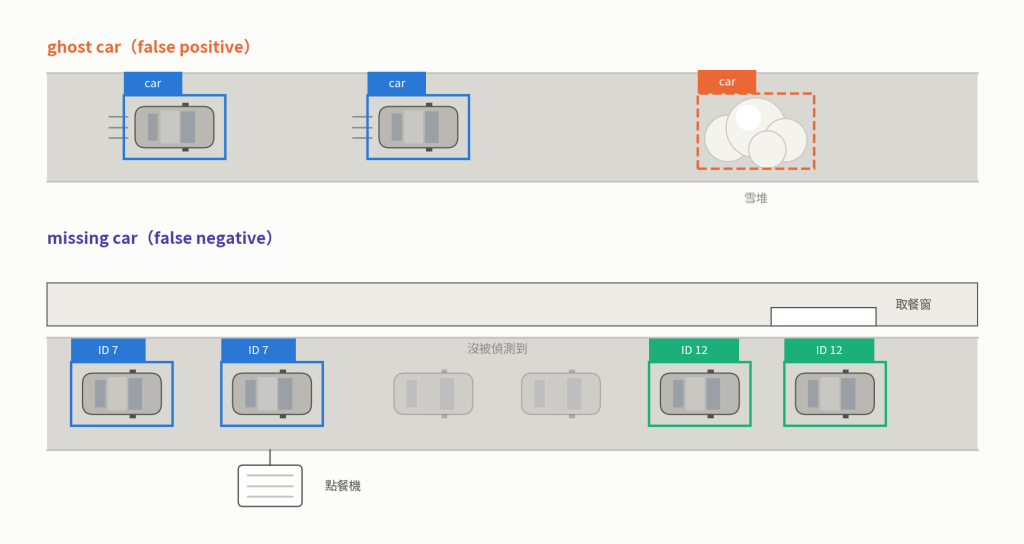
圖 4:上圖的雪堆被偵測成 car,產生一條不存在的軌跡;下圖的車在中段沒被偵測到,同一台車被斷成 ID 7 與 ID 12 兩段。
兩者在客戶眼中的成本並不對稱。Ghost car 是看得見的錯:店經理抬頭就能對照現場,傷的是資料可信度;missing car 是看不見的錯:車流被低估、瓶頸被錯估,且最常發生在車多遮擋的尖峰,傷的是統計代表性。所以結論很直接:mAP 用來選模型,operating point (confidence 門檻設在哪) 用來面對客戶,門檻往哪邊移是商業成本的決定。對 ghost car 從嚴,以 confidence 與軌跡持續性雙重把關;對 missing car 靠資料補,弱場景回頭餵給收集清單。至於準確率如何被系統性量測與追蹤,Day 17 有一篇 ALI / ALO 專文,先賣個關子。
回顧這一篇:起點是線圈答不了的「同一台車」問題;自建資料讓標註規格跟著產品需求走;CNN 與 anchor-free 讓模型塞得進同一台 edge server;split-head 給每個下游任務乾淨的語意;驗證則把 FP 與 FN 翻譯成商業成本。Detection 交出的框還沒有身分,這一幀與下一幀、A 相機與 B 相機之間的框互不相識。明天的 calibration 與 tracking,會把這些無名的框串成一台車從進店到離開的完整旅程。
本系列由 Berry AI 工程團隊出品。更多工程實戰紀錄都在 Berry AI 技術部落格。


 iThome鐵人賽
 看影片追技術