

昨天把專員的設計原則訂完,今天做第一位:W1 查單專員。它的工作只有一件事,收到工單、查訂單、回報事實。
這篇會把整個 workflow 拆開講,包含兩個入口、三個工具、一個輸出契約,以及一個用程式把關的守門員。最後是實測結果,還有兩個我目前還沒解掉的問題。
W1 的結構如下圖,工單從左邊進來,回報從右邊出去,中間經過兩個 Code 節點。
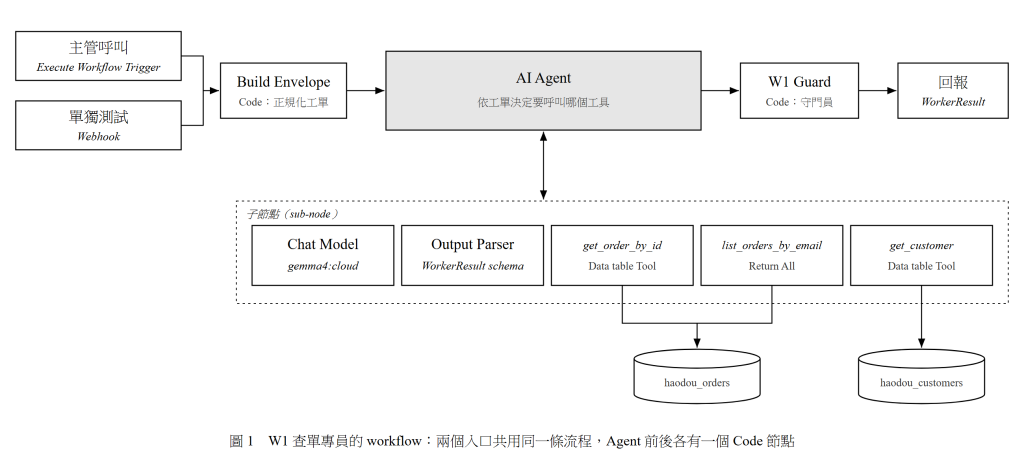
兩個觸發節點都接到同一個 Code 節點。被主管呼叫時走 When Executed by Another Workflow,我自己測試時走 Webhook。
留一個 Webhook 入口是為了能單獨測試。主管要到第三週才會出現,在那之前 W1 得先能自己跑;之後出考卷時也是直接丟工單進 Webhook,不經過主管。如果 W1 只能被主管呼叫,出問題時就分不清是誰的錯。
Execute Workflow Trigger 的 Input source 選 Define using fields below,欄位要先列出來,主管呼叫時才有東西可以填:
| 欄位 | 型別 | 用途 |
|---|---|---|
| task_id | String | 工單編號,回報時原樣帶回 |
| question | String | 要查什麼,一句話 |
| order_id | String | 訂單編號,可能沒有 |
| customer_email | String | 客人 email,可能沒有 |
| need_csv | String | 主管需要的欄位,逗號分隔 |
| facts_known | Object | 主管已知的事實,編號和 email 也可能包在這裡 |
| need | Array | 需要回報的欄位,陣列形式 |
| attempt | Number | 第幾次嘗試 |
| retry_reason | String | 上次被退件的原因 |
Webhook 節點設 POST、路徑 lab-w1,Respond 選 When Last Node Finishes、Response Data 選 First Entry JSON。這樣整條流程跑完之後,最後一個節點的輸出會直接當成 HTTP 回應送回來,測試時看得到完整的回報。
測試用的工單長這樣:
{
  "task_id": "t001",
  "question": "查出訂單 A10293 的狀態、物流與預計到貨時間",
  "order_id": "A10293",
  "need_csv": "status,carrier,tracking_no,eta"
}
提醒一個踩過的坑:在 Git Bash 裡用 curl 送含中文的 JSON,到 n8n 會變成亂碼。我後來都改用 Node 送:
const r = await fetch('http://localhost:5678/webhook/lab-w1', {
  method: 'POST',
  headers: { 'Content-Type': 'application/json' },
  body: JSON.stringify(task),
});
console.log(JSON.stringify(await r.json(), null, 2));
兩個入口進來的資料格式不一樣:Webhook 的內容包在 body 裡,主管呼叫時則在最上層。所以第一個節點是 Code,把兩種來源整理成同一個形狀:
const raw = $input.first().json;
const i = raw.body ?? raw;
const known = i.facts_known ?? {};

// 訂單編號清理:全形轉半形、去掉 # 與空白、轉大寫
const orderId = String(i.order_id ?? known.order_id ?? '')
  .normalize('NFKC').replace(/[#\s]/g, '').toUpperCase();
const email = String(i.customer_email ?? known.customer_email ?? '').trim().toLowerCase();
const need = Array.isArray(i.need)
  ? i.need
  : String(i.need_csv ?? '').split(',').map(s => s.trim()).filter(Boolean);

return [{
  json: {
    task_id: i.task_id || `t_${Date.now()}`,
    worker: 'order_lookup',
    question: i.question ?? '',
    facts_known: {
      ...(orderId ? { order_id: orderId } : {}),
      ...(email ? { customer_email: email } : {}),
    },
    need,
    attempt: Number(i.attempt) || 1,
    retry_reason: i.retry_reason ?? '',
  },
}];
訂單編號的清理刻意放在程式裡。客人信裡會寫成 #a10293、A10293 、全形的 A10293,這些都該查到同一張單。規則是確定的,寫成三個字串操作就結束了。交給模型做的話,要多一次推理,而且不保證每次都一樣。
這條規則後面真的派上用場:測試裡有一張工單的編號是 #a10293,帶井號、小寫、尾巴還有一個空白,正規化之後正常查到。
W1 有三個工具,都是 Data table Tool 節點:
| 節點名稱 | Data table | 篩選條件 | Return All |
|---|---|---|---|
| get_order_by_id | haodou_orders | order_id 等於參數 | 否 |
| list_orders_by_email | haodou_orders | email 等於參數 | 是 |
| get_customer | haodou_customers | email 等於參數 | 否 |
list_orders_by_email 一定要打開 Return All。一位客人名下有多張訂單,少了這個設定只會拿回第一筆,而且不會有任何錯誤訊息,等於安靜地少給資料。
篩選條件的值欄位填的是運算式,由模型決定要填什麼:
={{ $fromAI('order_id', '訂單編號,格式為 A 加 5 位數字,例如 A10293', 'string') }}
工具描述我寫成三段:做什麼、什麼時候用、什麼時候不要用。最後一段是關鍵,三個工具並存時,模型要先選對工具才有機會查對資料:
用訂單編號查詢單一筆訂單的完整資料。
使用時機:已經知道訂單編號時。
輸入:訂單編號(格式 A + 5 位數字)。
若你手上沒有訂單編號,不要使用此工具,改用 list_orders_by_email。
Day 04 試過單一工具的長短描述,行為沒有差別。三個工具並存的情況我沒有另外做對照實驗,描述就照上面的寫法。
你是「好豆選物」的訂單查詢專員。你的唯一工作是:
根據主管給你的工單,從訂單系統查出正確的事實並回報。

## 你的職責邊界
- 你只回報事實,不寫給客人看的回信。
- 你不判斷這件事該怎麼處理,那是主管的工作。
- 你不猜測、不推論、不補充資料庫裡沒有的東西。

## 可用工具
- get_order_by_id:已知訂單編號時使用
- list_orders_by_email:只知道 email 時使用,會回傳該客戶所有訂單
- get_customer:僅在工單的 need 包含 tier 或 notes 時使用

## 查詢策略
1. 如果工單有 order_id → 用 get_order_by_id
2. 如果沒有 order_id 但有 customer_email → 用 list_orders_by_email
3. 如果 list_orders_by_email 回傳多筆,全部回報,不要自己挑
4. 兩者都沒有 → 不要呼叫任何工具,直接回報 insufficient_info
5. 工具呼叫上限 3 次

## 訂單狀態的中文說法(回報時請用中文,並保留原始英文值)
pending_payment = 待付款(尚未收到款項)
packing         = 備貨中(已收款,正在出貨準備)
shipped         = 已出貨(在物流途中)
delivered       = 已送達
returning       = 退貨處理中(客戶已申請退貨,正在處理)
cancelled       = 已取消

## 回報規則
- facts 陣列中每一筆都必須有 source,格式為 orders!<訂單編號> 或 customers!<email>
- 沒有 source 的資料不要放進 facts
- 查不到資料時回報 status = not_found,這是正確的行為,不是失敗
- 資訊不足無法查詢時回報 status = insufficient_info,並在 missing 陣列列出缺什麼
- 絕對不要編造訂單編號、物流編號或日期

## 特別注意
returning 的意思是「客戶申請退貨,我們正在處理」,
不是「商品正在退回給客戶」。不要搞反方向。
最後那段是補上去的。returning 這種狀態名稱本身就有方向性的歧義,模型很容易講成「商品正在退回給您」,意思就反了。資料庫欄位的語意跟字面不一致時,prompt 裡要直接寫清楚。
狀態對照表也不是為了好看。訂單表存的是 shipped、packing 這些英文值,但回報要給人看,中英對照寫在 prompt 裡,模型才不會每次翻得不一樣。至於它是不是真的每次都照做,後面會講。
Agent 節點的 User Message 用運算式組出來,把工單的欄位攤平:
工單編號:{{ $json.task_id }}
第 {{ $json.attempt }} 次嘗試
要查什麼:{{ $json.question }}
已知事實:{{ JSON.stringify($json.facts_known) }}
主管需要的欄位:{{ $json.need.join(', ') }}
Max Iterations 我設 6。預設值 10 太寬,一個只該查一兩次的任務跑到十輪,通常代表它卡住了,早點停下來比較好查。
把 AI Agent 的 Require Specific Output Format 打開,下面會多一個 Output Parser 插槽,接 Structured Output Parser,Schema Type 選 Manual,然後貼這份 schema:
{
  "type": "object",
  "properties": {
    "status": { "type": "string", "enum": ["ok", "not_found", "insufficient_info", "partial", "error"] },
    "confidence": { "type": "number" },
    "facts": {
      "type": "array",
      "items": {
        "type": "object",
        "properties": {
          "key": { "type": "string" },
          "value": { "type": "string" },
          "source": { "type": "string" }
        },
        "required": ["key", "value", "source"]
      }
    },
    "answer": { "type": "string" },
    "missing": { "type": "array", "items": { "type": "string" } },
    "notes": { "type": "string" }
  },
  "required": ["status", "confidence", "facts", "answer", "missing"]
}
status 用 enum 鎖成五個值。這是整份契約裡最重要的一個欄位,主管的所有判斷都從它開始。沒有 enum 的話,模型會自己發明 success、found、completed 之類的字,下游的條件判斷就得一直補。
facts 的每一筆都要求 source,required 裡三個欄位缺一不可。這是 Day 09 說的那條規則:沒有來源的事實一律不收。
Agent 後面再接一個 Code 節點。prompt 裡寫了「沒有 source 不要放進 facts」,不代表它一定照做,這個節點負責在程式層把關:
const r = $input.first().json.output ?? $input.first().json;
const env = $('Build Envelope').first().json;

const facts = Array.isArray(r.facts) ? r.facts : [];

// 1. 沒有 source 的 fact 一律丟掉
const clean = facts.filter(f => f && f.key && f.value !== undefined && f.value !== '' && f.source);
const dropped = facts.length - clean.length;

// 2. 說「查到了」卻交不出任何有來源的事實 → 降級成 not_found
let status = r.status ?? 'error';
if (status === 'ok' && clean.length === 0) status = 'not_found';

// 3. source 格式檢查
const badSource = clean.filter(f => !/^(orders|customers)!/.test(f.source));

return [{
  json: {
    task_id: env.task_id,
    worker: 'order_lookup',
    status,
    confidence: typeof r.confidence === 'number' ? r.confidence : 0,
    facts: clean,
    answer: r.answer ?? '',
    missing: Array.isArray(r.missing) ? r.missing : [],
    notes: r.notes ?? '',
    _audit: {
      dropped_without_source: dropped,
      bad_source_format: badSource.length,
      downgraded: status !== r.status,
    },
  },
}];
第二條是整個節點的重點。模型說 status: ok 但 facts 是空的,這種回報傳到下游,主管會以為查到了,回信就會寫出「已為您確認」卻什麼都沒附上。降級成 not_found 之後,主管至少知道這條路走不通。
_audit 欄位記錄守門員做了什麼。這個欄位不給模型看,是給我自己看的,用來判斷模型到底規矩不規矩。
說句公道話:這 20 張工單跑下來,守門員一次都沒出手,dropped_without_source 全是 0,也沒有任何一筆被降級。它是保險,不是功能。我還是留著,因為 Day 07 那些「我幫您確認後回覆」的回信,就是沒有這層檢查時會發生的事。
我準備了 20 張工單當第一輪測試,涵蓋六種情況。完整的考卷設計和評分方式 Day 15 再談,這裡先看每種情況各一題的實際輸出。結果先講:20 張全部做出預期的行為。
工單問 A10293 的狀態、物流與預計到貨時間,回報是:
{
  "task_id": "W1-01",
  "worker": "order_lookup",
  "status": "ok",
  "confidence": 1,
  "facts": [
    { "key": "status", "value": "已出貨 (shipped)", "source": "orders!A10293" },
    { "key": "carrier", "value": "黑貓宅急便", "source": "orders!A10293" },
    { "key": "tracking_no", "value": "8891234567", "source": "orders!A10293" },
    { "key": "eta", "value": "2026-09-15", "source": "orders!A10293" }
  ],
  "answer": "訂單 A10293 目前狀態為已出貨 (shipped),由黑貓宅急便配送,物流單號為 8891234567,預計到貨時間為 2026-09-15。",
  "missing": [],
  "notes": ""
}
四筆事實都有來源,中英對照也照 prompt 的規定寫了。
工單只寫「客戶詢問包裹何時送達」,沒有編號也沒有 email。W1 回報 insufficient_info,missing 填 order_id, customer_email,而且完全沒有碰工具,只花了一次模型呼叫。
這是我最在意的一題。沒有合法的「我做不到」出口時,模型會硬擠一個答案出來,Day 07 那 13 封「我幫您確認後回覆」就是這樣來的。
工單給的編號是 A1029,比正常編號少一碼,像是客人打字漏掉。W1 查不到,回報 not_found。
這題是 20 題裡呼叫次數最多的:模型查了一次沒結果,又試了一輪,總共 4 次呼叫、5736 tokens,是其他題的將近兩倍。
更麻煩的是,同一題在更早一次用 npm 版 n8n 跑的時候,第一次執行直接撞上 Max Iterations 上限失敗,是重跑第二次才成功的。這種行為不穩定,不是每次都會發生。查不到資料時模型會想多試幾種做法,而「多試幾種」沒有上限。Max Iterations 設 6 在這裡擋住了失控,代價是那一次整張工單失敗。
工單寫「客戶詢問濾杯那筆訂單的出貨狀態」,只給了 email。這位客人名下有兩張訂單,W1 只回報了含濾杯的那一張,notes 寫「客戶共有兩筆訂單,僅回報包含濾杯之訂單 A10294 的資訊」。
結果是對的,但它違反了 prompt 查詢策略的第 3 條:「如果 list_orders_by_email 回傳多筆,全部回報,不要自己挑」。工單指名要濾杯那筆,規則說全部回報,兩者衝突時模型選了工單。
我沒有改 prompt。這次它選對了,但這件事說明 prompt 裡的規則是傾向,不是硬約束。真正要擋的事情,得像守門員那樣寫成程式。
工單問 A10297 目前是什麼狀況,這張單的狀態是 returning。W1 回報「退貨處理中(returning)」,沒有講成「商品正在退回給您」。prompt 裡那段特別注意有發揮作用。
兩題。一題的編號是 #a10293,正規化之後查到;另一題的工單裡故意提到客人也問了另一張舊訂單 A10295,但工單只要求 A10293。W1 只查了 A10293,notes 寫「僅查詢工單要求的 A10293,未查詢 A10295」。
| 情況 | 題數 | 模型呼叫 | tokens 中位數 | 時間中位數 |
|---|---|---|---|---|
| 要查資料 | 17 | 2 次(一題 4 次) | 3030 | 2.0 秒 |
| 資訊不足 | 3 | 1 次 | 1350 | 1.1 秒 |
20 題合計 57932 tokens。
查一次資料大約讓 token 翻倍,原因在 ReAct 迴圈的運作方式:第二次呼叫要把 system prompt、工單、模型上一輪的工具呼叫、工具回傳的整筆訂單資料全部重送一次。工具回傳的資料越大,第二次呼叫就越貴。用 email 查到兩張訂單的那三題,token 落在 3175 到 3290 之間,就比查單筆的 3030 再高一些。
延遲則有一條很長的尾巴。有一題花了 200.9 秒,代理記錄到的模型回應時間是 200.7 秒,也就是時間全花在等 Ollama Cloud,不是 n8n 卡住。其他 19 題最慢 7.5 秒,中位數 2.0 秒,同一題在其他批次也都是 2 秒上下。這種偶發的長尾在雲端模型上躲不掉,Day 24 做容錯時會回來處理。
20 張工單總共產生了 16 種不同的 key。同樣是訂單狀態,出現過這些寫法:
| key | 次數 |
|---|---|
| status | 5 |
| 訂單狀態 | 4 |
| 訂單 A10293 狀態(帶編號的各種變體) | 5 |
值的寫法也不一致。「已出貨」後面的括號,有 5 次是半形的 (shipped),1 次是全形的 (shipped)。
schema 只規定了 facts 是一個有 key、value、source 的陣列,沒有規定 key 可以填什麼。模型就每次依當下的語境自己取名。
這代表下游不能用 facts[i].key 取值。這 20 題總共回報了 14 筆跟訂單狀態有關的事實,其中只有 5 筆的 key 是 status。主管想拿「這張單的狀態」,寫 find(f => f.key === 'status') 十次有六次會落空。Day 14 要解的就是這件事。
prompt 裡寫了「回報時請用中文,並保留原始英文值」,20 題裡大部分都照做,但格式各自為政。這類「風格要求」沒辦法靠 prompt 保證,只能在驗收那一層用程式正規化。
W1 做成獨立 workflow,留了 Webhook 讓它能單獨測試;工具給三個,描述裡要寫清楚什麼時候不要用;輸出用 JSON Schema 鎖住 status 的五個值,後面再接一個 Code 節點,把沒有來源的事實丟掉、把空手的 ok 降級成 not_found。20 張工單都做出預期的行為,但 facts 的 key 命名完全沒有收斂。
明天做 W2 知識專員,從 FAQ 裡找答案。那位的成績就沒有這麼好看了。


 iThome鐵人賽
 看影片追技術