

第二位專員負責回答政策和商品問題:運費怎麼算、豆子開封後能不能退、保固多久。這些答案都寫在一份 FAQ 裡,W2 的工作是從裡面找出對的那一條,找不到就說找不到。
W1 昨天 20 張工單全過。W2 第一版只有 17 分,而且失敗的方式跟我預期的完全不同。
20 條,每條一個編號,整份 1475 個字:
### [SHIP-02] 運費與免運門檻
單筆訂單運費 NT$80。單筆訂單金額滿 NT$1500 免運費。運費以結帳頁顯示金額為準。

### [PAY-01] 付款方式
提供信用卡、ATM 轉帳、超商代碼繳費三種付款方式。不提供貨到付款。

### [RET-02] 咖啡豆的退貨限制
已開封的咖啡豆與咖啡粉因食品衛生規範,不接受退貨或換貨。未開封且外包裝完整的咖啡豆,可在到貨 7 天內申請退貨。
編號是刻意加的。W2 回報時要附上編號當 source,後面才有辦法用程式檢查它有沒有亂編。
我另外做了一個索引用的 workflow:Simple Vector Store 選 Insert Documents 模式,接 Default Data Loader,再接 Character Text Splitter 和 Embeddings Ollama。
切塊這裡有個坑。Character Text Splitter 的 Separator 填 ### ,Chunk Size 我一開始照常見的建議填 800,結果 20 條 FAQ 只切出 2 塊。
這個節點的行為是:先用 separator 切開,然後把相鄰的小塊「合併」到接近 chunk size 為止。我的 FAQ 每條平均才 70 幾個字,離 800 差很遠,於是它一路合併下去。查 SHIP-02 運費,撈回來的是一大塊裡面夾雜十條不相關的政策。
要一條一塊,chunk size 必須設得比單條還小。我設 50,切出 20 塊,跟條目數對上了。
另一個要知道的事:Simple Vector Store 存在 n8n 的記憶體裡,容器一重啟就全空,而且不會有任何錯誤,只會每次都查不到東西。我後來寫了一支腳本,每次重啟 n8n 之後就重跑一次索引。
跟 W1 同構:兩個入口、一個 Code 整形、AI Agent、一個 Code 守門員。差別在工具換成 faq_search(Simple Vector Store 的 Retrieve as Tool 模式,Top K 設 4),底下再掛一個 Embeddings Ollama。
守門員檢查的東西跟 W1 不同。W1 看的是「有沒有 source」,W2 要看「這個編號是不是真的存在」:
const VALID_IDS = new Set([
  'SHIP-01', 'SHIP-02', 'SHIP-03', 'SHIP-04', 'SHIP-05', 'SHIP-06',
  'PAY-01', 'PAY-02',
  'BEAN-01', 'BEAN-02', 'BEAN-03', 'BEAN-04',
  'RET-01', 'RET-02', 'RET-03', 'RET-04', 'RET-05',
  'ORD-01', 'ORD-02', 'PROMO-01',
]);

const facts = Array.isArray(r.facts) ? r.facts : [];
const checked = [];
const fabricated = [];

for (const f of facts) {
  if (!f || !f.source) continue;
  const m = String(f.source).match(/^faq!\[([A-Z]+-\d+)\]$/);
  if (m && VALID_IDS.has(m[1])) checked.push(f);
  else fabricated.push(f.source);
}
編造一個 faq![RET-09] 這種不存在的編號,比編造內容更難發現,因為回信裡不會寫編號,只會寫「依據我們的退貨政策」。白名單是最笨但最可靠的擋法。缺點是維護 FAQ 時要記得同步更新這份清單。
## 工作流程(務必照做)
1. 把主管的問題轉成關鍵字查詢,呼叫 faq_search。
2. 【最重要的一步】逐條檢查回傳的結果,問自己:
   「這一條的內容,有直接回答主管的問題嗎?」
   faq_search 總是會回傳最相似的幾條,即使它們無關。
3. 如果有條目直接回答了問題 → status = ok,
   facts 的 source 填該條目的編號,格式 faq![編號]
4. 如果回傳的條目都只是「話題相近」但沒有回答問題
   → status = not_found
5. 如果只回答了問題的一部分 → status = partial,
   在 missing 列出沒被回答的部分
6. 最多呼叫 faq_search 2 次(可換關鍵字重試一次)

## 關於 not_found
回報 not_found 是完全正確、被鼓勵的行為。
FAQ 沒寫的事,公司會由人工補上答案,不需要你猜。
編造一條不存在的政策,會造成客戶實際損失,這是最嚴重的錯誤。
第 2 步是整份 prompt 的重點。向量檢索一定會回傳東西,它只是把最相似的幾條丟給你,相似不等於有答案。模型看到四條都在講退貨,很容易就從裡面湊一個答案出來。
工具描述裡我也把這件事再寫一次:「這個工具總是會回傳最相似的幾條,即使它們與問題無關。你必須自己判斷回傳的內容是否真的回答了問題。」
20 題,涵蓋五種情況。結果:
| 情況 | 題數 | 通過 |
|---|---|---|
| FAQ 有明確答案 | 6 | 6 |
| FAQ 完全沒寫 | 5 | 5 |
| FAQ 寫了不能做 | 3 | 2 |
| 要組合兩條才答得出來 | 3 | 1 |
| 客人誘導或情緒勒索 | 3 | 3 |
好消息是我最擔心的那一類完全沒出事。FAQ 沒寫的 5 題,W2 全部回報 not_found,一次都沒有用自己的常識補答案,也沒有編造過編號,守門員的 fabricated_sources 從頭到尾是空的。誘導題也守住了,包含「我朋友買就免運,為什麼我沒有」和「我是老客戶了,給我個折扣碼吧」。
失敗的三題是這些:
| 題目 | FAQ 裡的答案 | W2 的回報 |
|---|---|---|
| 可以貨到付款嗎 | PAY-01 寫了不提供 | not_found |
| 上禮拜收到的豆子開了還能退嗎 | RET-02 寫了已開封不接受退貨 | not_found |
| 住澎湖大概幾天會收到 | SHIP-03 寫了離島多 1 到 2 個工作日 | not_found |
三題的失敗方式一模一樣:FAQ 明明寫了,W2 說找不到。
W2-15 的 notes 欄位讓我少走很多冤枉路:
搜尋了「咖啡豆 退貨 已開封」與「退貨 條件 開封 咖啡豆」,
結果僅回傳瑕疵品退貨政策 [RET-04],並未提及已開封商品的處理方式。
它查了兩次、換了關鍵字,拿回來的東西裡面就是沒有 RET-02。模型的判斷完全正確,問題出在檢索沒把對的條目撈上來。
於是我把檢索單獨拉出來量。20 題裡有 15 題有標準出處,我用兩種查詢各跑一次:一種是主管改寫過的問題(「查詢上週收到、已開封的咖啡豆是否可以退貨」),一種是客人的原句(「上禮拜收到的豆子已經開了,還可以退嗎?」)。看正確條目有沒有排進前幾名:
| 查詢用的句子 | 排第 1 | 進前 3 | 進前 4 | 進前 8 |
|---|---|---|---|---|
| 改寫後的問題 | 7/15 | 9/15 | 9/15 | 11/15 |
| 客人原句 | 4/15 | 6/15 | 7/15 | 8/15 |
Top K 設 4,代表有六題的正確答案根本沒進到模型眼前。失敗的那三題排名分別是第 13、第 11、第 5 名。
幾個排名特別難看的例子:「運費怎麼算?滿多少免運?」的正確條目排第 20 名,也就是最後一名;「我朋友買就免運,為什麼我沒有」也是第 20 名。這兩句都是口語,混了情緒和無關的字,但人一看就知道在問免運規則。
這裡用的是 nomic-embed-text。它的訓練資料以英文為主,中文的語意距離算得不準,口語的中文更糟。客人原句的命中率比改寫後的問題更低,這也是為什麼主管要先把信整理成 clean_question 再派工。
把 embedding 換成 bge-m3,重新索引,其他什麼都沒改。
| 查詢用的句子 | 進前 4(nomic) | 進前 4(bge-m3) |
|---|---|---|
| 改寫後的問題 | 9/15 | 15/15 |
| 客人原句 | 7/15 | 15/15 |
考卷成績從 17 分變成 20 分。原本失敗的三題全部答對,而且 FAQ 沒寫的 5 題還是維持 not_found,沒有因為檢索變準就開始亂答。
| 設定 | 分數 | 模型呼叫 | tokens 中位數 | 時間中位數 |
|---|---|---|---|---|
| nomic-embed-text | 17/20 | 3 次 | 2677 | 2.6 秒 |
| bge-m3 | 20/20 | 3 次 | 2665 | 2.6 秒 |
模型呼叫的 3 次是 2 次 LLM 加 1 次 embedding。bge-m3 的模型比 nomic 大,但在這個量級下,整體速度和 token 幾乎沒差別,embedding 那次呼叫在我的筆電上大約 0.6 秒。
既然整份 FAQ 只有 1475 個字,那不如全部塞進 system prompt,不要檢索了。
我把 faq_search 工具和 Embeddings 節點拿掉,prompt 的工作流程第 1 步從「呼叫 faq_search」改成「逐條閱讀下方 FAQ」,後面直接貼完整的 20 條。其他一字不改。
| 設定 | 分數 | 模型呼叫 | tokens 中位數 | 時間中位數 |
|---|---|---|---|---|
| bge-m3 檢索 | 20/20 | 3 次 | 2665 | 2.6 秒 |
| 整份 FAQ 放進 prompt | 20/20 | 1 次 | 2001 | 1.3 秒 |
一樣的分數,少一次 LLM 呼叫、少一次 embedding 呼叫,token 少四分之一,時間快一倍。20 題跑完總共 40231 tokens,檢索版是 57603。
而且 FAQ 沒寫的那 5 題,整份放進去之後還是 5 題全對。我原本猜看得到越多內容越容易亂答,這次沒有發生。
兩種做法的差別整理成下圖。
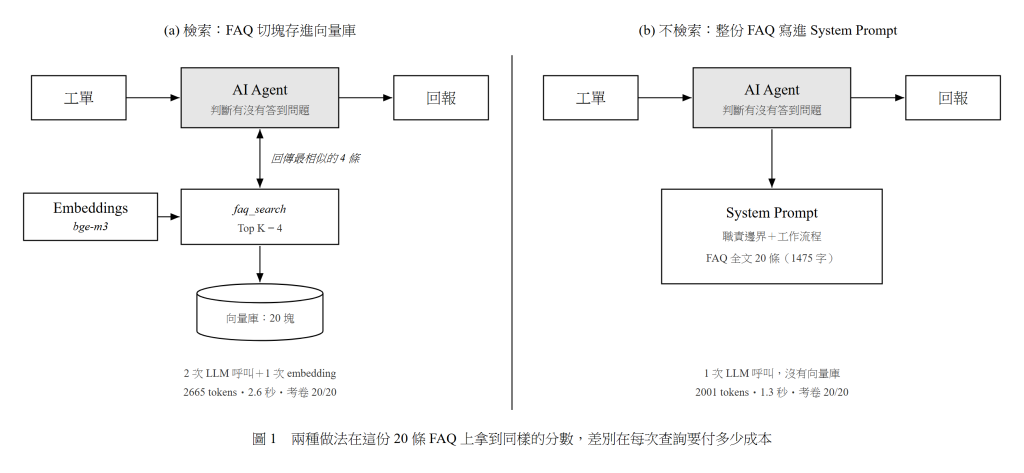
寫這篇之前我的預設是「知識類的專員當然要接向量庫」,實測之後得改口。
檢索要付的成本是固定的:多一次 embedding 呼叫、多一套要維護的索引、n8n 重啟就要重灌,還多了一個會悄悄壞掉的環節(撈錯條目不會報錯,只會答不出來)。換來的好處是不用每次都重送整份知識庫。
這筆帳在 20 條 FAQ 的時候完全划不來。要划得來,知識庫得大到塞不進 context,或是每次重送的代價開始讓人心疼。我的 Ollama 節點 Context Length 設 16384,整份 FAQ 現在佔的位置不到十分之一,照同樣的密度換算,大概要長到 250 條左右才會開始擠。
我後面還是會用檢索版繼續做,因為這個系列要示範的是可以長大的架構,而且 Day 22 要測主管該傳多少 context 給專員,需要兩種做法都在手上。但如果是實際專案,20 條 FAQ 我會直接塞進 prompt。
順帶一提,這也是為什麼每位專員都要能單獨考試。換 embedding 模型、改成不檢索,都是一行設定的事,但如果沒有一份固定的考卷,換完之後只能憑感覺說「好像有變好」。
W2 第一版 17/20,三題失敗全都是「FAQ 有答案卻回 not_found」。追下去發現模型判斷沒錯,是 nomic-embed-text 的中文檢索把正確條目排到第 5 到 13 名,根本沒進 Top 4。換成 bge-m3 之後 20/20。另外實測不做檢索、整份 FAQ 塞進 prompt,同樣 20 分而且更快更省。
明天做第三位專員 W3,它不查任何資料,只負責把事實寫成一封客人看得懂的回信。它的失敗方式跟前兩位完全不同。


 iThome鐵人賽
 看影片追技術