

前 11 天看的是一段訊號算不算得出、準不準。進入 Phase 2,要把好幾種指標排成一天一列,但夜間 HRV、睡眠、白天步數各自從不同時段算出來,日期相同不代表量的是同一段時間。所以今天要確認時區、跨日睡眠與資料延遲各要怎麼處理,並比較日值、3 日與 7 日視窗。
預期產出三樣:每人每天一列的 daily record 規則、同一段資料用不同視窗算法的對照表,以及並列日值、3 日與 7 日平均的 time series 圖。
這是一篇預估 3 小時的實驗,使用 LifeSnaps 公開資料集。
同一個時間戳,換個時區就可能落在前一天或後一天。有時區的資料,先保留原始時間,轉成參與者當時所在地的當地時間,再取日期;沒有時區的時間字串,要先查清原本是哪個時區,不能直接當成 UTC(pandas 也把這兩件事分成 tz_localize 與 tz_convert)。只有日期、沒有時間的資料,就沿用來源的日期定義,不自己換算。當地的一天也不一定是 24 小時:日光節約時間(DST)切換那天是 23 或 25 小時,秋天撥回的那一小時在沒有時區的字串裡會出現兩次。
睡眠還有另一個邊界:假設 9 月 22 日 23:30 入睡、9 月 23 日 07:00 醒來,若依入睡日歸屬,睡眠會和 22 日白天活動排在一起;若想解釋 23 日醒來後的狀態,我暫定把這段主睡眠歸到醒來的當地日期,再與同日期的日間指標合併。這剛好也是 Fitbit Web API 的慣例:睡眠紀錄的 dateOfSleep 是「睡眠結束的日期」,HRV 也只算當天最長的主睡眠,通常反映前一晚開始的那段。午睡與多段睡眠也不能默默併成一晚。
resample 之前先確認每欄的時間窗daily record 以「參與者 × 當地日期」為鍵,但同一列的欄位未必量自同一段 24 小時:步數可以是當地一天的累計,睡眠來自跨夜的主睡眠,nightly HRV 可能只來自睡眠期間,RHR 也未必是夜間值(Day 5 查過,各裝置的定義並不一致)。同一列只表示我們把它們放在同一個解讀日,不代表同時量到。resample 能按時間分箱,但聚合方式要依欄位選:步數用加總,已經是日值的 HRV/RHR 保留來源口徑,不能有多筆就一律再平均。同一個鍵出現多筆時(例如重複同步、同一天有兩段長睡眠),要先寫明取哪一筆、為什麼。
每一欄都要查得到用哪個日期、涵蓋哪段時間、怎麼聚合。資料晚到的話,也要記下它什麼時候才拿得到,否則回頭重算時會用到當時還沒有的數字。
rolling 要說清楚視窗和缺值日值看得出當天發生什麼,也最容易被單日波動帶著走。3 日、7 日視窗能看較慢的變化,但平滑後的曲線只是摘要,不是生理上的「真實趨勢」。本篇比較含當日、只看過去的 3 與 7 個日曆日:先補齊每天的日期、保留缺日,再算視窗。直接在現有資料列上做 rolling(3),中間少一天,三筆就不再是三天。pandas 的 rolling 有筆數與時間長度兩種視窗,min_periods 的預設也不同:筆數視窗等於視窗大小,時間長度視窗卻是 1,所以 rolling("3D") 只有一天資料也會輸出一個「3 日平均」。
因此每個視窗都要附有效天數。本篇以 3/7 天都有值才算平均,不足就留缺值,不把兩天的平均叫作「3 日趨勢」。代價是缺一天最多會讓涵蓋它的 3 個 3 日值、7 個 7 日值一起變成缺值。
「只看過去」也有代價:在逐日線性上升的序列上,含當日的 7 日平均等於 3 天前的值,3 日平均等於 1 天前的值;真實曲線晚多久要看形狀與缺值,驟變當天平均就會開始動,但要到第 7 天才完全跟上。7 日視窗剛好涵蓋一週每天各一次,3 日不會;步數若有週末效應,3 日值會不會跟著一週起伏,要實測才知道。圖上並列日值、兩種視窗與缺日,才看得出平滑抹掉了哪些單日變化。
本篇用的日粒度 CSV(daily_fitbit_sema_df_unprocessed.csv)只有一個 date 欄,屬於 Concept 說的「只有日期」;小時表則是當地 date 加上 0–23 的整數 hour。依原論文,作者已把時間換成參與者 Fitbit 個人檔案的當地時間,時區因隱私沒有公開;每人假設單一時區,約 3% 參與者期間內跨時區旅行,資料裡看不出來。釋出的 CSV 範圍比論文寬(2021-04-08~2022-01-22),兩輪之間仍有 59 人帶 Fitbit 數值,論文沒交代來源。本篇只保留論文的兩輪期間(2021-05-24~07-26、2021-11-15~2022-01-17),剩 4,909/7,410 列、71 人;睡眠 66 人、步數 68 人,與論文表 2 相同(D-050)。用四國的時區檢查,這兩段期間都沒有跨過 DST 切換日。
作者的前處理 notebook交代了各欄日期的來源:睡眠只取主睡眠、日期用 dateOfSleep;同一天多筆時依欄位聚合:睡眠、HRV、RHR 用 groupby(["id", "date"]).first(),步數同日加總。有 9 人在兩輪都有資料列,相隔 112–175 天,若不按輪分組,視窗會直接把兩輪接起來。日粒度表已經一天一列,本篇用不到 resample。
load_daily() 只留兩輪期間,加上 study_round 欄;date 保持沒有時區的當地日期,不做 tz_localize。row_present 記為 False。範圍不用整輪官方期間,是為了不把還沒開始戴的日子算成缺值。min_valid 等於視窗長度)、「至少 1 天」與「不補日、直接在 CSV 列上 rolling("3D")/rolling("7D")」三種算法計數。另外量一個陷阱:把某欄 dropna 後以筆數取連續 3 筆,這 3 筆實際跨幾個日曆日。rmssd 天數最多、而且中間至少缺一天的(參與者, 輪),並列日值、兩種視窗與缺日位置。視窗的核心只有兩行,重點在索引先驗過:
if not index.equals(pd.date_range(index[0], periods=len(index), freq="D")):
    raise ValueError("索引必須逐日連續、沒有重複且遞增")

mean = values.rolling(f"{window_days}D", min_periods=required).mean()
n_valid = values.rolling(f"{window_days}D").count().astype(int)
min_periods 數的是有值的天數:設 1,就和 pandas 預設一樣;設 7,才是「7 天都有值」。先檢查索引逐日連續,是為了讓缺的那天也有一列,下游才看得到「這天的 7 日值是缺的」;沒補日就算,平均一樣,但那一天根本不會出現。
| 原本以為 | 實際發現 |
|---|---|
| 以為今天得先把 LifeSnaps 的 UTC 時間戳換成參與者當地日期。 | 作者已換成當地時間,時區不公開。這份資料不需要、也無法重算,日期鍵只能沿用作者的當地日期。 |
| 以為把主睡眠歸到醒來日,是這次自己訂的對齊規則。 | Fitbit 的 dateOfSleep 本來就是醒來日,CSV 沿用。rmssd 與睡眠同日 99.6%,前後平移一天約 90%;resting_hr 同日只有 81.5%,不跟著睡眠走。 |
| 以為拿到日粒度資料後,還能自己決定同一天多筆紀錄要留哪筆。 | 作者已用 first() 聚合:逐欄取第一個非缺值,結果看資料庫回傳的順序,不一定是原本的同一筆。小時表仍有 57 組重複。 |
| 以為缺值主要是整天沒有資料列,補齊日期軸就能看清楚。 | 補日期軸只補出 49 天,全在 2 位沒有任何 Fitbit 數值的人身上。缺值幾乎都是「列在、值空」:28 人整段沒有 rmssd,有 rmssd 的人合計也只有 67.7% 的日子有值。 |
以為先 dropna 再取連續 3 筆,仍可以叫作最近 3 天。 |
rmssd 的連續 3 筆有 18.6% 跨了超過 3 天,最長 32 天;睡眠 17.0%、步數 5.3%。 |
以為 rolling("7D") 既然按日期切,就會等滿 7 天有值才輸出。 |
預設 min_periods=1。rmssd 的 7 日值 pandas 給出 2,423 個,7 天都有值的只有 1,060 個(43.7%)。 |
| 以為把視窗拉到 7 日只是讓曲線更平滑,可用的平均值不會少太多。 | 要求完整時,rmssd 的 7 日值只剩日值的 53.7%,3 日值 77.7%;缺一天最多讓 7 個 7 日值一起消失。 |
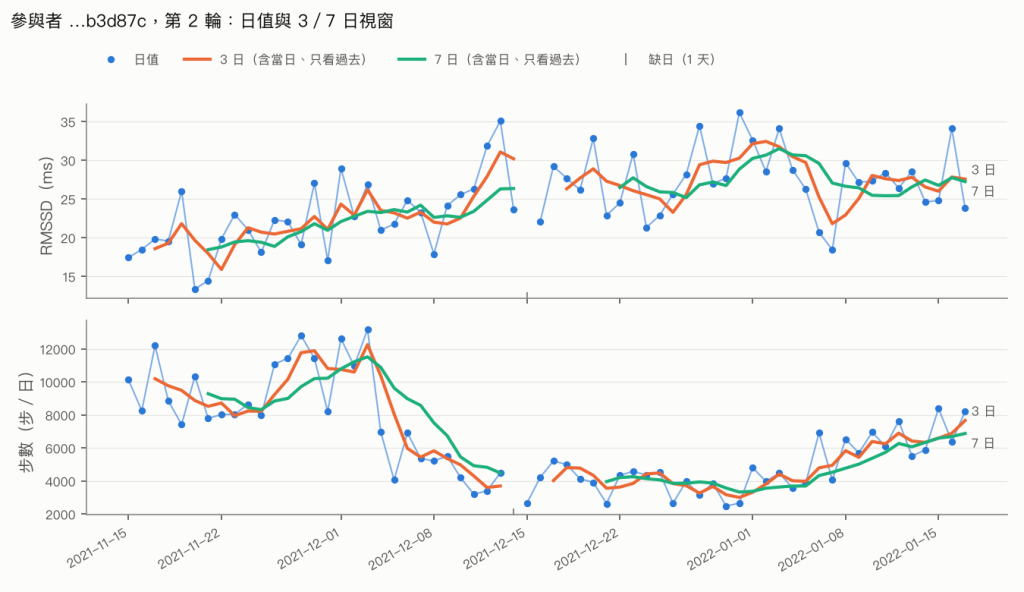
參與者 …b3d87c 第 2 輪的 rmssd(上,ms)與步數(下,步/日)。點是日值,橘線與綠線是含當日、只看過去的 3 日與 7 日平均,視窗內每天都有值才畫;底部短刻度是缺日
這位參與者第 2 輪有 64 天,兩個面板各缺 1 天,但不是同一天:rmssd 缺 12-15(那天的睡眠只記到 52 分鐘),步數缺 12-14。
同一段資料換一種算法,數字就不同。參與者 …55b564 在 2021-07-04 有列,但睡眠與 rmssd 是空的;07-05 的「3 日 rmssd」依算法不同:
| 算法 | 07-05 的值(ms) | 實際用到 |
|---|---|---|
| 完整才算 | — | 3 天只有 2 天有值 |
| 至少 1 天 | 108.912 | 07-03、07-05 |
dropna 後 rolling(3) |
103.392 | 07-02、07-03、07-05,跨 4 天 |
rmssd 或步數何時轉折、平滑後實際晚多久,這次沒有量。「7 日平均 HRV」這幾個字不夠當 LLM 的輸入。pandas 預設算出的 7 日 rmssd 有 2,423 個,其中 1,363 個的視窗內只有 1–6 天有值;只交出這一欄,模型拿到的「一週趨勢」有一半以上不是一週。視窗值要和它的定義一起走:視窗長度、含不含當日、有效天數、日期怎麼掛(睡眠、HRV 掛醒來日,步數掛當地量測日)。
缺值的形狀也要交代。這份資料裡,有沒有一列幾乎說明不了那天有沒有量到。Day 13 算缺值比例時,分母用全部日曆日(4,958)會把 28 位整段沒有 HRV 的人算進來,只算有 rmssd 的(參與者, 輪)則是 2,918。Day 19 的 feature contract 裡,每個聚合欄位至少要附有效天數,讓下游分得出「平均 45 ms,7/7 天」和「平均 45 ms,1/7 天」。


 iThome鐵人賽
 看影片追技術