
下游變慢時,多試幾次,會不會比較容易成功?這個想法很直覺。不過,如果每一層都在重試,下游收到的請求反而可能更多。所以,我想把限流、逾時、重試與冪等放在一起看。
Timeout 讓請求不要一直等,重試用來處理暫時性問題,限流則控制資源使用。每一項都有用途,但放在同一條呼叫流程裡,我還要確認它們不會互相放大。
可以先用一個簡單的例子來想:如果三個呼叫層各允許最多 3 次嘗試,一筆請求就可能讓最下游收到 3 × 3 × 3,也就是 27 次呼叫。下游原本已經很忙,這些額外工作可能讓它更難恢復。
所以,我會先把整條呼叫路徑畫出來,再逐層把 timeout 與重試次數定下來。
先知道使用者最多能等多久,各層才有 timeout 的分配依據。每次嘗試、等待回應與重試間隔,都要算進去,避免上游的 timeout 已經到期、錯誤也回給使用者了,下游卻還在重做,繼續占用資源。因此,我會依下面的順序安排:
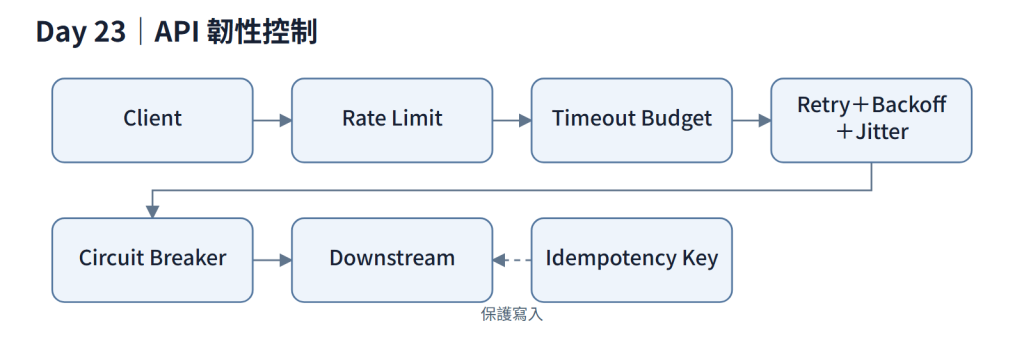
圖 Day 23-1:API 韌性控制。
重試放在哪裡,我會看哪一層知道這個操作能不能安全重做。Gateway 對業務狀態了解比較少,寫入型請求尤其要謹慎。所以我把重試放在 Adapter:查詢類的操作在這裡重送,另外,建立訂單這種非冪等的寫入不重試,要不要再送由呼叫端決定。
限流的額度可依 client、使用者或 API 分別設定。如果沒有 Retry-After,呼叫端只能自行猜測間隔,而通常都會猜得太短,所以超限時我會回傳 429 並附上 Retry-After,告訴呼叫端還要等幾秒。這也反過來限制了限流怎麼實作:算不出重置時間的做法,回的秒數也只是猜的。
逾時只代表沒收到結果,下游可能已經做完了。所以每次要開啟自動重試,我都會先確認同一筆請求送兩次,下游會不會就多出一筆。查詢這類操作,我可以照契約判斷重送安不安全;建立訂單如果還沒有冪等保護的話,就先不要自動重送。
這些判斷最後會整理成一份共用的 Resilience4j 設定,各服務用 base-config 接上,只覆寫自己要改的值。下面是整理自目前設定檔的簡化版:
resilience4j:
  timelimiter:
    instances:
      erp-soap:
        timeout-duration: 10s          # 共用預設;Adapter 另以自己的實例覆寫成 20s(此處簡化未列出)
  retry:
    configs:
      default:
        max-attempts: 3                # 1 次原始呼叫 + 2 次重試
        wait-duration: 500ms
        enable-exponential-backoff: true
        exponential-backoff-multiplier: 2
        exponential-max-wait-duration: 8s
        enable-randomized-wait: true   # jitter:等待時間 ±50%
        randomized-wait-factor: 0.5
        retry-exceptions:              # 只重試這三類:連不上、斷線、等不到
          - java.io.IOException
          - java.util.concurrent.TimeoutException
          - org.springframework.web.client.ResourceAccessException
        ignore-exceptions:             # 業務錯誤重送 100 次也不會變對
          - com.example.common.exception.BusinessException
    instances:
      erp-soap:
        base-config: default
  circuitbreaker:
    configs:
      default:
        sliding-window-type: COUNT_BASED
        sliding-window-size: 10
        failure-rate-threshold: 50
        wait-duration-in-open-state: 30s
        permitted-number-of-calls-in-half-open-state: 3
        automatic-transition-from-open-to-half-open-enabled: true
        register-health-indicator: true   # 讓 circuit state 出現在 health endpoint;metrics 由 micrometer 自動註冊
    instances:
      erp-soap:
        base-config: default
整份設定我最在意的是 retry-exceptions 與 ignore-exceptions 這兩組:逾時與連線失敗才重送,ERP 回業務錯誤時就直接回失敗。
一批格式錯誤的請求如果也算進失敗率,就會讓 circuit breaker 跳成 open,而 open 是全部擋下,連原本會成功的請求也一起被擋。所以共用設定就把業務錯誤排除在失敗率之外,各服務只在需要更嚴格時才覆寫。
retry 區塊裡 enable-randomized-wait 與 randomized-wait-factor 這兩行的 jitter,是把每次退避算出來的等待時間,再隨機加減 50%。加減之後,exponential-max-wait-duration 再設一個上限,所以重試次數再多,單次等待也不會超過 8 秒。這樣一批同時逾時的呼叫,不會在同一毫秒一起重送;下游剛恢復時,這些呼叫也不會同時送達。
流量變多時,我要能分辨這是真的流量變多,還是重試在放大;看到逾時,也要查出是哪一層先觸發的。
所以每次重試、每次逾時、circuit breaker 每次換狀態,都用固定的事件名寫進結構化 log,欄位帶重試次數、等待毫秒、是哪個逾時預算觸發。冪等鍵擋下重複請求時,也記錄一筆。
Circuit breaker 如果每次剛要恢復就又失敗,我會回頭查下游為什麼還沒穩定,也會確認 half-open 只放行 3 筆是不是太少,而不是只看到部分請求成功就認為已經恢復。3 筆裡只要有 2 筆成功,就會回到 closed。所以 half-open 狀態的每次進出也要留下紀錄。
| 取捨 | 這樣選的理由 | 何時要重新評估 |
|---|---|---|
| 端對端 budget 優先於各層自訂 | 避免各層加總超過上游等待時間 | 業務可接受等待時間變更時 |
| 只在單一層重試 | 避免重試次數逐層相乘 | 該層無法判斷操作安全性時 |
| 非冪等寫入不自動重試 | 重複副作用的代價高於失敗 | 已建立 idempotency key 機制後 |
| 限流回應附 Retry-After | 呼叫端不需猜測間隔 | 限流改用算不出重置時間的做法時 |
Timeout 太短可能誤判,太長又會占用資源。我會先量實際的延遲分佈,例如 P99,再在業務可接受的等待時間之內留下緩衝。限流門檻也用正常流量與容量測試訂出來,之後再依結果調整。
這些設定在正常流程下不一定看得出效果,我會主動讓這些故障發生,實際確認:
| 故障情境 | 想確認什麼 |
|---|---|
| 下游慢回應 | timeout 是否在預期時間觸發?上游是否連鎖逾時? |
| 連線被拒 | 這次呼叫是否立刻失敗,或仍耗到 timeout? |
| 部分成功 | 下游已經做完但回應沒送回來時,狀態是否明確? |
| 重複請求 | idempotency key 是否擋下重複副作用? |
| 下游持續失效 | circuit breaker 是否跳成 open?恢復後是否自動回到 closed? |
驗證時,如果下游多收到呼叫,我要能拿它跟原本允許的重試次數與時間預算對照,確認多出來的呼叫都在設計範圍內。所以下游實際收到的次數,也要一起記下來。
今天整理下來,設定要彼此配合,異常時又要有紀錄,才知道它們是不是照預期運作。所以我覺得保護機制也需要一起練習。下一篇,再看看 Logs、Metrics 與 Traces 怎麼幫我們追查。


 iThome鐵人賽
 看影片追技術