
收到系統異常的通知時,我會想先知道三件事:發生什麼事、影響有多大,以及卡在哪裡。Logs、Metrics、Traces 各自能回答一部分,把它們串連起來,才比較容易把事情看完整。
有時候,三種資料都有留存,但是查問題卻還是要分開找。告警上顯示錯誤率上升,但是找不到是哪筆請求;在 Log 上看到了,又不知道它經過哪些服務。其實資料都在,缺的是彼此能對照的方式。
| 訊號 | 適合回答 |
|---|---|
| Logs | 發生了什麼事件?錯誤內容為何? |
| Metrics | 錯誤是否增加?延遲是否惡化? |
| Traces | 哪一段服務造成整體延遲或失敗? |
所以,我會先確認識別碼有沒有串接好,讓同一段流程留下的紀錄能找得到彼此。
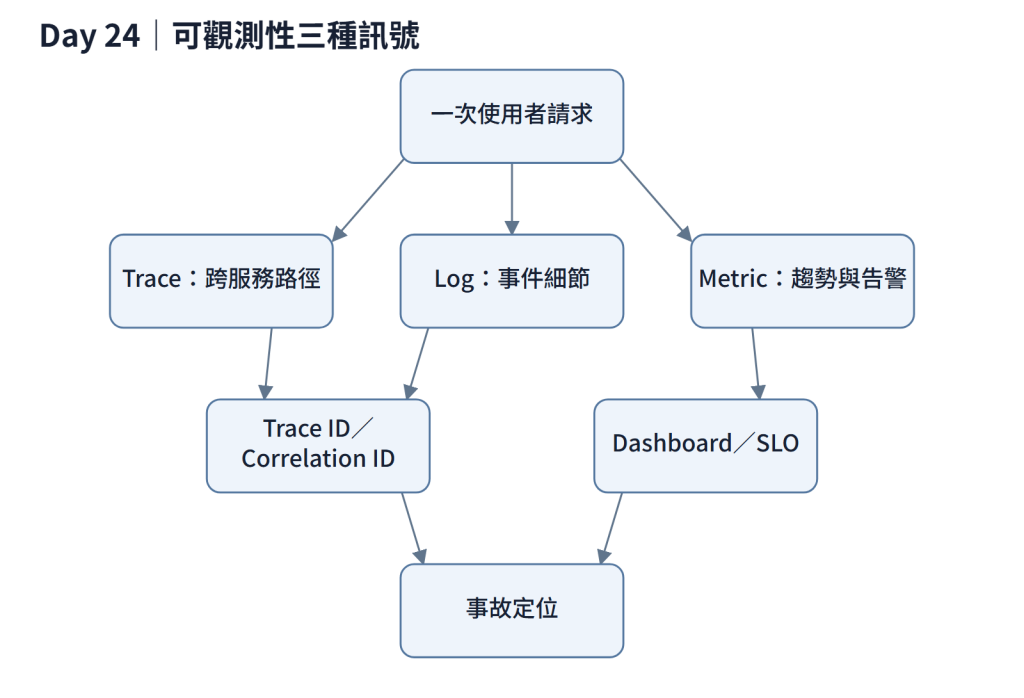
圖 Day 24-1:可觀測性三種訊號。
圖中先用 Trace ID 與 Correlation ID 連接 Log 和 Trace,再透過 Dashboard 與 SLO 找到需要查看的時間與條件。我希望收到告警後,能順著這條路找到事件細節。
這兩個 ID,也要先說明各自的用途。Trace ID 用來追蹤技術呼叫鏈;Correlation ID 可以對應一段業務操作,跨越不同 Trace。遇到非同步流程時,尤其要確認後續事件還接得回原本的操作。
因此,事件裡會保留 correlationId,Consumer 處理時再把它和自己的 Trace 關聯起來。Day 17 留下的事件欄位,就在這裡派上用場。
實作上,各服務容器都掛著 OpenTelemetry Java agent,由它產生與傳遞 trace context,程式碼不用自己處理。結構化 Log 再把 timestamp、service、environment、level、traceId、spanId、correlationId、event name 與結果定義好,查詢時比較有一致的欄位。
為了避免不同環境的紀錄混在一起,log 裡多了 environment 欄位;correlationId 從請求標頭接進來,格式不對就換成自己產生的,不讓外面的字串直接進 log。之後統計同一種事件時,不用猜大家用了哪些不同描述,所以 event name 也用固定名稱。
Token、密碼、完整個資與 ERP 敏感 payload,都不要寫進 Log。一旦寫下來,資料可能還會進入儲存、備份與其他系統,之後才過濾就太晚了,所以遮罩做在 log 編碼那一層:Bearer token、密碼類的 key=value、身分證字號寫進去前就換成星號。手機號碼的格式和品號、單號重疊,遮了對帳 log 就沒法用,所以 email、手機與單號都刻意不遮。
入口 API 應蒐集 request rate、error rate 與 duration;主機、容器需觀察資源飽和程度;Kafka 與 RabbitMQ 則監控 lag、queue depth 與 DLQ 深度。每類指標都要有明確用途與告警依據——沒有對應處理動作的指標可以收集,但不應設成告警。
| 取捨 | 這樣選的理由 | 何時要重新評估 |
|---|---|---|
| 採樣先用比例,錯誤與高延遲優先保留列為下一步 | 完整保留成本高,但異常樣本最有價值 | 採樣導致無法重建問題時 |
| 遮罩在產生端處理 | 寫入後再過濾已經來不及 | 無 |
| Correlation ID 要貫穿非同步邊界 | 業務操作的追蹤不應在事件處斷掉 | 無 |
| 只為可處理的指標設告警 | 無動作的告警會讓人忽略所有告警 | 無 |
流量越大,Trace 與 Log 要寫入和保存的資料越多,成本也越高;正常請求的紀錄多半大同小異,所以可以採樣。但罕見的重要問題可能剛好沒被取樣到,錯誤與高延遲請求應該必定保留。只是目前在請求一開始就決定留不留,還看不到結果,所以表格把它列為下一步。
| 驗證項目 | 做法 | 想確認什麼 |
|---|---|---|
| 跨層串聯 | 選一筆交易,以同一 traceId 查 Gateway、服務與 Adapter | 追蹤是否在某一層斷掉? |
| 非同步串聯 | 追一筆含事件處理的流程 | correlationId 是否跨過事件邊界? |
| 遮罩有效 | 檢查 Log 是否含 Token、密碼或個資 | 敏感資訊是否確實未寫入? |
| 查閱權限 | 以不同角色查詢觀測平台 | 紀錄的存取是否受控? |
| 告警可行動 | 逐一檢視現有告警 | 每個告警是否都有對應處理動作? |
我會準備一筆測試交易,從 Gateway 走到服務與 Adapter,確認紀錄能用 traceId 串起來,也檢查遮罩與查閱權限。哪一層斷了,就先補那一層的 context 傳遞。
今天想確認的,是從一個告警出發,能不能找到整段請求與事件細節。下一篇,再把這些訊號接到 Prometheus、Grafana 與 Jaeger,看看畫面和告警怎麼幫助處理問題。


 iThome鐵人賽
 看影片追技術