

前幾天 AI Reliability Lab 一直在處理「模型的結果到底能不能信」。
Day 9,我第一次跑完整的 REAL calibration benchmark,得到 12 筆真實模型資料。
Day 10,我又回頭檢查自己的統計結果,發現只有 12 筆資料時,Brier Score 和 ECE 都還有很大的 sampling uncertainty。
Day 11,問題甚至從模型本身跑到了實驗系統:一次網路中斷,讓原本跑到第 37 次 request 的實驗無法原地繼續。最後我替 runner 加上 checkpoint 與 resume,真的測出「先跑 5 個、再跑剩下 7 個」,總 API attempts 仍然只有 12,而不是重新變成 17。
做到這裡,我以為「可重現的 REAL Experiment」已經有個樣子了。
但接著我想到另一個問題:
如果半年後我重新下載這份實驗資料,我怎麼知道這些 JSON 還是當初那一份?
假設有人不小心手動修改了 records.jsonl 裡的一個答案。
或者 summary.json 寫著 Accuracy 是 83.33%,但實際從 records 重算卻不是 83.33%。
甚至 metadata 說有 12 筆資料,但 records 實際只剩 11 筆。
如果這些問題都無法被自動發現,那我現在做的「reproducibility」其實還少了一塊。
所以 Day 12 我沒有呼叫任何新的模型。
今天做的是一個完全 offline 的能力:
讓已經發布的 REAL Experiment artifacts 可以被重新驗證。
目前一個完整 REAL run 通常會留下幾種檔案。
例如 Day 9 有:
metadata.json
records.jsonl
calibration.json
summary.json
這些檔案分別描述實驗設定、逐題結果,以及後續計算出的 calibration metrics。
光是留下它們,確實比只在 terminal 裡印結果好很多。
但「檔案存在」和「檔案彼此一致」是兩件不同的事情。
所以 Day 12 我加入了一個新的 manifest.json。
Manifest 不負責保存模型回答本身,而是描述:
換句話說,manifest 比較像是一張「這次公開實驗應該長什麼樣子」的清單。
Verifier 之後就可以反過來檢查:
現在硬碟裡的東西,還是不是 manifest 當初描述的那一份。
Day 12 最直接的一層驗證,是 SHA-256。
每一個被納入 integrity protection 的 artifact 都會計算 SHA-256,然後寫進 manifest。
之後重新驗證時,再對現有檔案計算一次。
如果完全一致,就代表目前這個檔案內容和建立 manifest 時相同。
如果只改一個字元,hash 理論上就會不同。
但這裡一定要避免一個很容易出現的誤解:
SHA-256 可以驗證 consistency,但不能驗證 truth。
假設我一開始就建立了一份假的 records.jsonl,然後替它產生正確 hash,那 verifier 一樣可以 PASS。
所以 hash 能告訴我的只是:
這份檔案從 manifest 建立後有沒有發生變化。
它不能證明 OpenAI 當時真的回過這些答案,也不能證明 benchmark 本身公平。
這個界線在 Day 12 很重要。
如果 verifier 只負責比 SHA-256,那其實有點可惜。
因為一組檔案就算完全沒有被修改,也可能一開始彼此就不一致。
所以 Day 12 的 verifier 還會檢查:
最後這一項對我最重要。
因為 Day 9 的 summary.json 裡雖然已經寫著 Accuracy、Brier Score 和 ECE,但 verifier 不會只相信它。
它會重新讀取 records.jsonl,使用既有 evaluator 再算一次。
然後比較:
stored result 和 recomputed result 是否一致。
第一個正式驗證的對象,是 Day 9。
也就是之前那次 12-case REAL calibration benchmark。
Verifier 最後對 Day 9 執行了 11 項檢查。
結果:
PASS。
而且 calibration metrics 不是只檢查檔案 hash,而是真的重新計算。
重新計算結果如下:
| Metric | Self-reported | Agreement |
|---|---|---|
| Mean confidence | 0.9991667 | 0.9166667 |
| Brier Score | 0.1650083 | 0.0462963 |
| 5-bin ECE | 0.1658333 | 0.0833333 |
Accuracy 則重新得到:
0.8333333,也就是 10 / 12。
和 Day 9 原本保存的數值全部一致。
這次 verifier 使用的 numeric tolerance 是 1e-12,所有重新計算的結果都在 tolerance 內吻合。
這讓 Day 9 的結果多了一層意義。
以前我是:
summary.json說它是 0.1658333。
現在則變成:
我可以從公開的逐題 records 再算一次,而且確實得到 0.1658333。
兩者差很多。
第二個拿來驗證的是 Day 11。
但 Day 11 和 Day 9 的實驗目的不一樣。
Day 9 是 calibration benchmark。
Day 11 則是在測 resumable runner。
它真正重要的 evidence 是:
所以 verifier 不能看到 records.jsonl 就硬算一個 ECE,再假裝那是 Day 11 的重點。
Day 12 因此讓 verification 根據 run type 檢查適用的 derived information。
Day 11 同樣執行了 11 項 verification checks。
最後:
PASS。
Request accounting 重新確認:
| 項目 | 結果 |
|---|---|
| Planned logical requests | 12 |
| Unique completed | 12 |
| First-session attempts | 5 |
| Resume-session attempts | 7 |
| Total attempts | 12 |
| Duplicated logical requests | 0 |
也就是昨天最重要的 5 + 7 = 12,今天可以從已發布 artifacts 再驗證一次。
---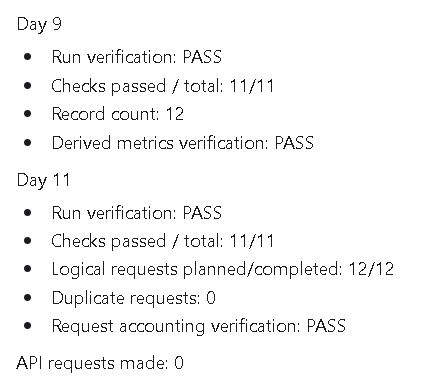
Day 12 的 offline verifier 實際重新檢查 Day 9 與 Day 11 兩個 canonical REAL runs。兩者皆通過 11 項檢查,而且整個 verification 過程不需要 API key,也沒有重新呼叫模型。
如果 verifier 永遠只拿正常資料測,很容易出現一個問題:
它到底是真的會抓錯,還是只會對正常資料顯示 PASS?
所以 Day 12 最後做了一個 controlled tamper demonstration。
我沒有碰真正的 Day 9 canonical data。
而是先建立 temporary copy。
接著只修改 temporary copy 裡的一個 answer。
再重新執行 verifier。
這次結果不是 PASS。
而是:
FAIL。
真正抓到問題的 check 是:
artifact_hashes
因為 records.jsonl 的內容已經和 manifest 中保存的 SHA-256 不一致。
驗證完成後,temporary copy 也被刪除,真正的 canonical REAL run 沒有受到影響。
這個測試讓 Day 12 從「我寫了一個 verifier」變成:
我真的故意破壞資料,而 verifier 有把它抓出來。
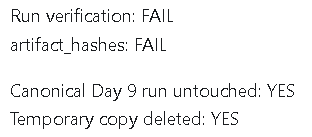
我在 temporary copy 中只修改一筆 answer,offline verifier 隨即回傳 FAIL,並由
artifact_hashes偵測到records.jsonl已與 manifest 不一致。Canonical REAL run 全程沒有被修改。
Day 12 新增 offline verifier 和 tamper tests 後,完整 test suite 從 Day 11 的 93 tests 增加到:
104 passed in 3.01s
測試包含:
records.jsonl 會 FAIL而今天整個 Day 12:
OpenAI API requests = 0。
也就是說,驗證一個已發布 REAL run 並不需要重新花模型成本,也不需要 API key。
這點對後面很重要。
因為公開資料只要還在,就能離線重驗。
做到這裡,我反而覺得最需要說清楚的是:
PASS 不代表什麼。
Day 9 verifier PASS,不代表 GPT-5.6 Luna 的 calibration 已經被證明。
Day 11 verifier PASS,也不代表 checkpoint system 在所有網路失敗情境下都能 exactly-once。
PASS 目前代表的是:
這份 public run 的 artifacts 通過目前定義的 integrity 與 internal-consistency checks。
也就是:
檔案存在、hash 一致、結構正確、run identity 對得上、數量合理,而且適用的 derived outputs 可以從 records 重算。
它沒有辦法證明:
甚至目前還有一個很直接的限制:
manifest 本身沒有數位簽章。
如果有人同時修改 records.jsonl,再重新建立一份完全匹配的新 manifest,單靠目前的 verifier 並不知道原本的 manifest 已經被替換。
所以現在做到的是 integrity checking,不是 cryptographic authorship。
這個限制我不打算藏掉。
做到 Day 12,我開始把這三個概念分得更開。
我是否留下足夠的:
讓分析可以重新進行?
我現在拿到的 public artifacts,是否仍然符合發布時 manifest 所記錄的內容?
不同檔案之間是否內部一致?
實驗設計是否足以支持我要宣稱的結論?
例如 Day 9 只有 12 題。
即使今天所有 11 項 verifier checks 都 PASS,也不會讓 12 題突然變成一個足以代表整個模型的 benchmark。
Day 10 的 bootstrap 已經顯示,這批資料的 sampling uncertainty 仍然很大。
所以:
Engineering integrity 不能取代 statistical validity。
但兩者都需要。
如果把這幾天串起來,目前一個 REAL experiment 已經不只是:
問題 → 模型 → 答案。
它逐漸變成:
Experiment configuration
→ REAL API requests
→ checkpoint
→ resume if interrupted
→ complete records
→ derived analysis
→ public artifacts
→ manifest
→ offline verification
如果 artifact 被改過:
→ verification FAIL
如果 metrics 和 records 對不上:
→ verification FAIL
如果是正常 canonical run:
→ verification PASS
這讓 AI Reliability Lab 開始從一組 evaluator,變成比較完整的 experiment system。
今天完成了一個完全 offline 的 REAL-run verifier。
目前:
artifact_hashes 抓到更重要的是,我現在不只保存實驗結果。
我也開始保存:
「為什麼現在看到的這份結果,仍然和當初發布的實驗一致」的證據。
但這還不是「證明結果是真理」。
它只是把 AI Reliability Lab 再往前推了一層:
不只要求模型接受驗證,連驗證模型的實驗資料,也應該接受驗證。


 iThome鐵人賽
 看影片追技術