

Day 9,我第一次在 REAL Experiment 裡抓到兩個很有意思的 failure case。
模型在 D9-009 答錯,卻給自己 1.00 的 confidence;D9-010 也答錯,但 self-reported confidence 仍然高達 0.99。
12 題跑完後,我得到:
| Signal | Mean Confidence | Brier Score | ECE |
|---|---|---|---|
| Self-reported | 0.9992 | 0.1650 | 0.1658 |
| Agreement | 0.9167 | 0.0463 | 0.0833 |
乍看之下,很容易得到一個誘人的結論:
Agreement confidence 好像比模型自己報的 confidence 更可靠。
但昨天我刻意沒有這樣寫。
原因很簡單:
我只有 12 筆資料。
12 筆資料可以讓我發現值得追的現象,但還遠遠不足以讓我宣稱某一種 confidence signal 比另一種好。
所以 Day 10 我沒有繼續打 API,也沒有急著增加功能。
今天反而回過頭來問一個比較不舒服、但更重要的問題:
昨天算出來的 ECE 和 Brier Score,到底有多穩?
ECE,全名 Expected Calibration Error,計算時需要先把 confidence 分成幾個區間。
例如把 0 ~ 1 切成 5 個 bins,大致會像:
每一個 bin 裡,再比較平均 confidence 與實際 accuracy 的差距,最後按照 bin 裡的樣本數加權。
問題就在這裡。
如果我把資料切成 5 bins 得到一個 ECE,那改成 3 bins 呢?
或者 10 bins?
在小資料集上,bin 的切法本身就可能改變最後結果。
所以 Day 10 第一個實驗非常單純:
同一批 Day 9 的 12 筆 REAL records,不重新呼叫模型,只改 ECE 的 bin 數。
我測了:
2、3、4、5、6 bins
結果是:
| Signal | 2 bins | 3 bins | 4 bins | 5 bins | 6 bins |
|---|---|---|---|---|---|
| Self-reported | 0.165833 | 0.165833 | 0.165833 | 0.165833 | 0.165833 |
| Agreement | 0.083333 | 0.083333 | 0.083333 | 0.083333 | 0.083333 |
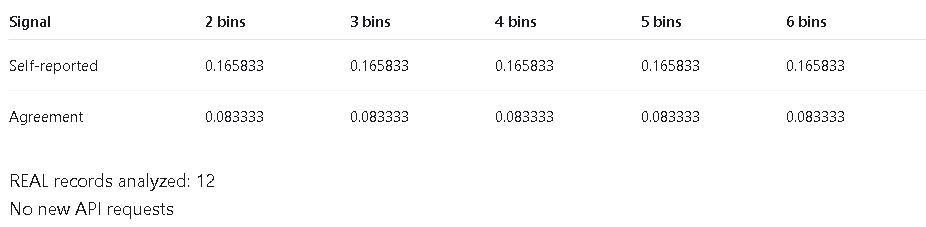
同一批 12 筆 REAL records 使用 2~6 個 bins 計算 ECE,本次資料得到完全相同的結果;這主要與 confidence 高度集中、取值離散有關,不能解讀成 ECE 一般而言不受 binning 影響。
結果比我預期還整齊。
完全沒變。
看到這張表,很容易產生另一個錯覺:
既然 2~6 bins 都一樣,那這個 ECE 應該很可靠吧?
其實不是。
這次 ECE 對 bin 數不敏感,主要和資料本身的分布有關。
Self-reported confidence 幾乎全部集中在 1.0,只有一筆是 0.99。
所以不管切成 2 bins、3 bins 還是 6 bins,這些資料幾乎都還是會被放在最上面的 confidence 區間。
換句話說,改變 bin 數並沒有真的重新切開這批資料。
Agreement confidence 則主要只有三種值:
1.0、0.6667、0.3333
其中十筆答對的 case 都是 1.0,兩筆錯誤則分別是 0.6667 與 0.3333。
就算這兩筆錯誤被放進同一個 bin,或者被拆到不同 bin,在目前這個非常特殊的小資料集裡,加權後仍然會得到相同的總 calibration error。
所以今天第一個結果其實不是:
ECE 很穩。
而是:
這 12 筆資料的 confidence 分布太離散,目前 2~6 bins 剛好都得到相同結果。
這兩件事情差很多。
如果改 bins 沒看到變化,我接著換另一個方向。
這次不用改 metric,而是改「抽到哪些資料」。
我使用 Bootstrap。
Bootstrap 的概念其實不複雜。
目前我有 12 筆 REAL records。
每一次 bootstrap 都從這 12 筆資料裡,有放回地抽 12 筆。
「有放回」代表同一筆資料可以被抽到兩次,也可能完全沒被抽到。
例如原始資料是:
A、B、C、D
一次 bootstrap sample 可能變成:
A、A、C、D
另一次則可能:
B、C、C、C
Day 10 一共做了 1000 次 bootstrap,而且固定 random seed,確保結果可以重現。
每一次都重新計算:
最後觀察這 1000 次重新抽樣後,metric 會散成什麼樣子。
結果如下:
| Signal | Original | Bootstrap Mean | 2.5% | 97.5% |
|---|---|---|---|---|
| Self-reported | 0.165008 | 0.162303 | 0.000000 | 0.413350 |
| Agreement | 0.046296 | 0.045824 | 0.000000 | 0.129630 |
原始資料裡,Self-reported 的 Brier Score 是 0.1650。
但是重新抽樣之後,95% bootstrap percentile interval 大約從:
0.0000 ~ 0.4134
Agreement 則是:
0.0000 ~ 0.1296
這個範圍非常寬。
特別值得注意的是:
兩個 interval 的下限都是 0。
這不是代表模型真的可能完美 calibrated。
而是因為目前只有兩筆錯誤 case。
Bootstrap 的某些 resample 剛好可能完全沒有抽到那兩筆錯誤,或者大量重複抽到答對而且 confidence = 1.0 的資料。
這種 sample 算出來的 Brier Score 自然可能接近 0。
這件事反而很直接地暴露了目前資料量的問題。
只有 12 筆時,少數幾筆 failure case 對最後 metric 的影響非常大。
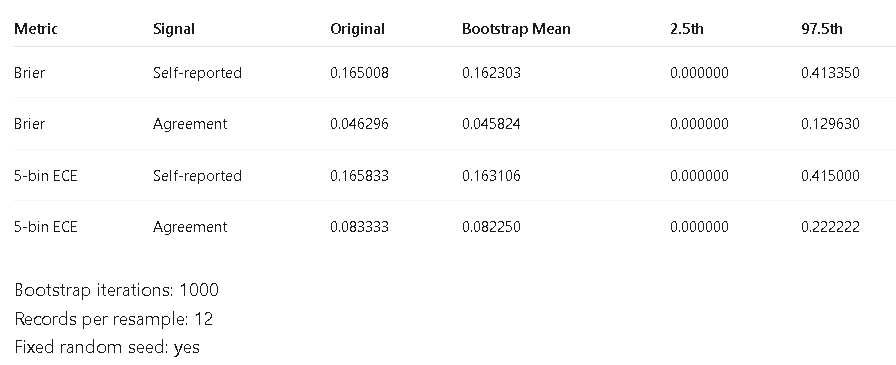
1000 次 bootstrap resampling 的結果。雖然原始 run 中 Agreement 的 Brier 與 ECE 較低,但兩種 signal 的 bootstrap interval 都相當寬,反映目前 12 筆資料仍具有很大的 sampling uncertainty。
再看 5-bin ECE:
| Signal | Original | Bootstrap Mean | 2.5% | 97.5% |
|---|---|---|---|---|
| Self-reported | 0.165833 | 0.163106 | 0.000000 | 0.415000 |
| Agreement | 0.083333 | 0.082250 | 0.000000 | 0.222222 |
Self-reported ECE 的 bootstrap interval 大約是:
0 ~ 0.415
Agreement 則是:
0 ~ 0.2222
昨天如果只看原始值:
Self = 0.1658
Agreement = 0.0833
差距看起來很明顯。
但 Day 10 把資料重新抽樣後,我看到的是:
這兩個 metric 都還有很大的 sampling uncertainty。
也就是說,目前這 12 筆資料確實觀察到 Agreement 的 ECE 比較低,但這個差異還不能被當成穩定、普遍的效果。
做到這裡,我也更清楚兩個 metric 的差異。
Brier Score 可以簡單理解成:
(confidence - outcome)^2 的平均。
其中答對是 1,答錯是 0。
所以如果模型答錯,confidence 卻是 1.0,那一題的 penalty 就會非常大。
它不需要先切 bins,每一筆資料都直接參與計算。
ECE 則不一樣。
ECE 先把資料分組,再比較每一組的平均 confidence 和平均 accuracy。
因此它除了受到 sample size 影響,也會受到:
影響。
這也是為什麼 calibration evaluation 通常不應該只報一個 ECE,然後把那個數字當成完整答案。
Day 9 的資料乍看之下很漂亮:
Agreement 的 Brier 和 ECE 都比 Self-reported confidence 低。
Day 10 做完之後,我反而更不想急著下結論。
因為現在我知道:
這個差距是建立在只有 12 筆資料、其中只有 2 筆錯誤的條件下。
Bootstrap 讓這件事情變得非常直觀。
Self-reported ECE 原本是 0.1658,但 bootstrap percentile interval 可以一路從 0 到 0.415。
Agreement 的 ECE 原本是 0.0833,interval 也可以從 0 到 0.2222。
這代表目前真正合理的說法仍然只是:
在 Day 9 的這批 12-case exploratory benchmark 中,Agreement confidence 的 Brier Score 與 ECE 低於 Self-reported confidence;但在 bootstrap resampling 下,兩者都有相當大的不確定性,因此目前不能推廣成一般性結論。
這句話比:
Agreement 比 Self-confidence 好。
保守很多。
但也更接近我真正想做的 AI Reliability。
這裡還有一個很重要的限制。
我今天做了 1000 次 bootstrap,不代表突然有了 12000 筆新的實驗資料。
Bootstrap 只是一直重新排列、重新抽取原本那 12 筆 records。
它可以幫助我理解:
如果這 12 筆資料稍微換一個組合,metric 可能會變多少?
但它不能創造新的資訊。
原始 benchmark 沒看過的 failure mode,bootstrap 永遠不可能自己生出來。
如果模型在另一類 reasoning question 上有完全不同的行為,今天這 1000 次 bootstrap 也不會知道。
所以 Day 10 並不是用統計方法「修好」Day 9 的小樣本問題。
它只是讓我更清楚知道:
小樣本問題到底有多嚴重。
今天完全沒有新的 OpenAI API request。
Day 10 只讀取 Day 9 已經保存的 REAL experiment records,再做 derived analysis。
另外加入 sensitivity analysis 與 bootstrap 的單元測試後,目前完整 test suite 變成:
88 passed in 1.21s
今天產生的三份 derived report 分別是:
sensitivity.json
bootstrap.json
summary.json
原本 Day 9 的 REAL records 完全沒有修改。
這點我也刻意維持:
Raw experiment data 和後續 derived analysis 分開保存。
因為如果之後分析方法改變,我希望可以重新從原始 REAL records 計算,而不是把舊資料一起改掉。
回頭看這幾天的進展,我覺得 Day 10 是一個滿重要的轉折。
Day 7,我做了 calibration evaluator。
Day 8,我第一次真的取得 REAL confidence data。
Day 9,我第一次看到模型:
答錯,而且還非常有自信。
Day 10,我開始懷疑自己昨天算出來的漂亮 metric。
這其實滿符合這個專案現在想做的事情。
AI Reliability Lab 如果只是一直增加 metric,很容易最後變成一個「評分工具集合」。
但真正的 reliability engineering 不只是算出一個分數。
還要繼續問:
這個分數本身有多可靠?
目前的答案很明確:
12 筆資料可以幫我找到問題。
但還不夠讓我對模型做一般性的判斷。
下一步真正需要的,不是更多統計花招。
而是更多有設計過、能產生不同 failure mode 的 REAL data。


 iThome鐵人賽
 看影片追技術